
如何构建无语言模型:Logical Intelligence的实践
内容提要
大语言模型在数独等约束满足问题上表现不佳,因其从左到右逐词生成且输出离散,难以同时满足多重约束。Logical Intelligence提出能量基推理模型(EBRM),如Kona,用连续隐空间推理,通过能量函数评估候选答案并沿梯度下降搜索,模型仅数千万参数,速度快、成本低。EBRM适合规则明确、可验证的任务,语言模型则负责判断与表达,二者分工互补。
延伸解读
LLM在约束问题上的根本局限
文章指出,LLM从左到右逐词生成且输出离散,导致在数独等需同时满足多重约束的任务中表现不佳。一旦早期步骤出错,后续难以修正,且离散输出无法微调至正确。这解释了为何前沿LLM在数独测试中成功率极低,而小模型Kona却能高效解决。
能量基推理模型的工作原理
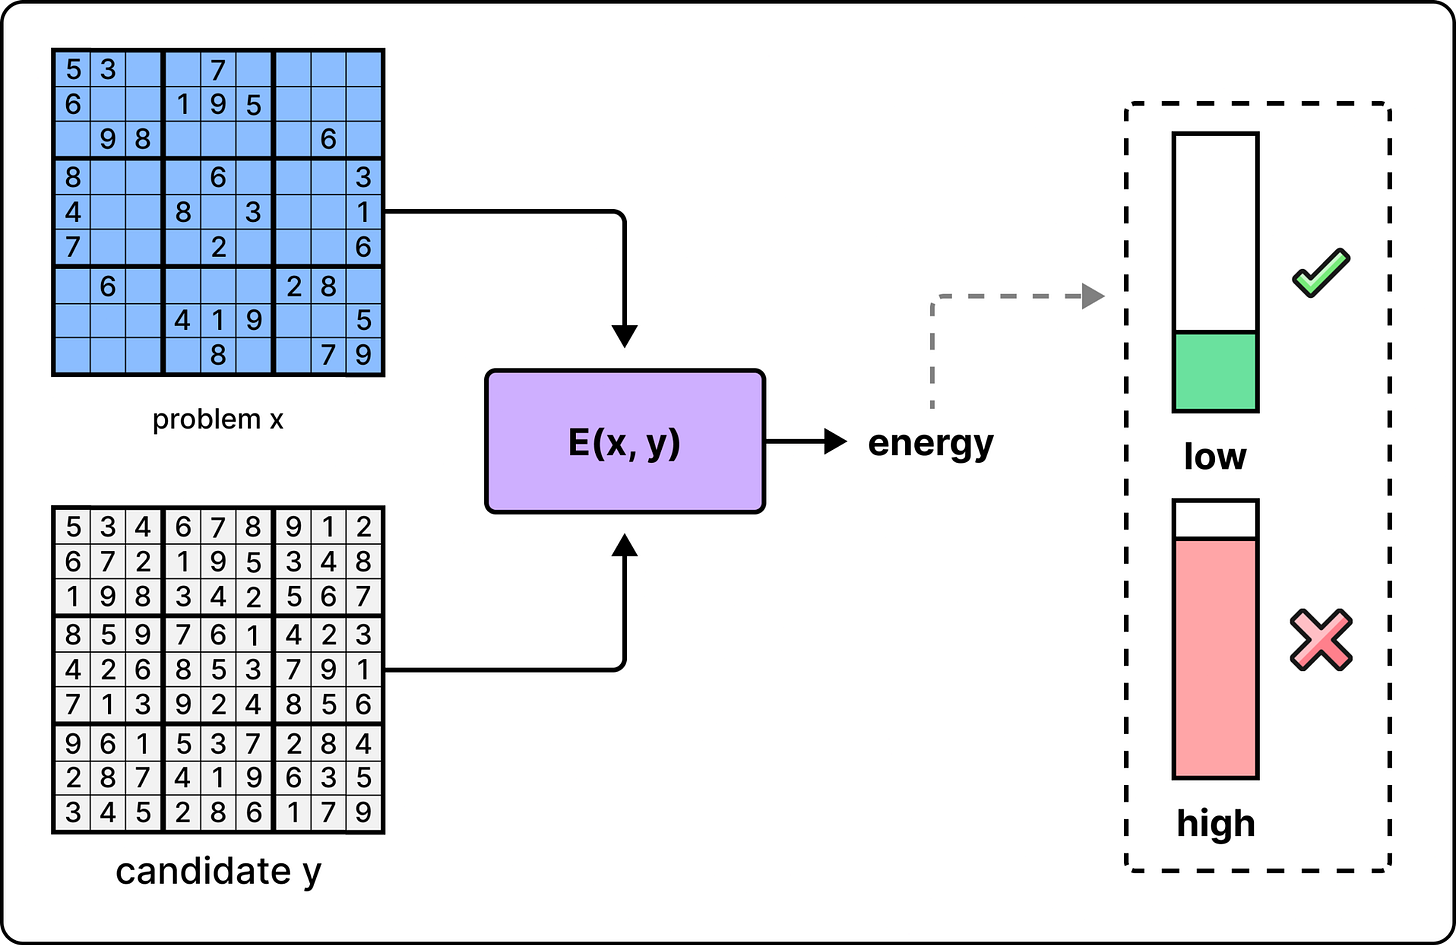
EBRM通过能量函数评估候选答案与问题的兼容性,低能量代表更一致。推理时从随机噪声开始,沿能量梯度下降搜索,直至能量不再降低。这种连续隐空间推理允许逐步逼近正确答案,且计算量随问题难度自适应,比LLM更高效。
EBRM与LLM的适用场景与分工
EBRM适合规则明确、答案可验证的任务,如数独、形式数学、芯片设计等;LLM则擅长需要判断、表达和知识的任务。文章建议二者分工:EBRM处理硬约束和可检查部分,LLM负责接口、判断与表达,形成互补系统。
验证与安全机制的不同
EBRM的推理分两阶段:搜索阶段通过能量函数概率性地拒绝错误答案,检查阶段则用机器精确验证约束是否满足。若验证失败,可快速重新搜索。这种“中间概率、末端精确”的流程提供了比LLM更可靠的保证,但约束的准确表达仍需人工完成。
Q&A
为什么大语言模型在解决数独这类约束满足问题上表现很差?
大语言模型有两个根本限制:一是从左到右逐词生成,早期放置的数字若与后续冲突,必须回溯重新生成,代价高昂;二是输出是离散的,无法微调答案使其逐步接近正确,只能丢弃重采样。因此,当答案需要同时满足多个约束时,LLM 容易失败。
能量基推理模型(EBRM)是如何工作的?
EBRM 学习一个能量函数 E(x, y),为问题 x 和候选答案 y 打分,能量越低表示答案越符合问题。推理时从随机噪声开始,沿能量下降的梯度方向逐步调整候选答案,直到能量不再下降,最后通过解码器输出答案。整个过程在连续隐空间中进行,因此可以微调答案。
EBRM 和传统语言模型在适用任务上有什么不同?
EBRM 适合规则明确、答案可精确验证的任务,如数独、形式数学、规划、化学、物理、金融和芯片设计等。语言模型则适合正确性模糊、需要判断和表达的任务,如写文章、提供商业建议等。两者可以分工合作:EBRM 处理硬约束和可验证部分,语言模型负责知识、判断和表达。
EBRM 在验证和安全性方面与语言模型有何不同?
EBRM 的推理过程分两阶段:搜索阶段通过能量函数拒绝大部分错误答案,但这是概率性的;检查阶段则用机器精确验证约束是否满足,给出是/否的确定结果。如果验证失败,可以快速重新搜索。而语言模型生成文本后需要额外的评估器和过滤器,且检查只能在生成完成后开始,增加延迟。
Kona 模型在数独实验中的表现如何?
在公开的数独实验中,包括 GPT-5.2、Claude Opus 4.5 等前沿大模型整体只解出 2% 的题目,花费约 11,000 美元 API 调用;而 Kona 模型参数规模仅数千万,却解出了 96.2% 的题目,仅花费 4 美元 GPU 时间,平均每道题 313 毫秒。
Logical Intelligence 对 AI 行业未来的发展有什么预测?
创始人 Eve Bodnia 认为未来行业将形成专用模型生态系统,而非单一通用模型。硬件可能不再依赖 GPU,因为非 LLM 模型不需要相同的计算架构。商业模式也会从按量售卖智能转向为每个客户定制模型,小模型可以快速训练,例如 Logical Intelligence 曾用两名工程师和一周时间为客户训练了一个模型。
