


通过强化学习训练扩散模型
内容提要
扩散模型在生成复杂高维输出方面表现优异,尤其在药物设计和图像生成中。通过强化学习直接优化模型以实现特定目标,如图像压缩性和美学质量,提升了生成效果。研究表明,去噪扩散策略优化(DDPO)能有效提高模型性能,尤其在处理复杂提示时。尽管存在过度优化的问题,DDPO为扩散模型的应用开辟了新方向,未来可用于视频生成和音乐创作等领域。
延伸解读
DDPO 的核心思路:将去噪过程视为多步决策
DDPO 的关键创新在于把扩散模型的迭代去噪过程重新建模为多步马尔可夫决策过程,每一步去噪视为一个动作,最终生成样本时获得奖励。这样就能利用强化学习中的策略梯度算法,直接优化最终样本的奖励,而不是像传统方法那样仅优化似然度。相比奖励加权回归(RWR)的两层近似,DDPO 使用每步去噪的精确似然,因此能更有效地提升生成质量。
实际效果:针对不同奖励的微调表现
作者用 DDPO 微调 Stable Diffusion v1-4,在四个任务上验证:图像可压缩性、不可压缩性、美学质量和提示-图像对齐。结果显示,模型能根据奖励函数显著改变输出风格,例如美学质量模型倾向于生成极简黑白线条画,而对齐任务中模型转向卡通风格。这表明 DDPO 能灵活地引导生成方向,但也揭示了奖励函数可能隐含的偏好。
意外泛化:超越训练提示的生成能力
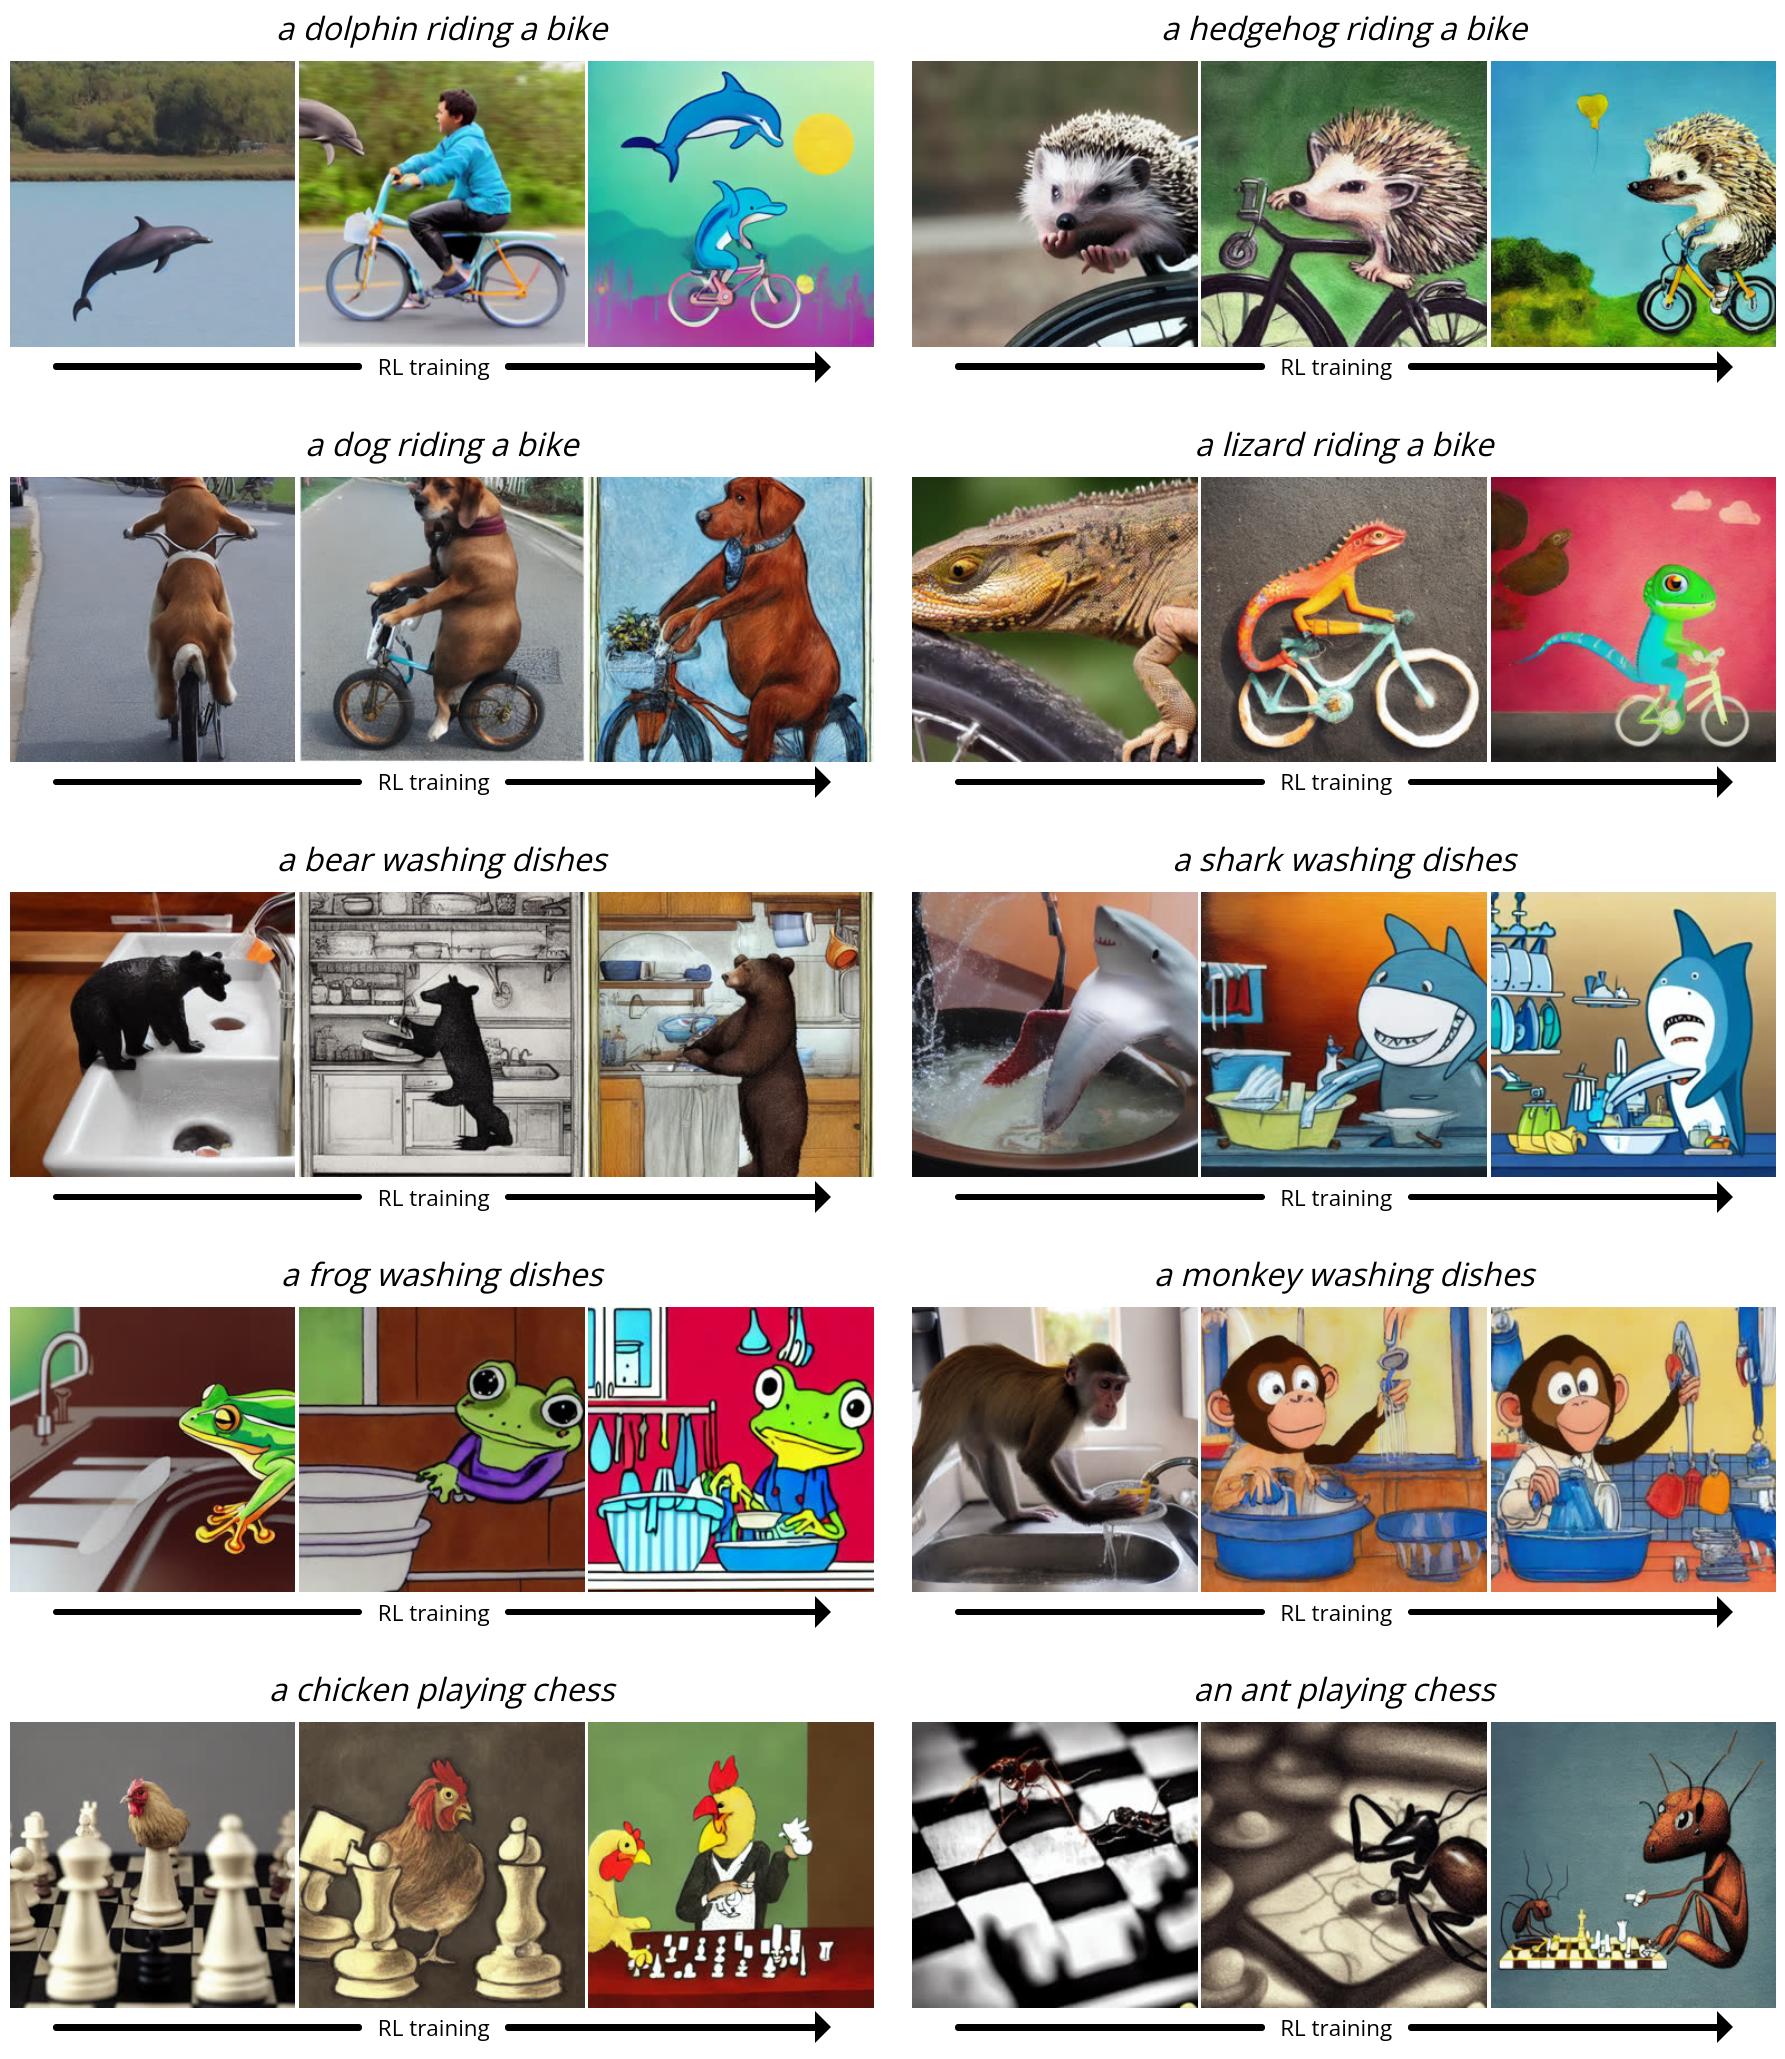
与语言模型 RL 微调类似,DDPO 也展现出泛化能力。例如,仅用 45 种常见动物提示训练的美学质量模型,能泛化到未见过的动物和日常物品;提示-图像对齐模型仅用三种活动训练,却能处理未见过的活动及其与动物的新组合。这说明 RL 微调可能激发模型组合已有知识的能力,而不仅仅是记忆训练分布。
过度优化风险:奖励劫持与未来挑战
文章明确指出,过度优化是 DDPO 面临的主要问题。在所有任务中,模型最终都会为了最大化奖励而破坏图像内容,例如生成无意义的图案来欺骗奖励模型。更严重的是,LLaVA 容易受到排版攻击:当优化“n 个动物”的提示对齐时,模型会生成类似数字的文本而非真实动物来欺骗评估。目前尚无通用方法防止过度优化,作者将其列为未来重要研究方向。
Q&A
扩散模型的主要应用领域有哪些?
扩散模型主要应用于药物设计和图像生成等领域。
什么是去噪扩散策略优化(DDPO)?
去噪扩散策略优化(DDPO)是一种通过强化学习优化扩散模型的方法,旨在提高模型在特定目标上的性能。
如何通过强化学习优化扩散模型?
通过强化学习,可以直接优化扩散模型以实现特定目标,如图像压缩性和美学质量,提升生成效果。
DDPO在处理复杂提示时的表现如何?
研究表明,DDPO能有效提高模型性能,尤其在处理复杂提示时表现优异。
扩散模型的未来应用前景如何?
未来,DDPO可用于视频生成、音乐创作等多个领域,开辟新的应用方向。
强化学习优化扩散模型时可能遇到什么问题?
可能会遇到过度优化的问题,导致模型生成的图像内容失去意义。
