


微调 vs. 冻结嵌入:何时该调整 LLM,何时该调整 Sklearn 分类头
内容提要
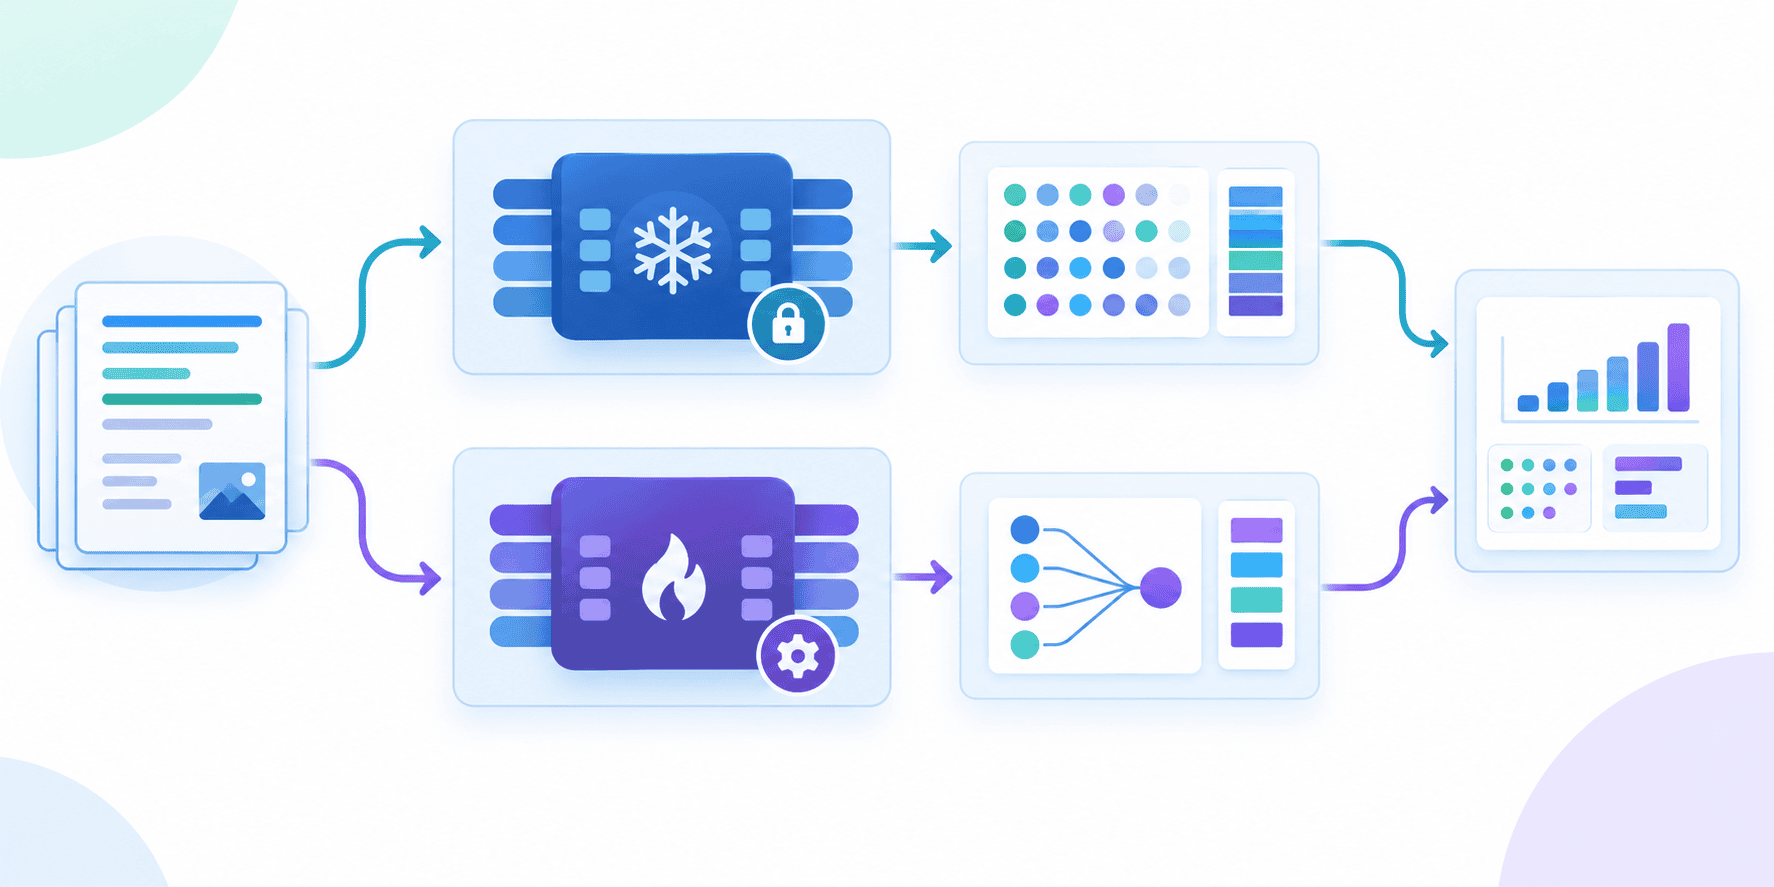
文章比较两种领域适配LLM策略:冻结嵌入加scikit-learn分类器,与QLoRA微调。在AG News四分类实验中,前者提取嵌入约96.5秒、分类器训练2.9秒,准确率82%;后者训练约300秒,准确率87%。结论:追求快速、低算力且避免过拟合时选冻结嵌入;需缩小精度差距或学习深层领域细节时选QLoRA微调。
延伸解读
时间成本的实际分布
在冻结嵌入方案中,96.5秒的提取时间占了绝大部分,而分类器训练仅需2.9秒。这意味着如果嵌入可以预先计算并缓存,后续迭代分类器几乎不增加成本。相比之下,QLoRA微调耗时300秒,且全部用于训练过程。对于需要频繁调整分类头的场景,冻结嵌入的迭代效率优势明显。
精度差距的权衡
QLoRA微调将准确率从82%提升到87%,5个百分点的差距是否值得约3倍的训练时间,取决于具体任务对精度的敏感度。文章指出,当缩小精度差距对领域应用至关重要,或模型需要学习深层领域细节时,微调是更好的选择。反之,若精度可协商,冻结嵌入更划算。
过拟合风险的考量
文章明确将“避免骨干网络过拟合”列为选择冻结嵌入的理由之一。由于LLM权重被冻结,模型不会在小型领域数据集上过度调整,从而降低过拟合风险。QLoRA虽然只训练少量适配器参数,但仍会更新模型内部表示,在数据量有限时需更谨慎评估。
任务类型的适用边界
文章强调,这一比较主要针对分类任务。对于文本生成或代码生成等纯生成任务,模型适配(如微调)通常是实现专业化行为的必要手段。不过,在免费层部署且对最高性能要求不严格的生成工作流中,冻结嵌入策略有时也可作为可行替代。
Q&A
在AG News四分类任务中,冻结嵌入加scikit-learn分类器与QLoRA微调的训练时间和准确率分别是多少?
冻结嵌入方法提取嵌入约96.5秒,分类器训练2.9秒,准确率82%;QLoRA微调训练约300秒,准确率87%。
什么时候应该选择冻结嵌入加scikit-learn分类器而不是微调LLM?
当追求快速训练、低算力开销,并希望避免骨干模型过拟合时,推荐使用冻结嵌入加scikit-learn分类器。
QLoRA微调相比冻结嵌入方法有哪些优势和代价?
优势是准确率更高(87% vs 82%),能学习深层领域细节;代价是训练时间更长(约300秒 vs 约100秒),计算开销更大。
冻结嵌入方法是如何工作的?
将文本输入冻结的LLM(权重不变),提取最后一个隐藏状态作为嵌入向量,然后训练一个轻量级分类器(如随机森林)进行分类。
QLoRA微调中LoRA适配器的作用是什么?
LoRA冻结预训练权重,在Transformer层中注入可训练的适配器矩阵(约占模型总参数的1-2%),只训练这些小型矩阵,同时保持4位精度以节省内存。
对于生成任务(如文本生成),是否也应该使用冻结嵌入加分类器的方法?
对于纯生成任务,通常需要微调等模型适应方法来实现专门行为;冻结嵌入策略有时可作为免费层部署中性能稍可妥协的替代方案。
