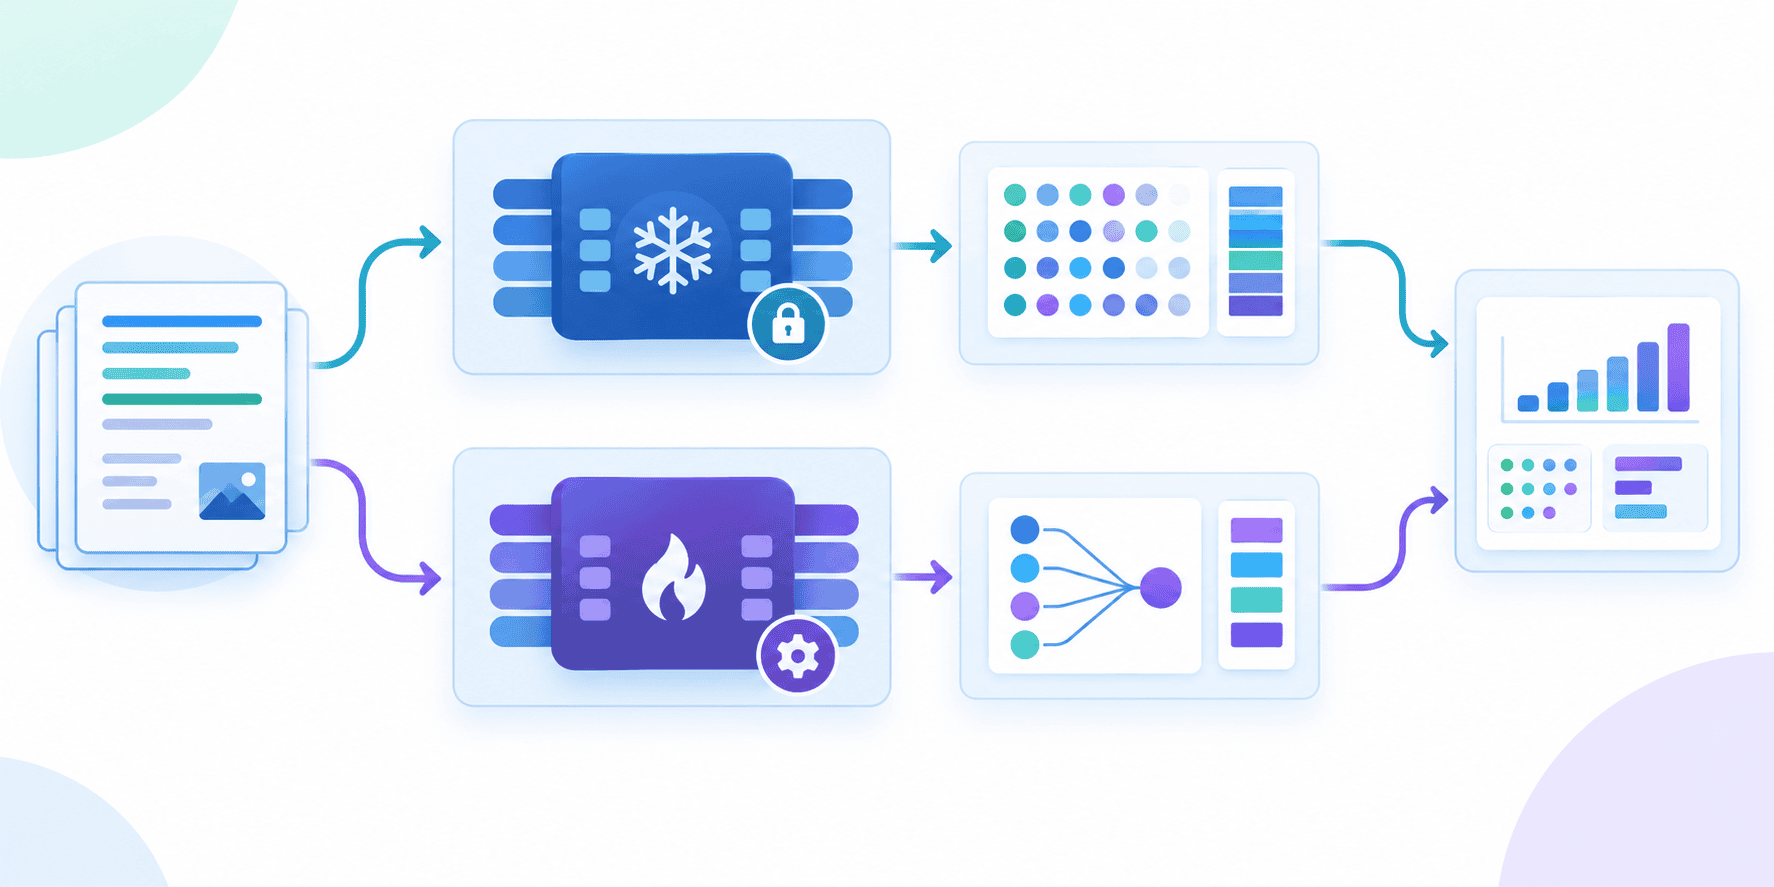
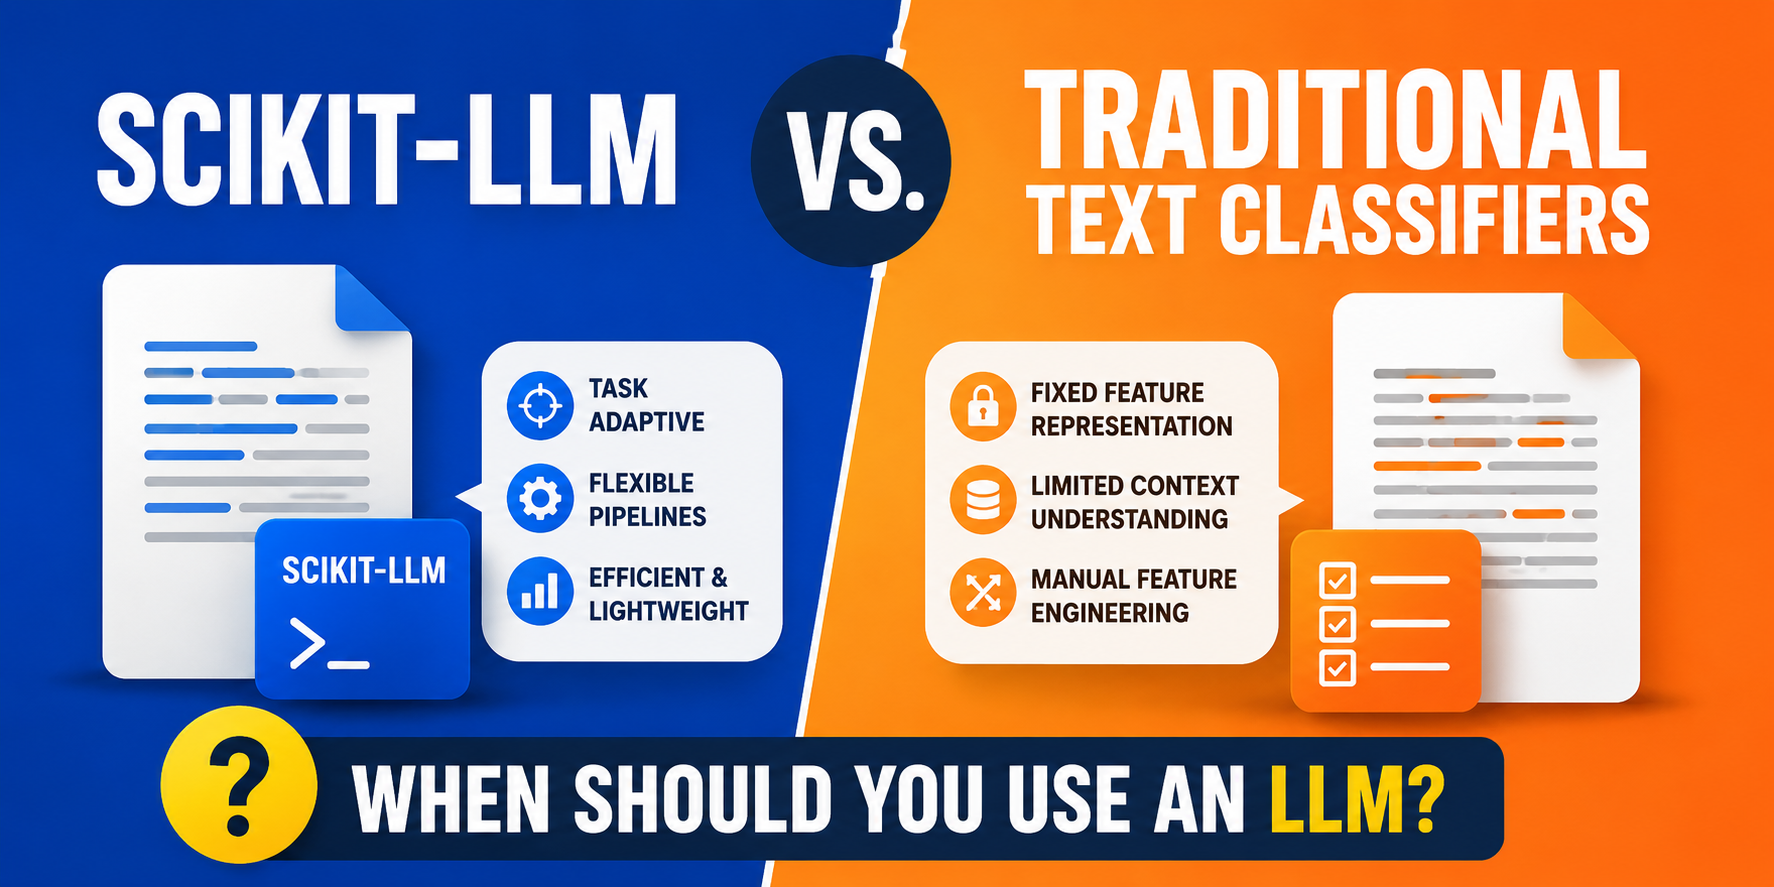
文章比较两种领域适配LLM策略:冻结嵌入加scikit-learn分类器,与QLoRA微调。在AG News四分类实验中,前者提取嵌入约96.5秒、分类器训练2.9秒,准确率82%;后者训练约300秒,准确率87%。结论:追求快速、低算力且避免过拟合时选冻结嵌入;需缩小精度差距或学习深层领域细节时选QLoRA微调。
Scikit-LLM 是一个 Python 库,将预训练大语言模型封装为 scikit-learn 风格的 fit() 和 predict() 接口,无需重新训练模型。文章以 IT 支持工单分类为例,演示少样本分类:仅需 3 至 5 个带标签示例即可引导模型准确分类新文本,效果优于零样本分类,尤其适合领域特定任务。
开源项目 jeff 使用 4 亿参数 GLiFormer 模型在本地 GPU 进行文本分类,完整复刻 TypeSafe 的 jev API 协议,仅需修改 TYPESAFE_BASE_URL 环境变量即可零代码迁移,成本从每百万次 15.6 美元降至 2.6 美元。简单情感和情绪分类准确率几乎追平 jev,但 AG News 主题分类和反讽检测落后约 15 个百分点。推荐使用 Modal 平台的 L4 GPU 部署,每秒约处理 50 次请求。
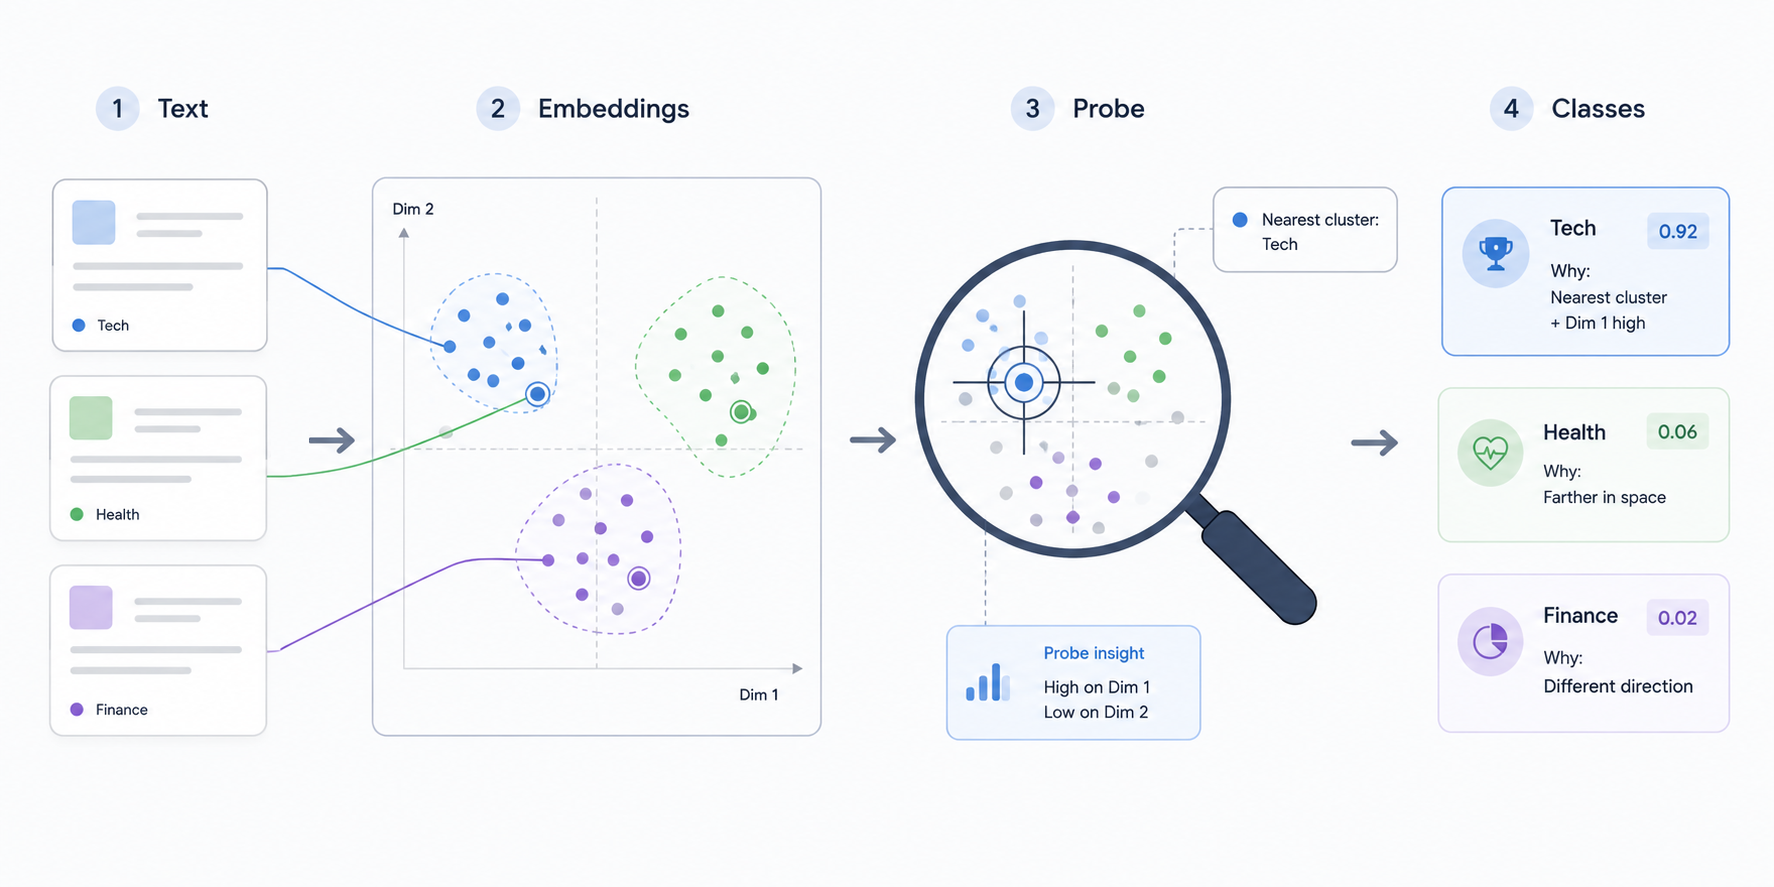
本文介绍如何利用Scikit-LLM和本地Ollama模型生成电影评论嵌入,训练逻辑回归分类器评估质量,并通过UMAP降维可视化语义结构,最后使用SHAP值识别关键嵌入维度,以提升LLM文本分类的可解释性。
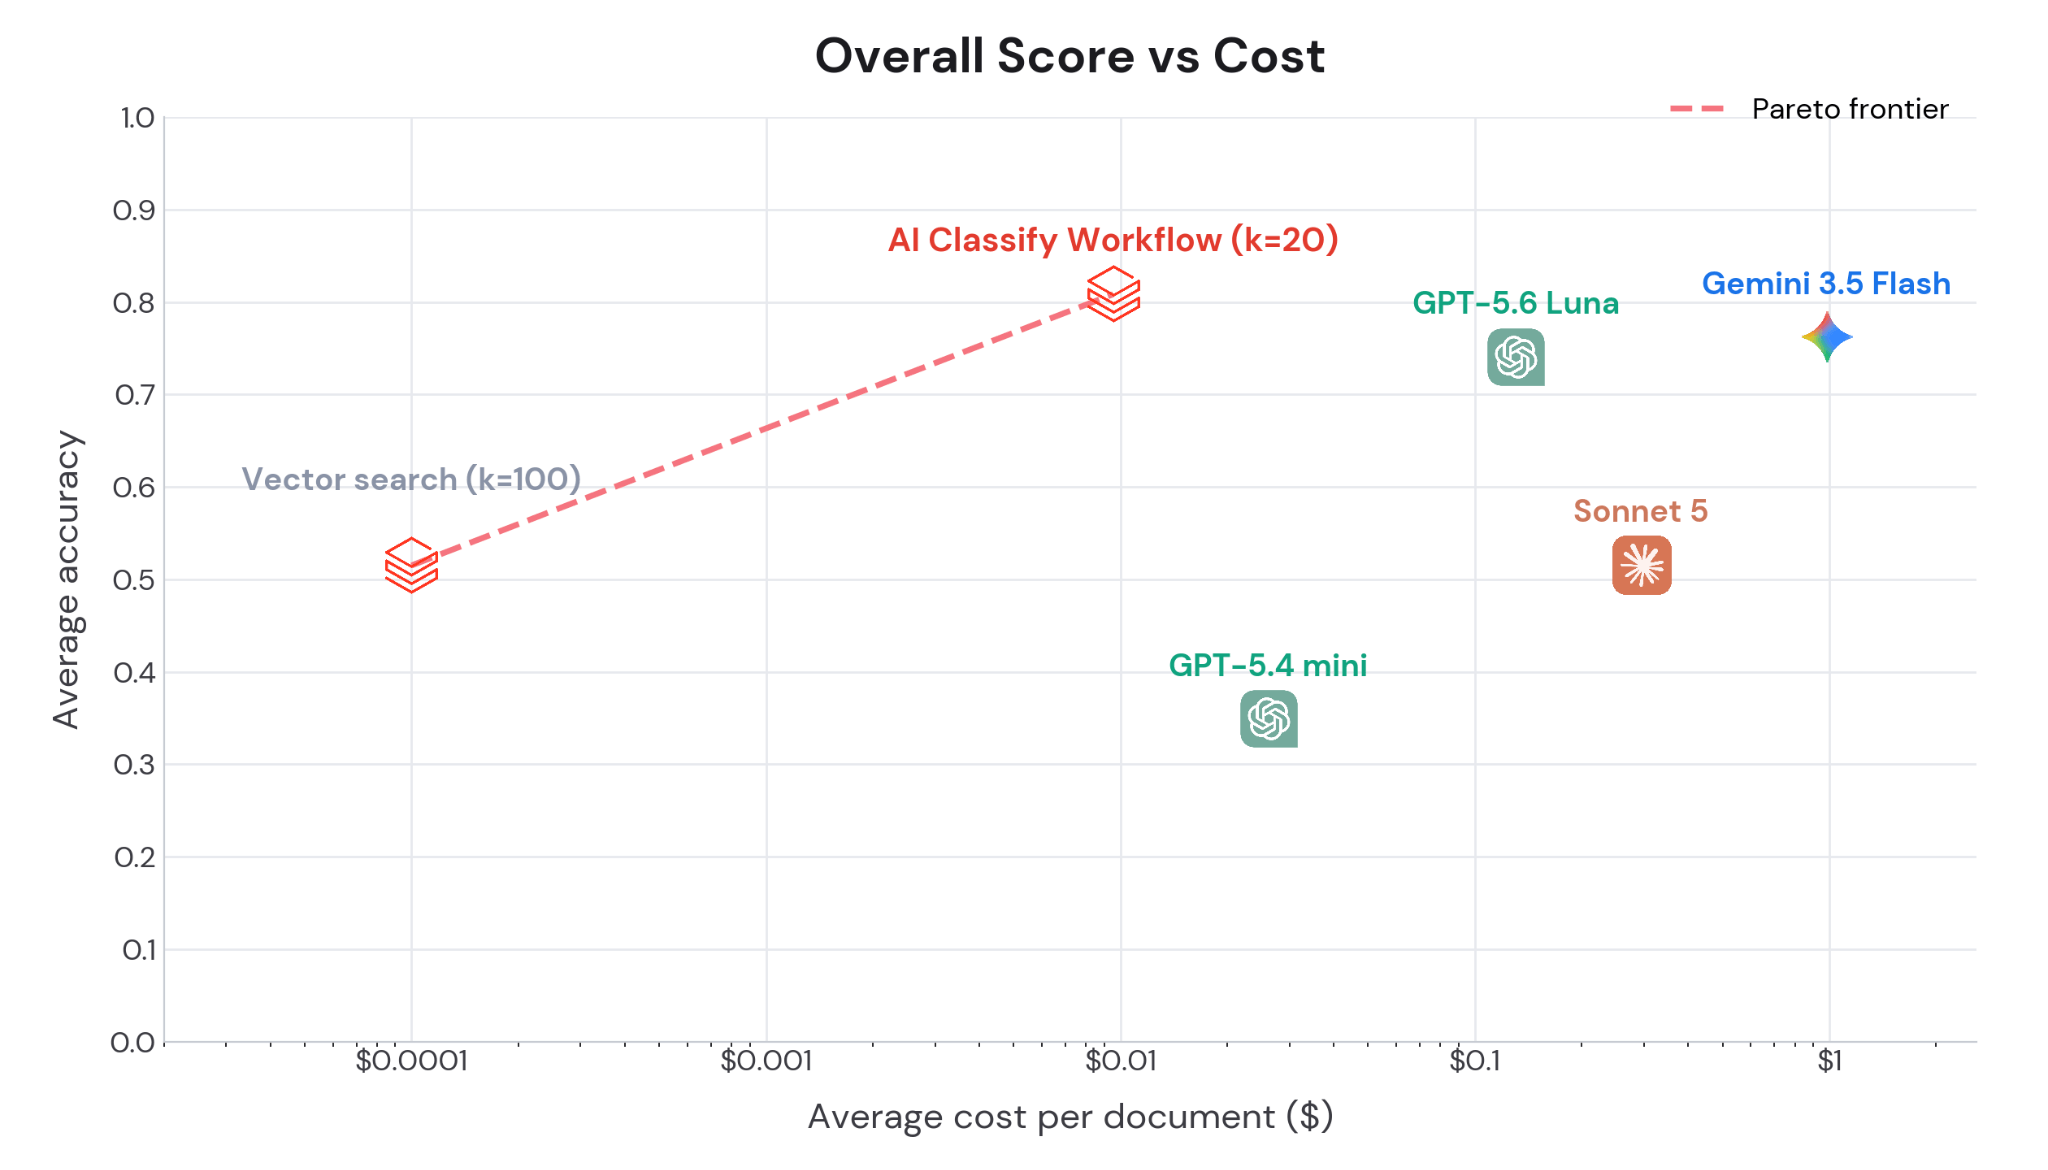
Databricks 测试了三种大规模文本分类方法:纯向量搜索、向量搜索结合AI Classify、直接调用前沿大模型。结果显示,向量搜索加AI Classify的工作流在35,000至100,000标签的基准测试中,准确率达0.81,比最强直接模型高5个百分点,成本仅为后者的百分之一,且无需重新训练,是成本与质量的最佳平衡。
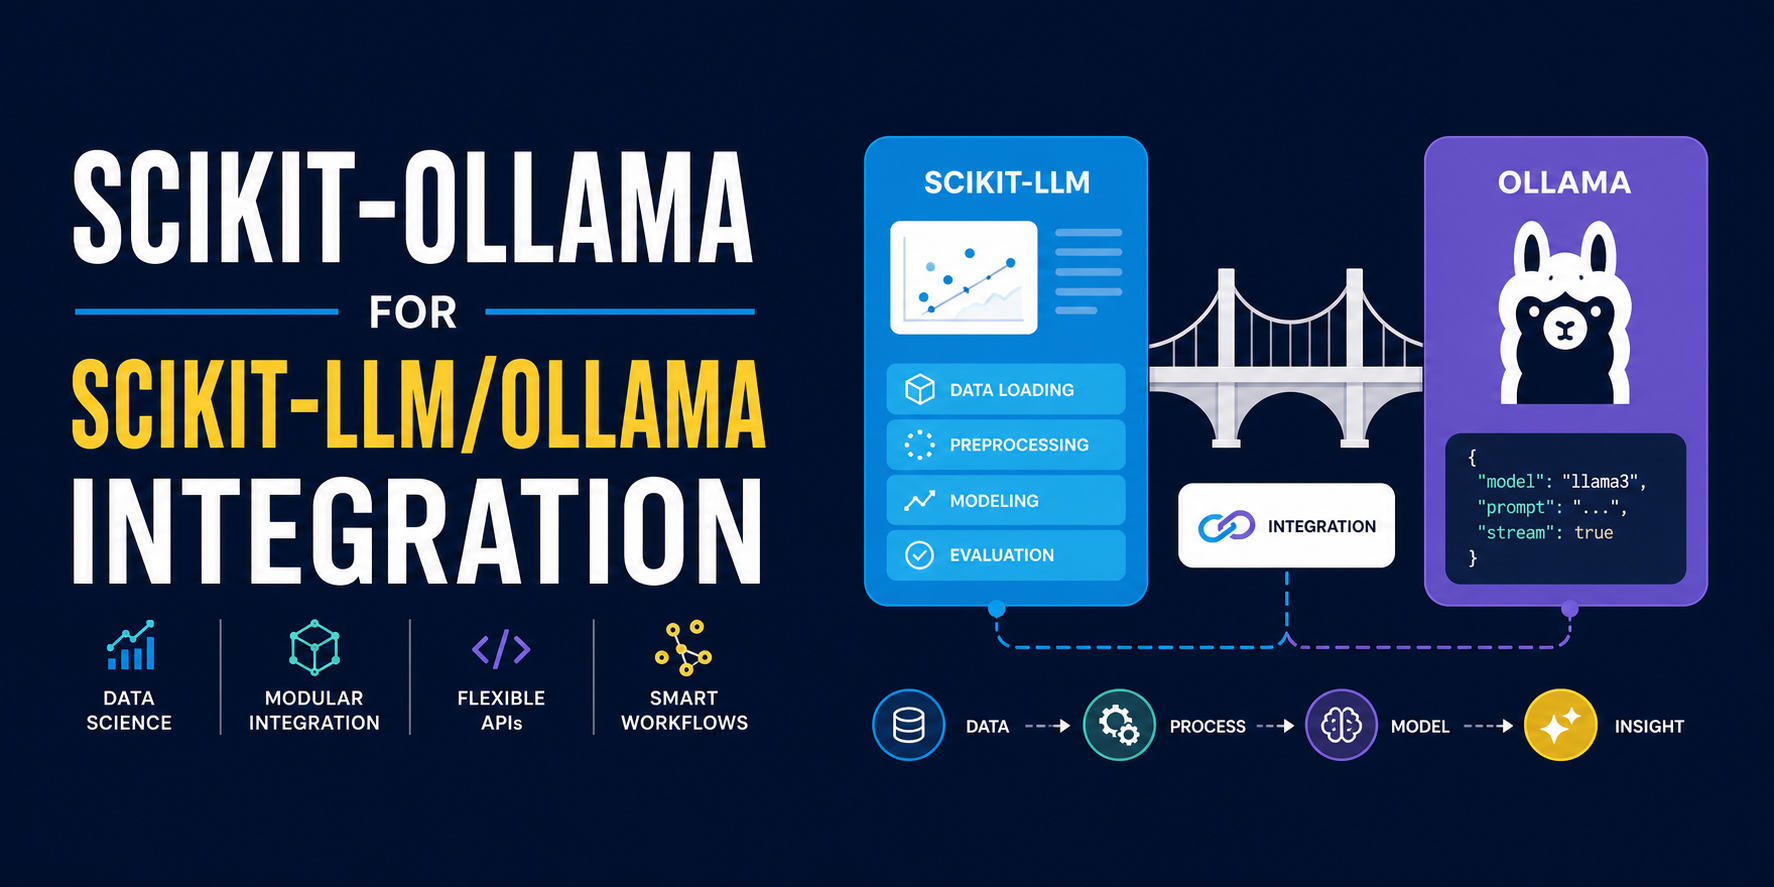
本文介绍了scikit-ollama如何将scikit-learn接口与本地Ollama模型结合,实现零-shot文本分类,无需云API。用户可以使用本地Llama 3模型加载电影评论情感数据集,并创建情感预测分类器,从而简化传统机器学习流程,避免数据隐私问题和订阅费用。
本文介绍如何使用Ollama本地托管的开源语言模型(如Llama 3、Mistral和Gemma)进行文本分类,避免支付API费用。内容包括Ollama的安装、Scikit-LLM库的配置,以及构建零样本文本分类器的步骤。通过简单的Python代码,用户可以实现模型的训练和预测,展示如何高效使用大型语言模型。
本文比较了三种文本分类方法:传统的TF-IDF与逻辑回归、基于BART的零-shot分类和使用scikit-LLM的零-shot分类。研究表明,scikit-LLM在分类准确性(0.86-0.87)和速度上优于其他方法,适合处理数据量小且需要深度语言理解的任务。
本文介绍了词袋模型(BoW)在自然语言处理中的应用,强调其通过记录词汇出现频率将文本转换为数值向量的有效性。BoW适用于文本分类和情感分析等任务。文章还展示了如何使用PyCharm构建文本分类项目,包括数据预处理、特征提取和模型训练,并强调了PyCharm在调试和可视化方面的优势。最后,讨论了BoW的局限性及其替代方法,如词嵌入和变换器模型。
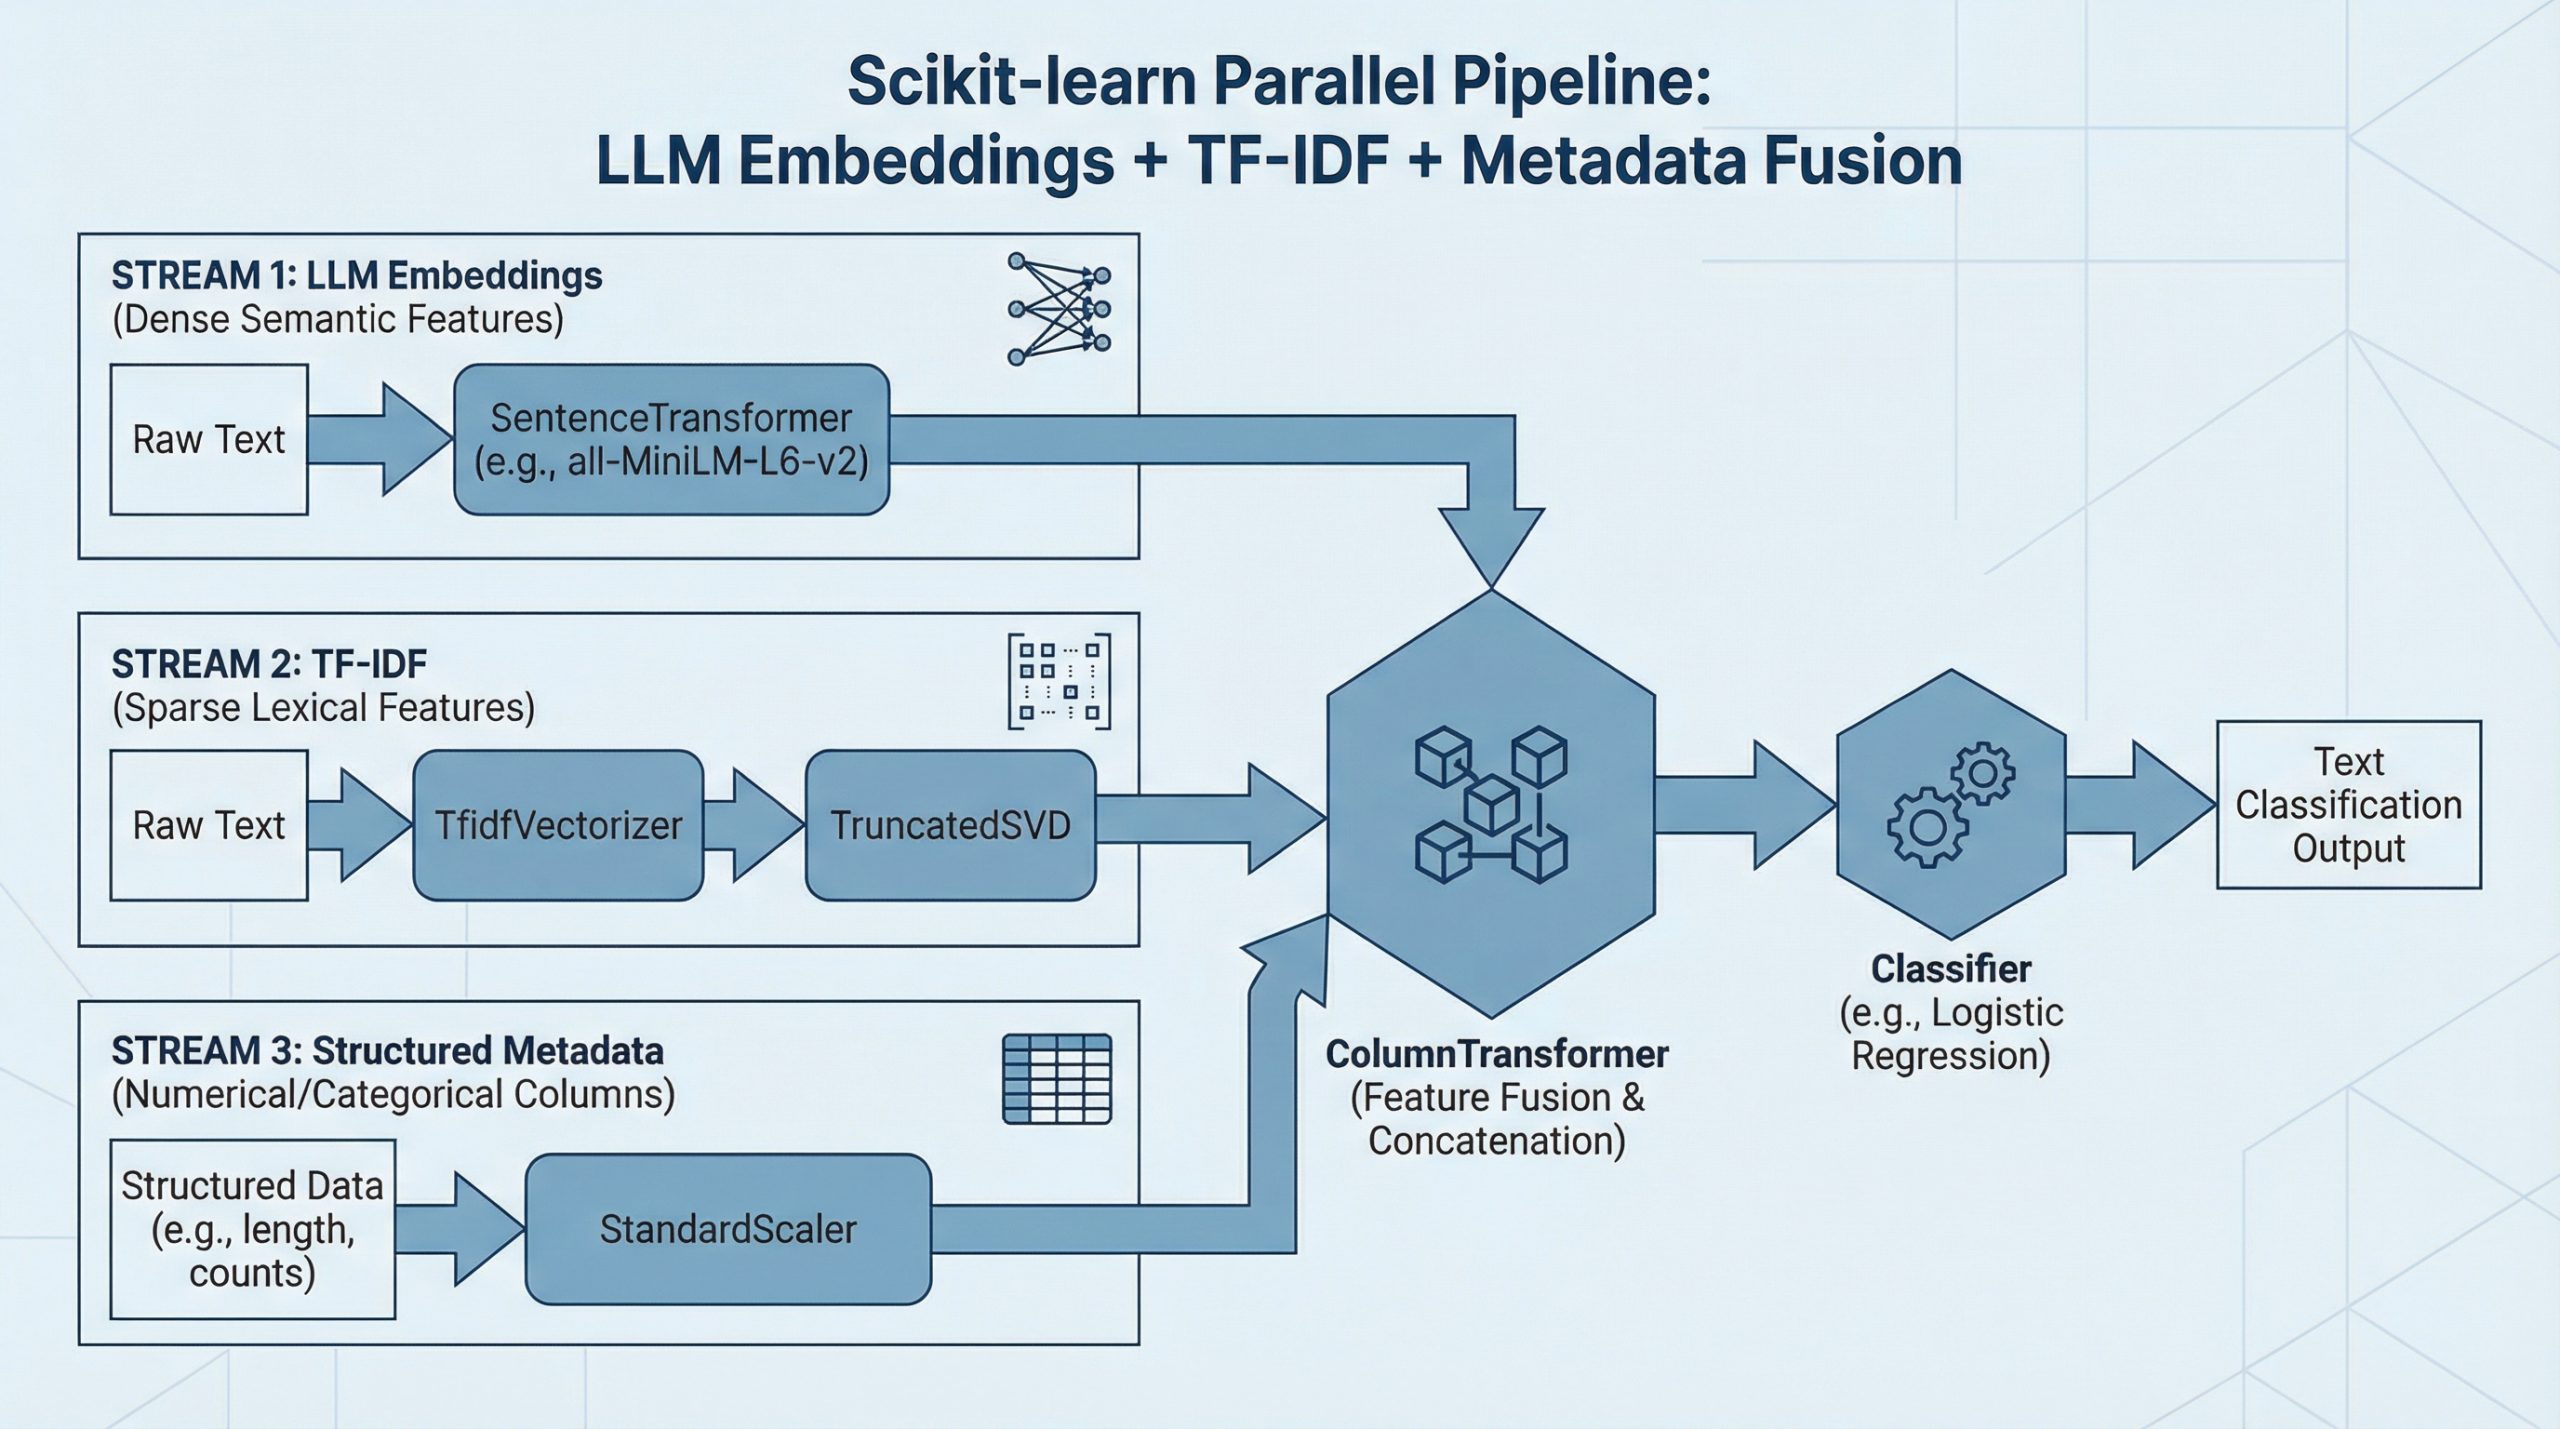
本文介绍了如何在scikit-learn管道中结合LLM嵌入、TF-IDF特征和结构化元数据进行文本分类。主要步骤包括加载数据集、构建特征管道、融合特征以及训练分类器,以实现高效的文本分类模型。
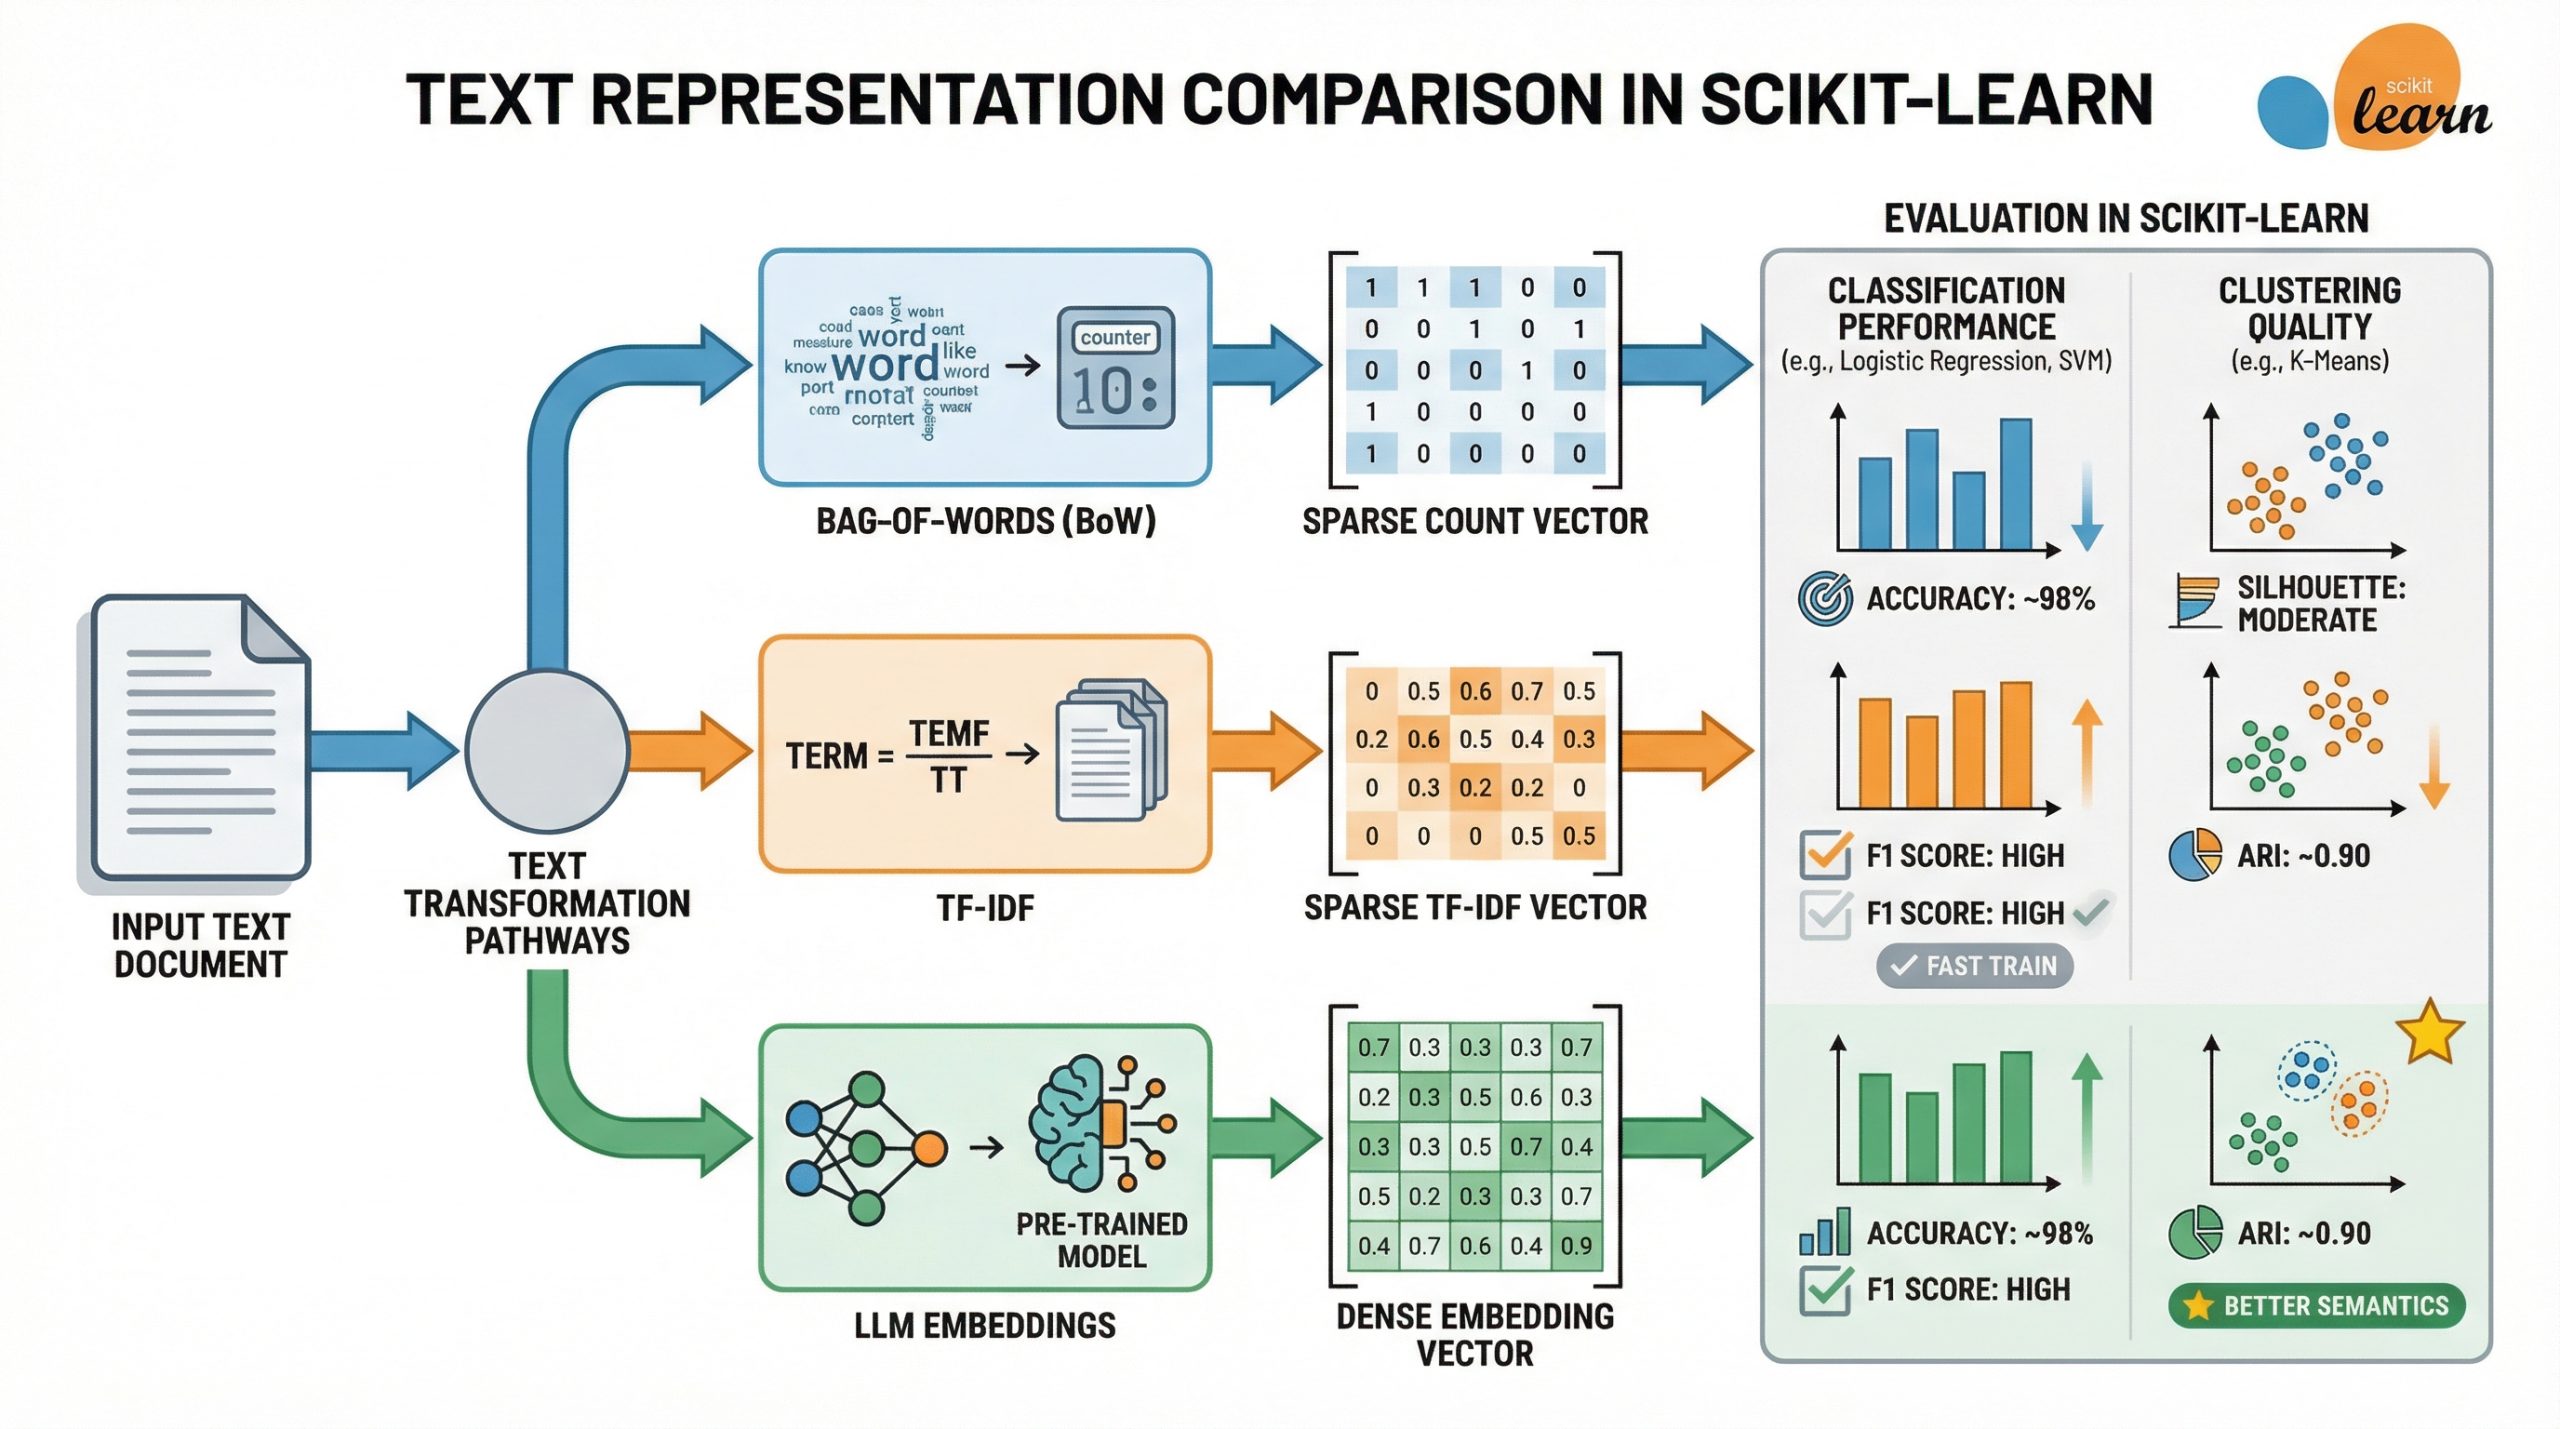
本文比较了词袋模型(BoW)、TF-IDF和LLM嵌入在Scikit-learn中的效果,使用BBC新闻数据集分析它们在文本分类和聚类中的表现。结果显示,TF-IDF与支持向量机组合在分类准确率上最佳,而LLM嵌入在聚类任务中表现更佳。建议在处理简单数据集时优先考虑传统方法。
Python 3.14引入了zstd模块,支持增量压缩,促进文本分类与机器学习结合。文章还讨论了Python函数定义、开发者会议、Google Gemini CLI使用及NumPy并行加速等主题。
ML.NET 可通过文本分类和命名实体识别(NER)提取人名和地名。实现步骤包括安装必要的包、准备预训练模型、定义数据结构、构建 ML 管道并进行预测。尽管 ML.NET 在 NER 生态中不如 Python 库丰富,但适合于已有 .NET 技术栈的轻量集成场景。
Natural是一个轻量级的JavaScript自然语言处理库,提供分词、词干提取和文本分类等基本功能,适合初学者使用。
自然语言处理(NLP)使计算机理解和生成类人语言。本文介绍了从零开始创建NLP项目的步骤,包括环境配置、工具选择和常见任务(如情感分析和文本分类)。开发者需具备Python编程和机器学习基础。NLP系统通过分析语法、语义和上下文处理语言,广泛应用于聊天机器人和翻译软件等领域。
句子嵌入和词嵌入在自然语言处理中的应用各有不同。句子嵌入适合整体语义理解,常用于语义搜索和文本分类;词嵌入则适合细粒度分析,如命名实体识别和词性标注。选择合适的嵌入方式取决于具体任务需求。
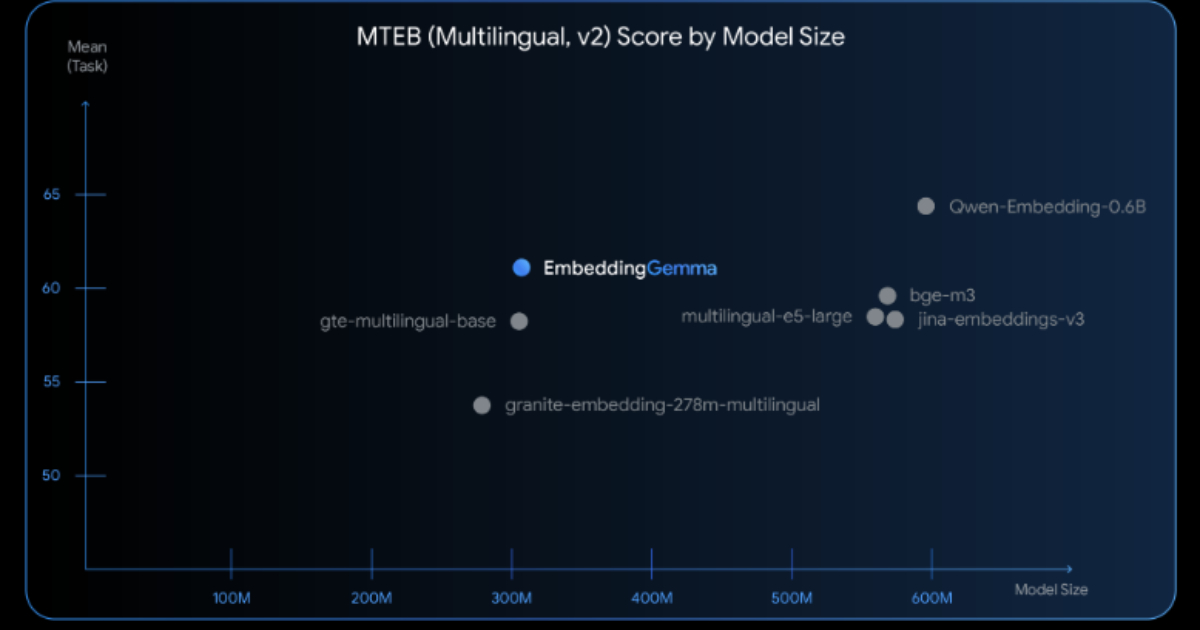
谷歌DeepMind推出了EmbeddingGemma,一个308M参数的开放嵌入模型,旨在高效地在设备上运行。该模型支持离线检索增强生成、语义搜索和文本分类,适合隐私敏感场景,并在MTEB基准测试中表现优异,支持100多种语言。开发者可根据需求调整输出维度并进行微调。
谷歌推出Gemma 3开源模型,参数仅2.7亿,支持本地运行,适合文本分类和数据提取等任务,具备低能耗和快速微调的特点,保障用户隐私。
提示词注入攻击已成为大模型的主要威胁。研究表明,TokenBreak可以绕过文本分类模型的检测,通过巧妙修改输入词汇而不改变其含义。BERT等模型易受攻击,而Unigram模型相对安全,因此建议在提示词检测中优先使用Unigram模型。
麻省理工学院的研究团队开发了一款新软件,旨在提升文本分类器的准确性。通过生成对抗性示例,研究人员发现特定词汇对分类结果有显著影响。该软件免费提供,帮助检测和改进分类器,确保在金融和医疗等重要领域的可靠性。
完成下面两步后,将自动完成登录并继续当前操作。