


智能体记忆:驾驭框架内部机制
内容提要
本文讨论生产环境中的智能体记忆基础设施,区分“状态”(单次运行的工作数据)与“记忆”(跨会话保留的知识)。上下文压缩必然有损,决定成本与可靠性;提示词和技能应像代码一样版本化、评估和回滚。企业数据需通过持续管道而非迁移进入记忆,并做好溯源、删除级联和访问控制。数据库在过滤召回、一致性和时间建模上决定记忆系统上限。
延伸解读
状态与记忆:别把检查点当记忆
文章明确区分状态与记忆:状态是单次运行的工作数据,包括计划、中间结果和崩溃恢复的检查点;记忆是跨会话保留的知识。检查点只持久化状态,不产生记忆。两者生命周期、范围和治理方式不同,混为一谈是这一层最常见的架构错误。分类应依据生命周期和范围,而非产物类型。
压缩策略同时决定成本与可靠性
上下文压缩必然有损,丢弃什么直接决定质量:过度摘要会丢掉用户十轮前设定的约束,聚合掉异常日志会让智能体更糟;压缩不足则窗口被噪声填满。每个带入下一轮调用的 token 都要重复付费,而输出 token 更贵,臃肿上下文迫使智能体反复调和已混乱的信息,间接推高成本。多数团队在窗口近 95% 时自动触发压缩,关注上下文的团队常在 60% 左右主动压缩。
提示词与技能需要像代码一样治理
系统提示词和技能通常被当作文本就地编辑、跨环境复制、无变更记录,但在生产规模下它们就是基础设施。提示词需要版本化、上线前评估和秒级回滚,因为一次改动对行为的影响不亚于代码变更。技能是智能体的程序性记忆,可执行,因此不受信任的技能能像不受信任代码一样窃取数据,基线防御是在沙箱中运行智能体控制流和工具。既是记忆又是指令的单元,必须按两者同时治理。
数据库在第一天就设定了记忆系统的上限
过滤召回、一致性和时间建模三项能力由数据库决定。过滤在向量搜索之后做会丢弃大部分匹配;在搜索之前朴素地做会破坏索引图结构、损失精度;只有内建于索引的过滤才能在选择性条件下保住召回,而按用户和租户隔离正是这种选择性场景。最终一致性下新写入的记忆可能读不到,对自动行动的智能体就是新旧数据的分界线。数据库若不建模时间,记忆就无法正确回答关于过去的问题。这些限制在小规模不显现,在生产量级才暴露。
Q&A
智能体状态和记忆有什么区别?
状态是单次运行的工作数据,包括计划、中间结果和崩溃后恢复的检查点;记忆是跨会话保留的知识,经过整理、学习或提取,并在多次运行中读取。检查点持久化状态,但不创建记忆。
上下文压缩为什么会影响智能体的成本和可靠性?
压缩必然有损,丢弃什么决定质量:过度压缩会丢失关键约束,压缩不足会让窗口充满噪声。同时,每个带入下一次调用的token都要再次付费,且输出token成本更高,臃肿上下文会迫使更多轮次来纠正错误,从而推高成本。
如何在不迁移企业系统的情况下把数据导入智能体记忆?
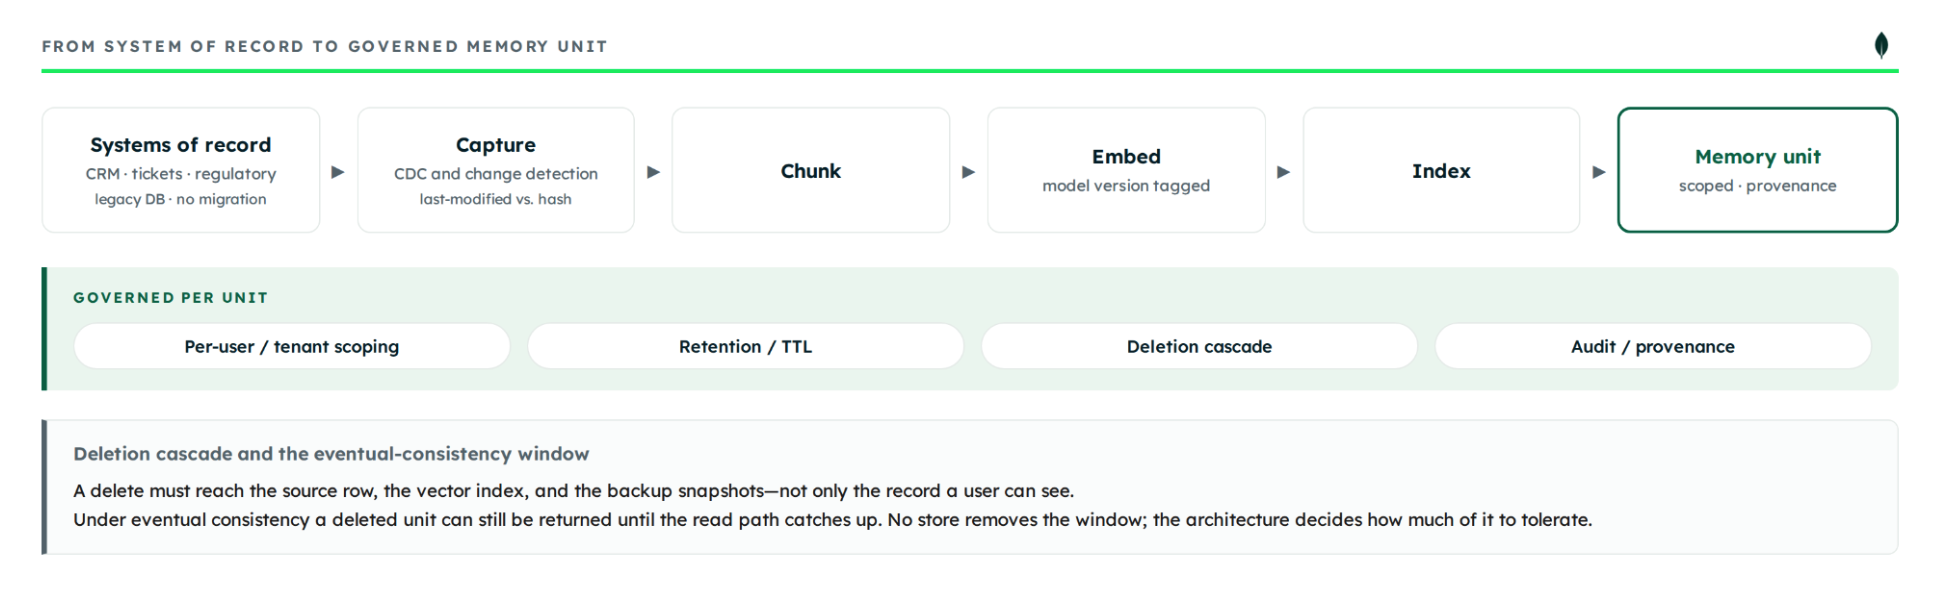
通过持续管道而非一次性迁移:使用变更数据捕获流式获取插入、更新和删除,将数据分块、嵌入、索引并标记元数据(包括来源和版本),使记忆跟踪记录的当前状态,而源系统保持原位。
为什么提示词和技能需要像代码一样进行版本控制和治理?
提示词和技能是影响智能体行为的基础设施。提示词需要版本化以追溯回归、发布前评估和快速回滚;技能是可执行的过程记忆,可能被恶意利用,因此需要沙箱执行和访问控制。两者都应作为受管工件进行治理。
数据库选择如何限制智能体记忆系统的能力?
数据库在三个方面设定上限:过滤召回(索引内过滤才能保持选择性过滤下的召回率)、一致性(写后读的可见性窗口影响自动决策)、时间建模(能否记录事实的有效期以回答历史问题)。这些限制在生产规模下才会显现,但选择在第一天就决定了天花板。
删除记忆时需要注意哪些问题?
删除请求必须到达数据所有驻留点:源行、向量索引和备份快照。在最终一致性下,已删除记忆可能在索引追上之前仍被查询返回,这对合规是问题。因正确性删除(如错误捕获)需立即不可服务;因源系统变更删除则走最终一致性路径。架构必须考虑这个窗口。
