

高级 RAG 技术:图解概览 [译]
内容提要
本文系统梳理高级RAG(检索增强生成)技术:先介绍标准流程——分块、向量化、索引、检索并生成答案;再详解进阶方法,包括分层索引、假设性问题与HyDE、句子窗口与父文档等语境增强、融合检索、重排序过滤、查询变换与路由、聊天引擎、多文档智能体及响应合成;最后讨论编码器、排序器与大语言模型微调及RAG评估指标。
延伸解读
分块大小:检索精度与上下文完整性的权衡
文章指出,分块大小取决于嵌入模型的令牌容量,例如BERT类模型最多512个令牌,而OpenAI ada-002可处理8191个令牌。块太大虽能为LLM提供更多上下文,但嵌入向量可能不够具体,影响搜索精度;块太小则可能丢失语义。因此需要根据模型能力和任务需求找到平衡点,这是构建RAG系统时需仔细调整的参数。
语境增强:用小块检索,用大块推理
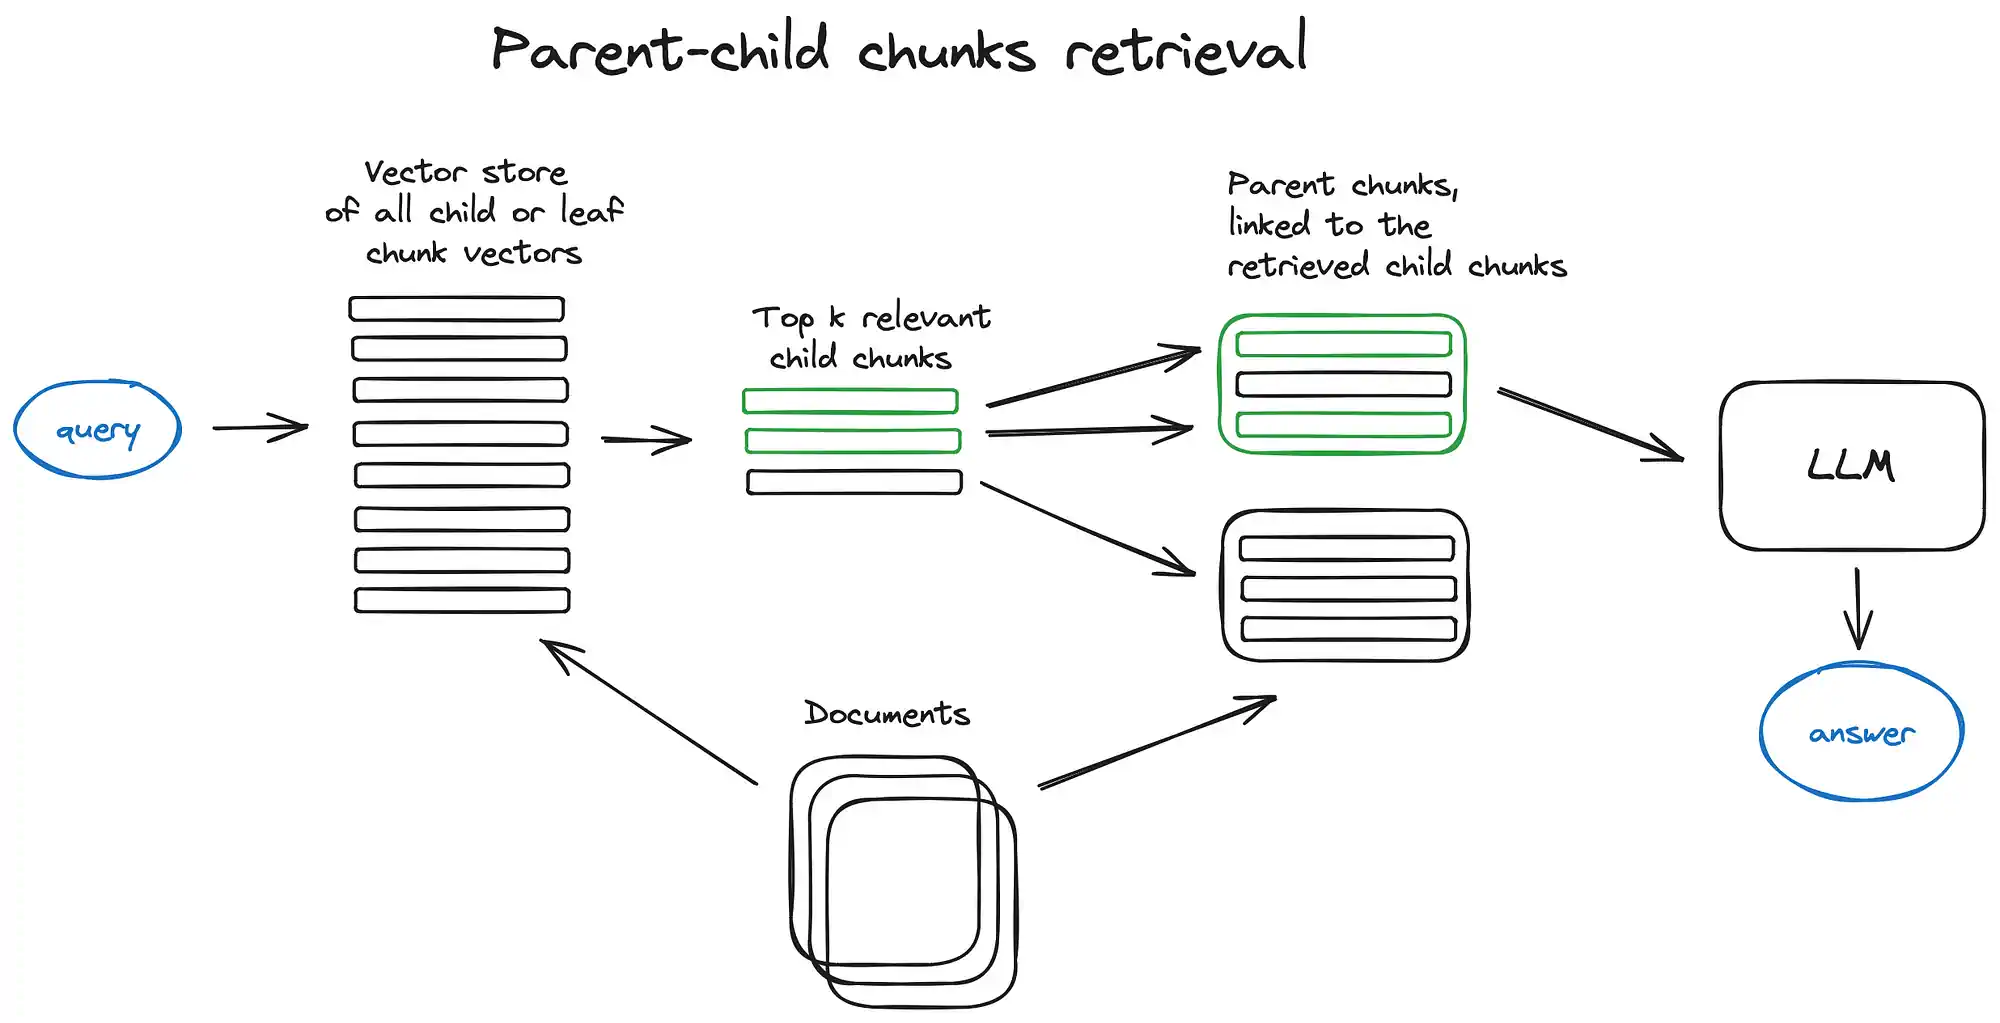
句子窗口检索和父文档检索都采用“检索精细片段,扩展上下文窗口”的思路。前者对每个句子单独编码以提高搜索准确性,检索后扩展前后k个句子送给LLM;后者将文档分成层次化块,检索叶子块后若多个块指向同一父块,则用父块替换。这两种方法旨在兼顾检索的精准度和LLM推理所需的语境完整性。
查询变换与路由:让LLM参与检索决策
查询变换利用LLM对用户输入进行调整,例如将复杂问题拆分为子查询、生成回溯提示或重写查询,以提升检索质量。查询路由则让LLM决定后续操作,如选择特定索引或数据存储位置。这些技术将LLM的推理能力融入RAG流程,使系统能更灵活地处理复杂查询和多源数据。
微调与评估:提升RAG效果的关键环节
文章提到微调编码器可使检索质量提升2%,微调交叉编码器排序器可提升4%的成对比较得分,而微调GPT-3.5-turbo则使忠实度提高5%。评估方面,Ragas等框架使用答案相关性、基于性、真实性和检索内容相关性等指标。其中检索内容相关性最关键且可控,对应RAG管道前1-7部分及编码器/排序器微调,而响应合成和LLM微调则侧重答案相关性与基于性。
Q&A
标准RAG的基本流程是什么?
标准RAG流程包括:将文本分割成小块,使用Transformer编码器模型将小块转换为向量,将向量汇总到索引中,然后对用户查询进行向量化,在索引中搜索最相关的前k个结果,提取对应的文本块作为上下文,最后将上下文和查询整合到提示中,指导大语言模型生成答案。
高级RAG中有哪些改进检索质量的技术?
高级RAG中改进检索质量的技术包括:分层索引(先摘要后细节)、假设性问题与HyDE(生成假设问题或答案提升语义匹配)、语境增强(句子窗口检索和自动合并检索)、融合检索或混合搜索(结合关键词和向量搜索)、重新排名与过滤(使用交叉编码器或LLM重排结果)、查询变换(子查询、回溯提示、查询重写)以及查询路由(动态选择数据源或处理方式)。
句子窗口检索和自动合并检索有什么区别?
句子窗口检索将文档每个句子单独编码,检索到最相关句子后,前后扩展k个句子作为上下文送给LLM。自动合并检索(父文档检索)将文档分割成层次化块结构,检索最小的叶子块,如果多个叶子块指向同一父块,则用父块替换它们作为上下文。两者都通过检索小块但提供更大上下文来提升效果,但后者基于块之间的父子关系进行合并。
查询变换有哪些常见方法?
查询变换常见方法包括:子查询(将复杂查询拆分为多个简单子查询并行检索)、回溯提示(生成更广泛的查询以获取高层次上下文)、查询重写(用LLM重新构造初始查询以提高检索效果)。这些方法利用LLM的推理能力优化查询,从而提升检索质量。
如何对RAG系统中的模型进行微调?
RAG系统微调涉及三个部分:编码器微调(提升嵌入质量,如对bge-large-en-v1.5微调可提升检索质量约2%)、排序器微调(使用交叉编码器对检索结果重排,成对比较得分可提高4%)、大语言模型微调(如用GPT-4生成的数据微调GPT-3.5-turbo,忠实度提高5%;或采用RA-DIT方法同时调整LLM和检索器)。
RAG系统评估常用哪些指标?
RAG系统评估常用指标包括:答案的相关性、答案的基于性(答案在多大程度上得到上下文支持)、真实性、检索内容的相关性(上下文精准度和召回率)。RAG三元组评估模式涵盖检索内容相关性、答案基于性和答案相关性。此外,检索器评估还可使用命中率、平均倒数排名(MRR)等。
