


BM42:混合搜索的新基准
内容提要
BM42是对BM25的改进,结合了IDF和变换器的注意力机制,适用于现代检索系统。BM25在文本检索中有效,但在短文档和RAG系统中表现不佳。BM42通过利用变换器的语义信息,提升了检索速度和准确性,适合多语言支持。
延伸解读
BM42 的适用场景与限制
BM42 针对短文档和 RAG 场景优化,在问答任务中表现优于 BM25。但文章明确指出,对于未分块的长文档,BM25 可能仍是更好选择。此外,BM42 并非万能,实际部署中建议与稠密向量结合,形成混合搜索,以兼顾精确匹配和语义匹配。
BM42 与 SPLADE 的对比
SPLADE 依赖端到端训练,但存在分词器不适用、词元扩展开销大、领域依赖强和推理慢等问题。BM42 则利用变换器的注意力机制提取词重要性,无需额外训练,支持多语言,且推理速度更快、内存占用更低。不过,SPLADE 在域内准确率上仍有优势。
BM42 的实现机制
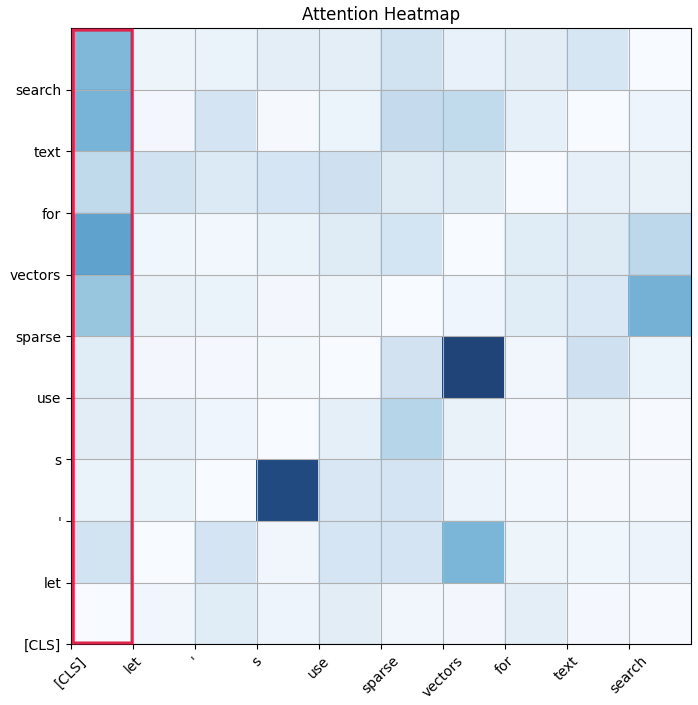
BM42 的评分公式结合了 IDF 和变换器注意力权重。它通过 [CLS] 标记的注意力行获取词重要性,并采用反向词元化将子词合并为完整词,从而减少稀疏向量的维度。IDF 计算由 Qdrant 引擎内置,支持流式更新。
基准测试表现
在 Quora 数据集上,BM42 的 Precision@10 为 0.49,高于 BM25 的 0.45;Recall@10 为 0.85,低于 BM25 稀疏实现的 0.89。平均向量大小仅 5.6 个元素,53 万文档的索引约 13MB。这表明 BM42 在短文本检索中具有竞争力,但召回率并非全面领先。
Q&A
BM42与BM25相比有什么改进?
BM42结合了IDF和变换器的注意力机制,提升了检索速度和准确性,尤其在短文本和问答任务中表现更佳。
BM42如何处理多语言文本?
BM42适合多语言支持,可以处理不同语言的文本,只要有相应的变换器模型。
BM42的评分公式是怎样的?
BM42的评分公式为:score(D,Q) = ∑ IDF(q_i) × Attention(CLS, q_i),结合了IDF和变换器的注意力矩阵。
BM42在短文本检索中表现如何?
BM42在短文本检索中表现优于BM25,特别是在问答任务中,能够更准确地匹配相关信息。
BM42的实现需要额外训练吗?
BM42的实现不需要额外的训练,可以使用任何变换器模型。
BM42如何解决传统变换器的词元化问题?
BM42通过反向词元化技术解决了传统变换器在检索任务中的词元化问题,能够合并子词的注意力权重。
