


提升向量搜索:使用PostgresML和LlamaIndex进行重新排序
内容提要
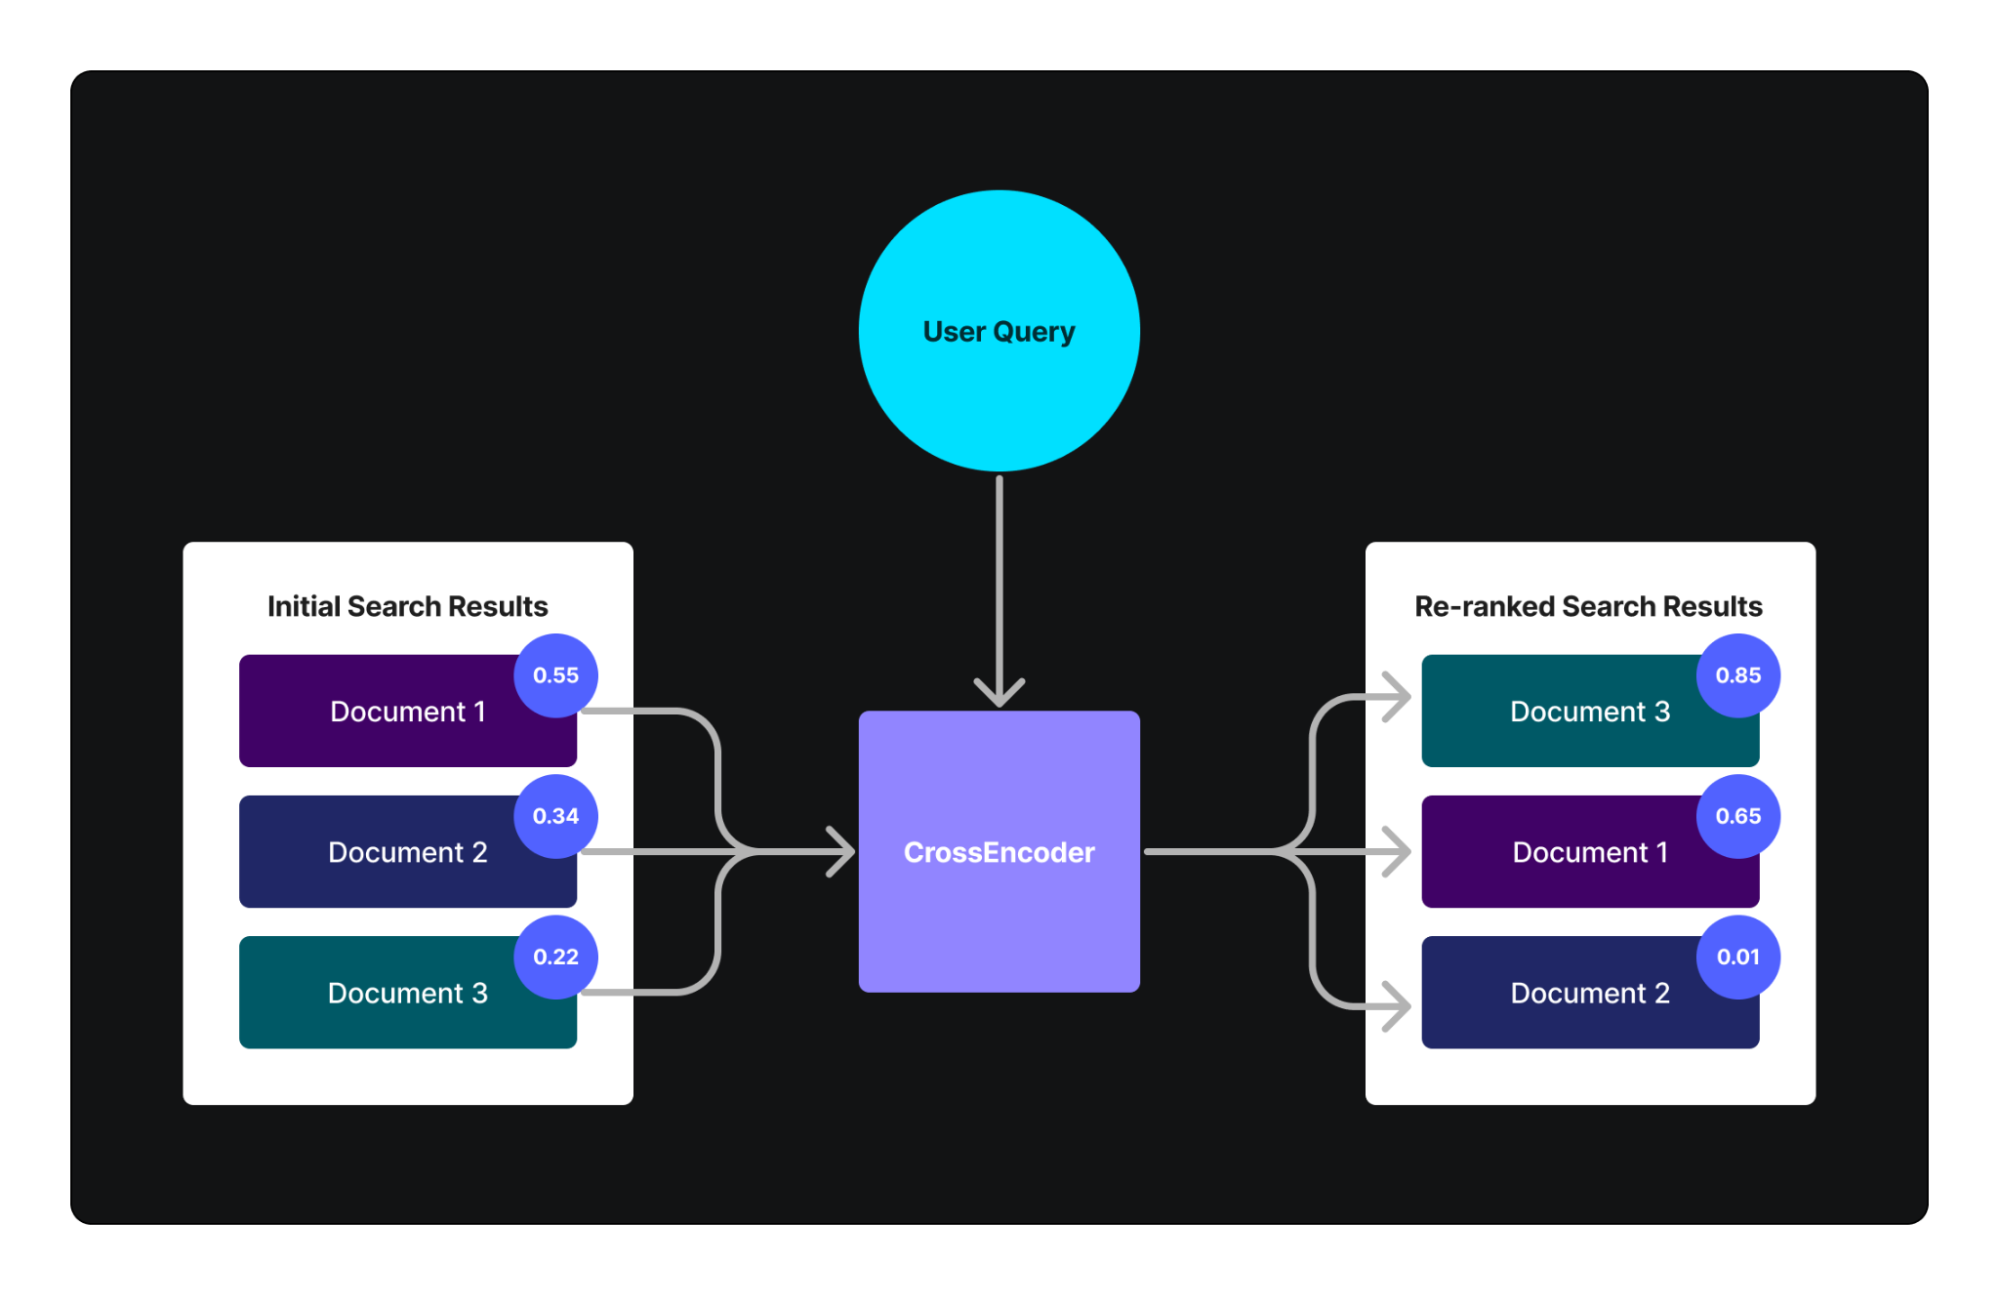
关键词搜索和语义搜索是提高搜索结果相关性的有效方法。传统重新排序依赖于历史用户交互数据,而交叉编码器是一种高级替代方法,能够评估新的、未见过的数据。交叉编码器通过解决深度文本分析中的限制,提高重新排序系统的性能。
延伸解读
交叉编码器重排序的适用场景与限制
交叉编码器直接比较查询与文档对,无需预计算嵌入,因此对新颖或特定内容效果显著。但它计算成本高,不适合大规模搜索,仅适用于对初步检索结果进行重排序。文章示例中,先通过语义搜索获取100个候选,再用交叉编码器重排,平衡了效率与精度。
PostgresML托管索引简化了RAG流程
使用PostgresML托管索引,文档的存储、分割、嵌入和查询均在数据库内完成,无需额外预处理。开发者只需提供数据库连接字符串,即可通过LlamaIndex构建索引和检索器。重排序也由数据库内交叉编码器处理,无需调用第三方API,降低了架构复杂度。
重排序在RAG中的实际效果
文章示例显示,未重排序时,语义搜索返回的文档虽相关但未直接回答问题;加入交叉编码器重排序后,顶部文档直接包含答案。在RAG查询中,重排序使生成的回答精确匹配问题。这表明重排序能显著提升检索增强生成应用的答案质量。
Q&A
什么是关键词搜索和语义搜索,它们有什么区别?
关键词搜索通过精确匹配查询词与数据库内容,而语义搜索则利用自然语言处理和机器学习理解查询的上下文和意图。
传统的重新排序方法有什么局限性?
传统的重新排序依赖于历史用户交互数据,处理新内容时效果不佳,并且需要大量数据进行有效训练。
交叉编码器是如何提高搜索结果相关性的?
交叉编码器通过直接比较查询-结果对来评估相似性,特别擅长处理新数据,无需大量用户交互数据进行微调。
如何使用LlamaIndex和PostgresML进行重新排序?
可以通过创建PostgresML索引并使用交叉编码器进行重新排序,具体步骤包括安装依赖、加载文档和配置检索器。
交叉编码器在处理新数据时的表现如何?
交叉编码器在处理新、未见过的数据时表现出色,能够有效评估相似性而不依赖于大量用户交互数据。
重新排序与交叉编码器结合使用有什么好处?
结合使用可以增强传统重新排序系统的性能,提供更精确的答案,特别是在检索增强生成应用中。
