

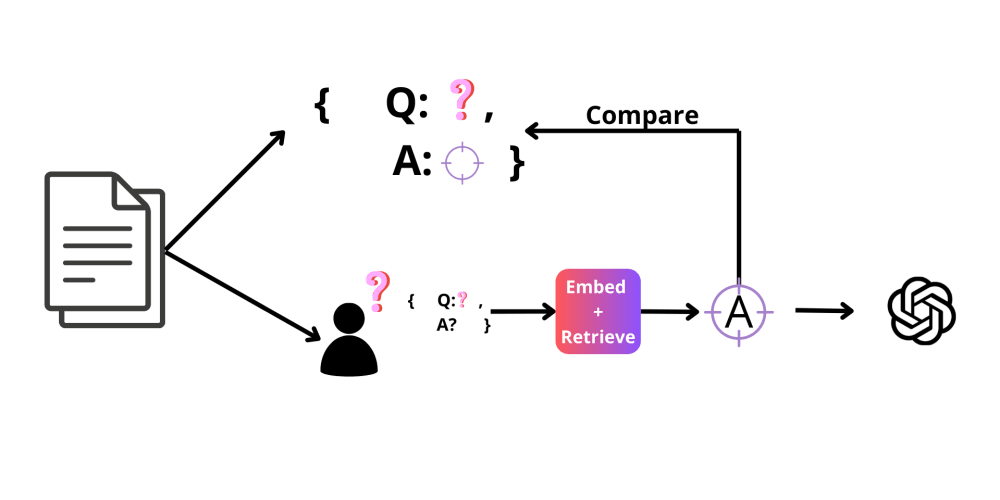

突破性的法律AI基准:LegalBench-RAG测试检索增强生成
内容提要
该文章介绍了LegalBench-RAG基准测试,用于评估法律领域中RAG系统的性能。该测试包括数据集、任务和评估指标。作者提供了最新的RAG模型在该测试上的基准结果,发现在法律推理和生成能力方面仍有改进空间。
延伸解读
法律AI评估的新标尺
LegalBench-RAG为法律领域的检索增强生成系统提供了首个标准化评估框架。它通过构建包含案例、法规等法律文档的数据集,并设计摘要生成、问题分析和结果预测等任务,使不同RAG模型能在统一标准下比较。这有助于研究者识别模型在法律推理和生成能力上的具体短板,推动该领域从随意测试走向可复现的基准评估。
当前模型的局限与改进方向
基准测试结果显示,即使最先进的RAG模型在法律推理和生成能力上仍有明显不足。这意味着模型可能难以准确理解复杂法律概念或生成符合专业要求的文本。未来研究需聚焦于如何更有效地利用法律知识库,提升模型对法律逻辑的把握,而非仅依赖通用语言能力。这为开发者指明了优化方向。
基准的覆盖范围与潜在偏差
文章指出LegalBench-RAG仅覆盖部分法律任务,数据集可能无法完全代表法律文档和推理的多样性。此外,人工评估可能引入主观偏差。因此,读者在解读基准结果时需注意其局限性,不能将模型表现直接等同于实际法律场景中的可靠性。后续研究应扩展任务类型并改进评估方法。
Q&A
什么是LegalBench-RAG基准测试?
LegalBench-RAG是一个用于评估法律领域中检索增强生成(RAG)系统性能的新基准测试。
LegalBench-RAG基准测试包含哪些任务?
基准测试包括生成法律案件的简明摘要、分析法律问题和预测案件结果等任务。
当前RAG模型在法律推理方面的表现如何?
当前的RAG模型在法律推理和生成能力方面仍有改进空间。
LegalBench-RAG基准测试的评估指标是什么?
评估指标包括自动评分(如ROUGE分数)和人工评估,以评估生成内容的连贯性和相关性。
LegalBench-RAG基准测试的局限性有哪些?
局限性包括只覆盖部分法律任务,数据集可能不完全代表法律文档的多样性,以及人工评估可能存在偏见。
LegalBench-RAG基准测试对未来研究有什么意义?
该基准测试为未来的研究和开发提供了标准化的方法,推动法律领域RAG系统的进步。
