


【多智能体强化学习】MADDPG 论文笔记
内容提要
本文介绍了多智能体强化学习中的MADDPG算法,该算法采用集中训练和分布式执行的框架。每个智能体拥有独立的actor和critic网络,actor使用局部信息,critic利用全局信息进行判断。MADDPG适用于合作和竞争环境,有效解决了传统强化学习在多智能体环境中的不稳定性问题,并讨论了其模型结构及扩展方法。
延伸解读
集中训练与分散执行:MADDPG 的核心设计
MADDPG 采用集中训练、分散执行的框架。训练时,每个智能体的 critic 网络可以获取所有智能体的动作和观测等全局信息,从而更准确地评估动作价值;而 actor 网络仅依赖局部观测,执行时也仅使用局部信息。这种设计既利用了全局信息来稳定训练,又保证了执行阶段的分散性,使智能体无需通信即可独立行动。
应对多智能体环境的不稳定性
在多智能体环境中,每个智能体的策略都在不断变化,导致环境对其他智能体而言变得不稳定,传统强化学习难以直接应用。MADDPG 通过集中式的 critic 来缓解这一问题:critic 在训练时能看到所有智能体的动作,从而更稳定地估计价值函数。此外,每个智能体拥有独立的奖励函数,可以适应合作、竞争或混合场景中的不同目标。
模型扩展:策略推断与策略集合
MADDPG 提出了两种扩展。一是推断其他智能体的策略:每个智能体可以学习其他智能体策略的估计,从而在 critic 中替代真实动作,减少对全局信息的依赖。二是训练由多个子策略组成的策略集合:每个子策略拥有独立的经验回放池并单独训练,以增强应对环境非平稳性的能力。这些扩展增加了模型的复杂性和学习负担。
代码实现要点:Critic 与 Actor 的更新
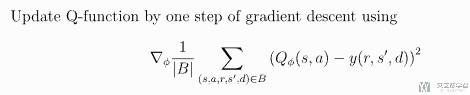
在代码实现中,Critic 的更新通过计算 TD 误差进行,目标值由目标 Critic 网络根据目标动作和状态计算得到。Actor 的更新则通过策略梯度,利用 Critic 对采样动作的 Q 值进行优化,并加入策略分布的熵正则项以鼓励探索。参考实现如 EPyMARL 中的 maddpg_learner.py,但未包含原文中的两个扩展。
Q&A
MADDPG算法的基本框架是什么?
MADDPG算法采用集中训练和分布式执行的框架,基于actor-critic结构。
MADDPG如何解决多智能体环境中的不稳定性问题?
MADDPG通过让每个智能体的策略在执行时仅依赖于局部信息,避免了环境的不稳定性。
MADDPG算法适用于哪些环境?
MADDPG适用于合作和竞争环境,能够处理相互冲突的奖励结构。
MADDPG的critic网络与actor网络有什么不同?
critic网络利用全局信息进行判断,而actor网络仅使用局部信息。
MADDPG的扩展方法有哪些?
MADDPG的扩展包括推断其他智能体的策略和训练由不同子策略组成的策略集合。
MADDPG如何处理智能体之间的相互作用?
MADDPG允许每个智能体有不同的奖励结构,以适应竞争环境中的相互冲突奖励。
