


使用LlamaIndex评估RAG系统的理想chunk_size
内容提要
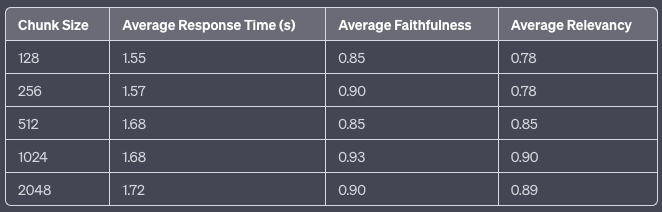
检索增强生成(RAG)系统的关键参数是chunk_size。选择合适的chunk_size对系统的效率和准确性有重要影响。较小的chunk_size提供更细致的信息,但可能遗漏重要内容;较大的chunk_size则确保信息的完整性。通过LlamaIndex的响应评估模块,可以评估响应时间、准确性和相关性,以确定最佳chunk_size。实验结果显示,chunk_size为1024时,响应时间和质量达到最佳平衡。
延伸解读
chunk_size 如何影响 RAG 的准确性与速度
文章指出,chunk_size 的选择直接关系到检索的粒度与完整性。较小的 chunk_size(如 128)能提供更细粒度的信息,但若 similarity_top_k 设置较小(如 2),关键信息可能不在检索结果中,导致回答遗漏。较大的 chunk_size(如 512)则更可能包含所有必要信息,但会增加输入 LLM 的文本量,从而拖慢响应速度。因此,需要在信息覆盖与响应速度之间权衡。
用 LlamaIndex 评估模块量化 chunk_size 效果
文章使用 LlamaIndex 的 FaithfulnessEvaluator 和 RelevancyEvaluator 来评估不同 chunk_size 下的回答质量。Faithfulness 衡量回答是否基于检索到的上下文(避免幻觉),Relevancy 衡量回答是否切题。同时记录平均响应时间。通过遍历 chunk_size 列表(128、256、512、1024、2048),计算每个尺寸下的三项指标,从而基于数据选择最佳值。
实验结论:1024 是平衡点,但并非通用答案
在文章的实验设置下(Uber 2021 年 10-K 文件,GPT-3.5 生成回答,GPT-4 评估),chunk_size 为 1024 时,Faithfulness 和 Relevancy 均达到峰值,且响应时间仅略有增加。这表明 1024 在该数据集上实现了响应时间与回答质量的最佳平衡。但文章也强调,最佳 chunk_size 取决于具体用例和数据集,需通过实验确定。
Q&A
什么是chunk_size,它在RAG系统中有什么重要性?
chunk_size是RAG系统中的一个关键参数,它影响系统的效率和准确性。选择合适的chunk_size可以确保信息的完整性和系统的响应速度。
较小的chunk_size和较大的chunk_size有什么区别?
较小的chunk_size提供更细致的信息,但可能遗漏重要内容;而较大的chunk_size则确保信息的完整性。
如何使用LlamaIndex评估最佳的chunk_size?
可以通过LlamaIndex的响应评估模块,评估不同chunk_size下的响应时间、准确性和相关性,以确定最佳的chunk_size。
实验结果显示哪个chunk_size的响应时间和质量达到最佳平衡?
实验结果显示,chunk_size为1024时,响应时间和质量达到最佳平衡。
选择chunk_size时需要考虑哪些因素?
选择chunk_size时需要在捕获所有必要信息和保持系统响应速度之间找到平衡。
LlamaIndex的响应评估模块有哪些功能?
LlamaIndex的响应评估模块可以评估响应时间、准确性和相关性,以帮助确定最佳的chunk_size。
