
OpenAI 如何构建 GPT-Live
内容提要
OpenAI的GPT-Live-1采用全双工架构,可边听边说,取消轮次检测,使对话更自然。系统将说话与思考分离:小型语音模型负责实时对话,前沿模型处理推理与工具调用。服务分实时音频路径和异步路径,并通过WARP、GPU状态保持、实例交接等优化延迟。评估关注对话行为、流健康与真实流量,需按p999设计。
延伸解读
全双工架构如何解决轮次检测的痛点
传统语音助手依赖轮次检测器判断用户是否说完,但检测过早会打断用户,过晚则造成延迟。GPT-Live采用全双工架构,模型持续处理输入并生成输出,静音也作为一种令牌,从而完全移除轮次检测器。这使得对话更自然,减少了意外打断,但代价是模型必须始终运行,对服务系统提出更高要求。
说话与思考分离:速度与质量的平衡
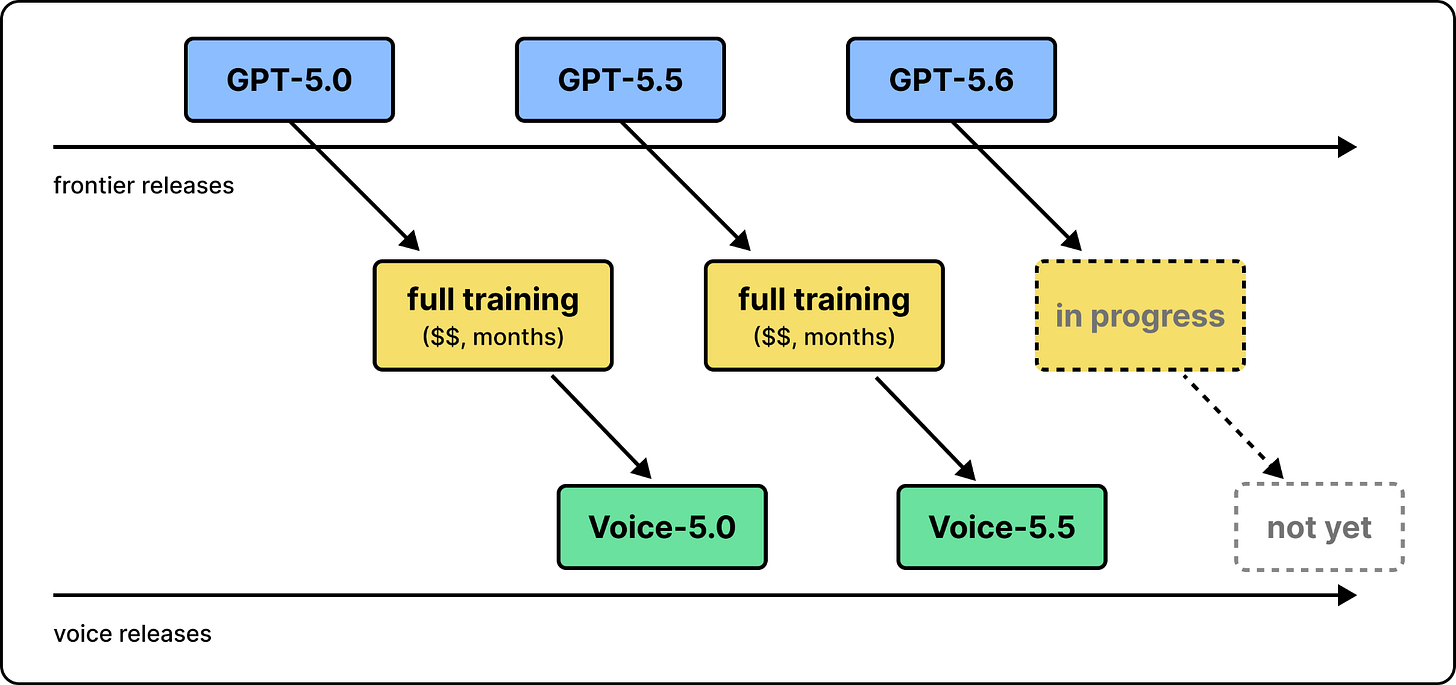
GPT-Live将对话与推理分离:小型语音模型负责实时对话,前沿模型处理复杂推理和工具调用。当用户提问需要外部信息时,语音模型会委托给前沿模型,同时继续与用户交谈,避免沉默。这种设计既保证了响应速度,又获得了高质量答案,并且更换前沿模型时只需较少工程改动。
实时路径的工程优化:WARP与实例交接
为确保音频低延迟传输,OpenAI将服务分为实时路径和异步路径。实时路径采用WARP协议将WebRTC连接建立从六次往返压缩到一次,并让对话状态常驻GPU内存,避免重复读取历史。当模型实例需要更换时,系统会预先加载对话到新实例再切换,保证对话不中断。这些优化共同维持了实时音频的流畅性。
全双工系统的评估挑战:从p95到p999
全双工模型没有明确的轮次,评估需关注对话行为(如端点检测和打断识别)和流健康度。由于模型持续运行,p95延迟事件会频繁出现,因此系统必须按p999设计,并具备快速恢复能力。此外,通过静默发布将少量真实流量导入新系统,可以发现在常规测试中难以暴露的瓶颈,例如CPU侧服务先于GPU达到容量上限。
Q&A
GPT-Live-1 的全双工架构是如何实现边听边说的?
GPT-Live-1 采用全双工架构,模型持续产生音频 token,当需要保持沉默时输出静音 token,同时持续处理输入音频 token。这样模型可以同时听和说,取消了轮次检测器,使对话更自然。
GPT-Live 如何将说话与思考分离?
GPT-Live 使用一个小型语音模型负责实时对话,另一个前沿模型(如 GPT-5.5)处理推理和工具调用。语音模型在需要时委托前沿模型,同时继续与用户对话,从而兼顾速度与质量。
GPT-Live 的服务系统分为哪两条路径?各自负责什么?
分为实时音频路径和异步路径。实时路径只传输音频,确保音频帧按固定时钟快速移动;异步路径处理非音频任务,如委托和工具调用,这些任务可以容忍更长延迟。
OpenAI 用了哪些技术来优化实时音频路径的延迟?
主要技术包括:WARP 协议将 WebRTC 的六次往返压缩为一次;保持 GPU 状态,让会话常驻模型实例,避免重复读取历史;以及实例交接机制,在切换模型实例时预先加载对话,实现无缝迁移。
为什么全双工语音系统的评估需要按 p999 设计?
因为全双工模型持续运行,p95 事件每 20 次推理就发生一次,p99 事件也频繁出现。用户会听到最差的帧,所以系统必须按 p999 设计,并确保快速恢复,以应对每个会话中必然出现的慢帧。
GPT-Live 的静默发布(silent launch)发现了什么重要问题?
在静默发布中,团队发现一个 CPU 侧服务比 GPU 更早耗尽容量。这种问题通常难以通过普通测试发现,静默发布能安全地在真实流量中暴露瓶颈。
从 GPT-Live 的构建中,其他团队可以学到哪些工程经验?
关键经验包括:实时服务中用户听到最差帧,因此尾部延迟比平均延迟更重要;容量规划应以并发会话数而非请求数衡量;应尽量将复杂性移入模型内部,外部组件保持小而专注。
