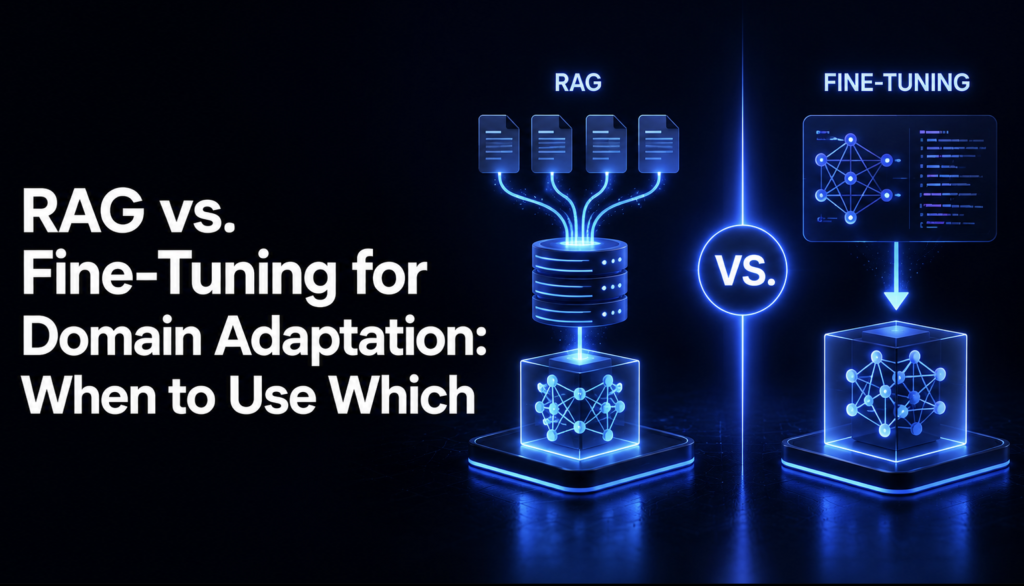

RAG与微调在领域适配中的对比:何时使用哪种方法
内容提要
RAG通过检索外部知识增强模型输入,不改变权重,适合信息量大或频繁变化的场景,且答案可溯源。微调则训练模型权重,用LoRA等低成本方法让模型稳定掌握特定风格、格式或术语,但不擅长注入事实知识。约六成生产系统两者并用:RAG管“知道什么”,微调管“如何表现”。建议先上RAG,再针对持续行为问题微调。
延伸解读
机制差异决定适用边界
RAG不改变模型权重,只改变模型在推理时看到的上下文,因此擅长处理信息量大或频繁变化的知识,且答案可溯源。微调则训练模型权重,用LoRA等方法让模型稳定掌握特定风格、格式或术语,但不擅长注入事实知识。理解这一根本差异,是避免选错技术路线的第一步。
微调不是知识注入工具
文章强调,微调不会可靠地增加事实知识。即使模型在大量医学文献上微调,它也不会像检索系统那样真正“知道”这些事实,尤其是细粒度事实。微调调整的是风格、结构和模式识别,是行为工具而非知识工具。若需要模型掌握具体事实,应优先考虑RAG。
生产系统常两者并用
约六成生产LLM部署同时使用RAG和微调,因为两者解决不同问题:RAG管“知道什么”,微调管“如何表现”。建议先上RAG,因为它通常是更快得到可用版本的路径;仅当存在持续的行为问题,且提示工程和检索优化都无法解决时,再考虑微调。
决策框架的六个关键问题
文章给出六点决策框架:信息是否频繁变化或过大?是否需要答案可溯源?是否缺乏标注数据或需快速上线?是否需要稳定遵循语气、结构或术语?延迟预算是否紧张?查询量是否高到小模型微调更划算?前三点倾向RAG,后三点倾向微调。
Q&A
RAG和微调在机制上有什么根本区别?
RAG不改变模型权重,只在推理时通过检索外部知识库,把相关文档和用户问题一起交给模型,让模型基于这些资料回答。微调则直接训练模型权重,用输入输出示例让模型把某种行为模式内化,推理时无需额外注入信息。
微调能可靠地给模型注入新的事实知识吗?
不能。微调主要调整模型的风格、结构和模式识别能力,对事实性知识的记忆并不可靠,尤其是细粒度事实。如果目标是让模型掌握大量或频繁变化的事实,应该用RAG而不是微调。
什么情况下应该优先选择RAG而不是微调?
当信息量大、变化频繁、需要答案可溯源,或者还没有标注训练数据、需要快速上线时,应优先用RAG。RAG几乎总是更快得到可用第一版的路径。
什么情况下应该选择微调而不是RAG?
当模型需要稳定遵循特定语气、结构或术语,而提示词在高并发下无法保持一致性时;当延迟预算紧张,无法承受每次检索的额外开销时;或者当查询量足够大,用更小的微调开源模型比调用前沿API更省钱时,应选择微调。
生产系统中RAG和微调通常是怎么配合使用的?
约60%的生产LLM部署同时使用两者。RAG负责“知道什么”,即提供事实和最新信息;微调负责“如何表现”,即控制风格、格式和术语。两者解决不同问题,很多领域适配项目同时存在这两类需求。
LoRA微调为什么成本低、速度快?
LoRA只训练一个小的适配器,通常不到基础模型总参数的1%,基础模型权重保持冻结。这样一次微调只需几百美元和几小时,而不是全量重训练项目。
在领域适配项目中,推荐的实施顺序是什么?
建议先上RAG,因为它几乎总是更快得到可用结果。只有当出现具体、持续的行为问题,且更好的提示词和更好的检索都无法解决时,再针对该问题添加微调。
