


使用LangChain和Qdrant构建问答系统
内容提要
本文介绍用LangChain和Qdrant构建问答系统。针对大模型缺乏事实依据的问题,采用向量检索增强生成:先用FastEmbed将知识库文本向量化存入Qdrant,查询时检索最相关文档,与问题组成提示词交给Claude或GPT生成答案。以Natural Questions数据集为例,演示配置、建库、LCEL组合检索链及测试的完整流程。
延伸解读
双模型分工:嵌入与生成各司其职
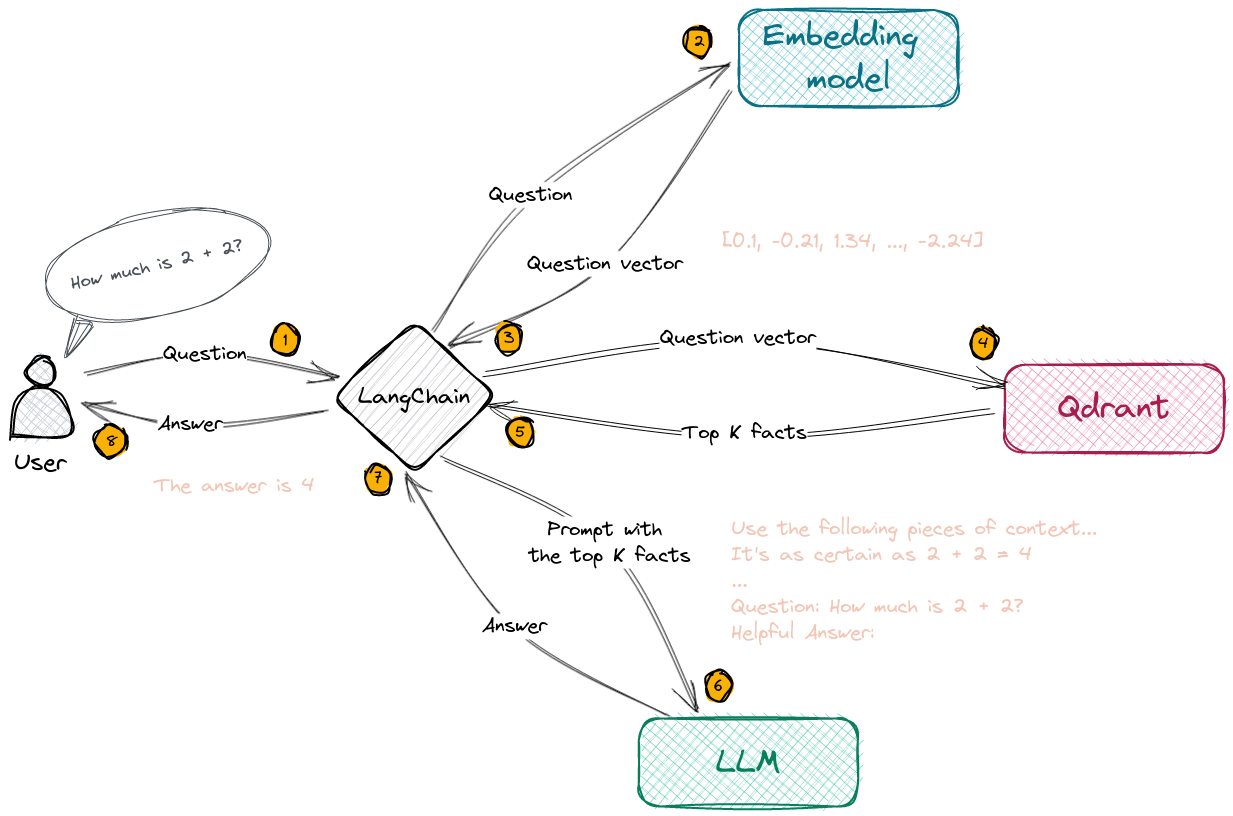
文章强调问答系统需要两个模型:嵌入模型负责将知识库文本转换为向量并存入Qdrant,用于语义检索;生成模型(如Claude或GPT)则根据检索到的上下文和问题生成答案。这种分工是因为嵌入模型擅长特征提取,而生成模型擅长文本生成与总结。两者结合,既弥补了大模型缺乏事实依据的短板,又发挥了向量检索高效筛选相关文档的优势。
FastEmbed:轻量级本地嵌入方案
文章选用FastEmbed作为嵌入模型,默认使用BAAI/bge-small-en-v1.5,这是一个小型量化模型,可在CPU上流畅运行,无需完整的PyTorch或TensorFlow环境。由于langchain-community中的FastEmbedEmbeddings包装器即将弃用,文章建议直接包装FastEmbed的TextEmbedding类,以保持依赖的现代性。这为资源有限或希望本地部署的开发者提供了实用选择。
LCEL链式组合:简洁的检索增强生成流程
文章使用LangChain表达式语言(LCEL)将检索器、提示模板和聊天模型组合成一条链。通过管道符|,可以清晰定义数据流向:检索器获取相关文档,格式化后填入提示模板,再交给模型生成答案。这种声明式写法减少了样板代码,且易于切换模型提供商(如从Claude换到GPT),只需更改模型名称即可,无需重写整个流程。
知识库可扩展性与检索依赖
文章指出,该架构的知识库可以轻松扩展新事实,这些新内容会自动被纳入后续提示中。但前提是,新事实与用户问题的相似度必须足够高,才能被Qdrant检索到并返回在顶部结果中。这意味着系统的回答质量高度依赖检索环节的准确性,如果检索不到相关文档,生成模型可能无法给出正确答案,甚至按提示要求回答“我不知道”。
Q&A
为什么用LangChain和Qdrant构建问答系统需要两个模型?
因为两个模型解决不同任务:第一个是嵌入模型,将文本转换为向量,用于检索;第二个是聊天模型,用于文本生成或摘要。
如何用LangChain和Qdrant实现检索增强生成?
先用嵌入模型将知识库文本向量化存入Qdrant,查询时检索最相关文档,与问题组合成提示词交给聊天模型生成答案。
构建问答系统时如何配置Qdrant和聊天模型?
设置环境变量QDRANT_URL和QDRANT_API_KEY,以及所选聊天模型的API密钥(如ANTHROPIC_API_KEY或OPENAI_API_KEY)。
如何使用FastEmbed和Qdrant构建知识库?
用FastEmbed将答案文本向量化,然后通过QdrantVectorStore.from_texts将向量和文本存入Qdrant集合。
如何用LCEL组合检索链?
使用管道符|将检索器、提示模板、聊天模型和输出解析器组合成链,例如:chain = ({"context": retriever | format_docs, "question": RunnablePassthrough()} | prompt | llm | StrOutputParser())。
如何测试构建的问答链?
从数据集中随机选择问题,调用chain.invoke(question)并打印答案,观察模型基于上下文生成的回答。
