
深入探讨Cloudflare的万亿消息Kafka基础设施
内容提要
Cloudflare的Kafka基础设施最近达到了处理1万亿条消息的里程碑。Cloudflare自2014年以来一直在使用Kafka,目前运行着14个Kafka集群。他们最初使用Kafka来解耦服务并启用重试机制。为了强制执行消息合同,Cloudflare采用了Protocol Buffers(Protobuf)。他们还开发了一个内部的Go消息总线客户端库,以简化Kafka的使用。Cloudflare的应用服务团队开发了一个连接器框架,以抽象常见模式并简化数据同步流水线。Cloudflare在Kafka采用过程中面临了扩展挑战,包括可见性、嘈杂的值班体验以及无法跟上高消息产生速率。他们通过增强SDK的Prometheus指标、实施健康检查和引入批量消费来解决这些挑战。Cloudflare的经验为在配置和简化之间取得平衡、确保分布式系统的可见性以及建立生产者和消费者之间的明确合同提供了宝贵的教训。
延伸解读
消息合同与主题映射的权衡
Cloudflare 采用 Protobuf 强制消息合同,并规定每个 Kafka 主题只能包含一种 Protobuf 消息类型。这种一对一映射避免了单一主题内多格式的混乱,提升了开发体验和可靠性,但代价是主题、分区和副本数量大幅增加,影响资源利用率。这一决策体现了在简化开发与运维成本之间的权衡,适合需要严格消息契约的场景。
可观测性:从指标到智能健康检查
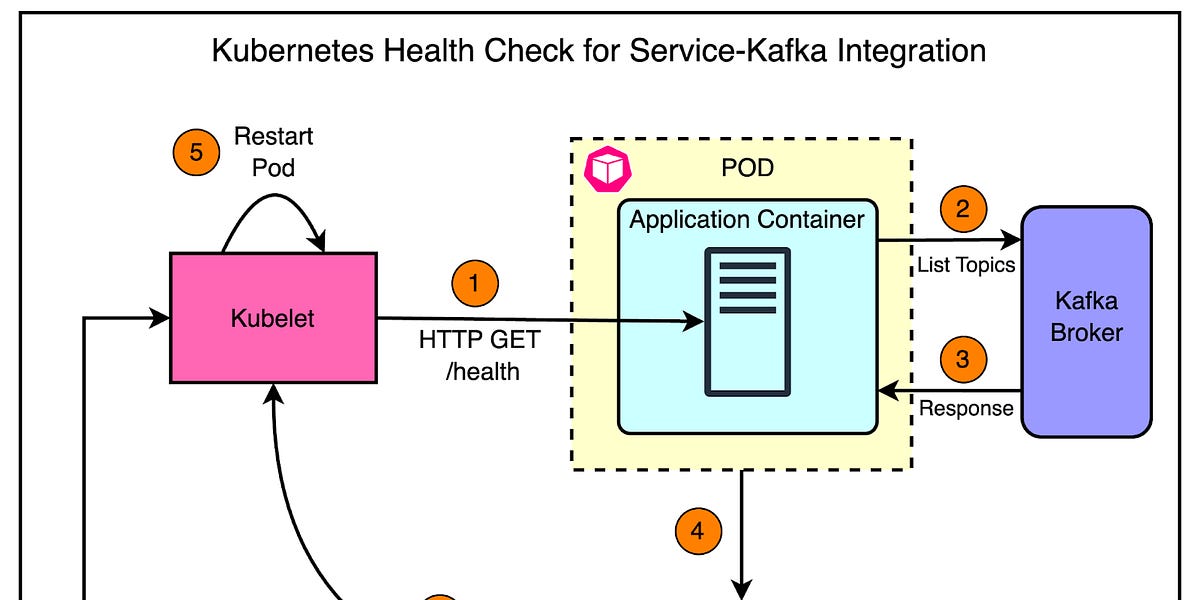
面对审计日志管道的性能问题,Cloudflare 在 SDK 中增强了 Prometheus 指标,并使用直方图测量各阶段耗时,结合 OpenTelemetry 定位瓶颈。随后,为减少噪音告警,他们实现了基于偏移量比较的智能健康检查:通过对比当前偏移量与已提交偏移量,判断消费者是否卡住。这种方法能自动重启不健康的消费者,改善值班体验,并确保高吞吐下日志及时交付。
批量消费提升邮件系统吞吐量
邮件系统原本逐条消费消息,在流量高峰时积压严重。Cloudflare 引入批量消费,允许消费者每次拉取可配置数量的消息,并配合批量数据库插入和并行邮件发送。在一次产品发布引发注册激增时,该系统成功处理了大量验证邮件,证明了批量消费在高生产速率场景下的有效性。这为类似消息处理系统提供了可借鉴的优化模式。
Q&A
Cloudflare的Kafka基础设施达到了什么里程碑?
Cloudflare的Kafka基础设施最近达到了处理1万亿条消息的里程碑。
Cloudflare为什么选择使用Kafka?
Cloudflare选择使用Kafka是为了解耦服务并启用重试机制。
Cloudflare如何解决Kafka扩展过程中的可见性问题?
Cloudflare通过增强SDK的Prometheus指标和实施健康检查来解决可见性问题。
Cloudflare在Kafka中使用了什么技术来强制执行消息合同?
Cloudflare采用了Protocol Buffers(Protobuf)来强制执行消息合同。
Cloudflare是如何简化Kafka使用的?
Cloudflare开发了一个内部的Go消息总线客户端库,以简化Kafka的使用。
Cloudflare在Kafka采用过程中面临了哪些挑战?
Cloudflare面临的挑战包括可见性、嘈杂的值班体验和无法跟上高消息产生速率。
