

利用语言模型挖掘人类偏好 [译]
内容提要
文章提出生成式主动任务探询(GATE)框架,使语言模型通过开放式提问和生成边缘案例主动挖掘用户的模糊偏好,并据此预测用户决策。在内容推荐、道德推理和邮箱验证三个领域的实验中,GATE 的准确率优于或相当于用户自写提示、监督学习和主动学习,且用户心理负担更低,为复杂偏好对齐提供了新工具。
延伸解读
GATE 的核心思路:让模型主动提问
GATE 框架的核心是让语言模型通过开放式提问和生成边缘案例,主动挖掘用户的模糊偏好。与用户自己写提示或标注示例相比,这种方式能更深入地触及用户未曾意识到的偏好细节。实验中,GATE 在内容推荐、道德推理和邮箱验证三个领域均表现出与用户自写提示相当或更好的效果,且用户心理负担更低。这提示我们,未来个性化系统的设计或许可以更多依赖模型的主动探询,而非完全依赖用户的事先表达。
偏好表达的难点与 GATE 的应对
文章指出,用户往往难以清晰、全面地表达自己的偏好,尤其是在涉及边缘情况或技术性较强的任务时。例如,在邮箱验证任务中,有用户最初认为邮箱应以 .com 或 .co.uk 结尾,但后来却接受了不符合该规则的地址。GATE 通过生成具体的边缘案例和开放式问题,帮助用户更准确地反思和澄清自己的真实偏好,从而减少因表达不清导致的模型误判。
实验证据与局限
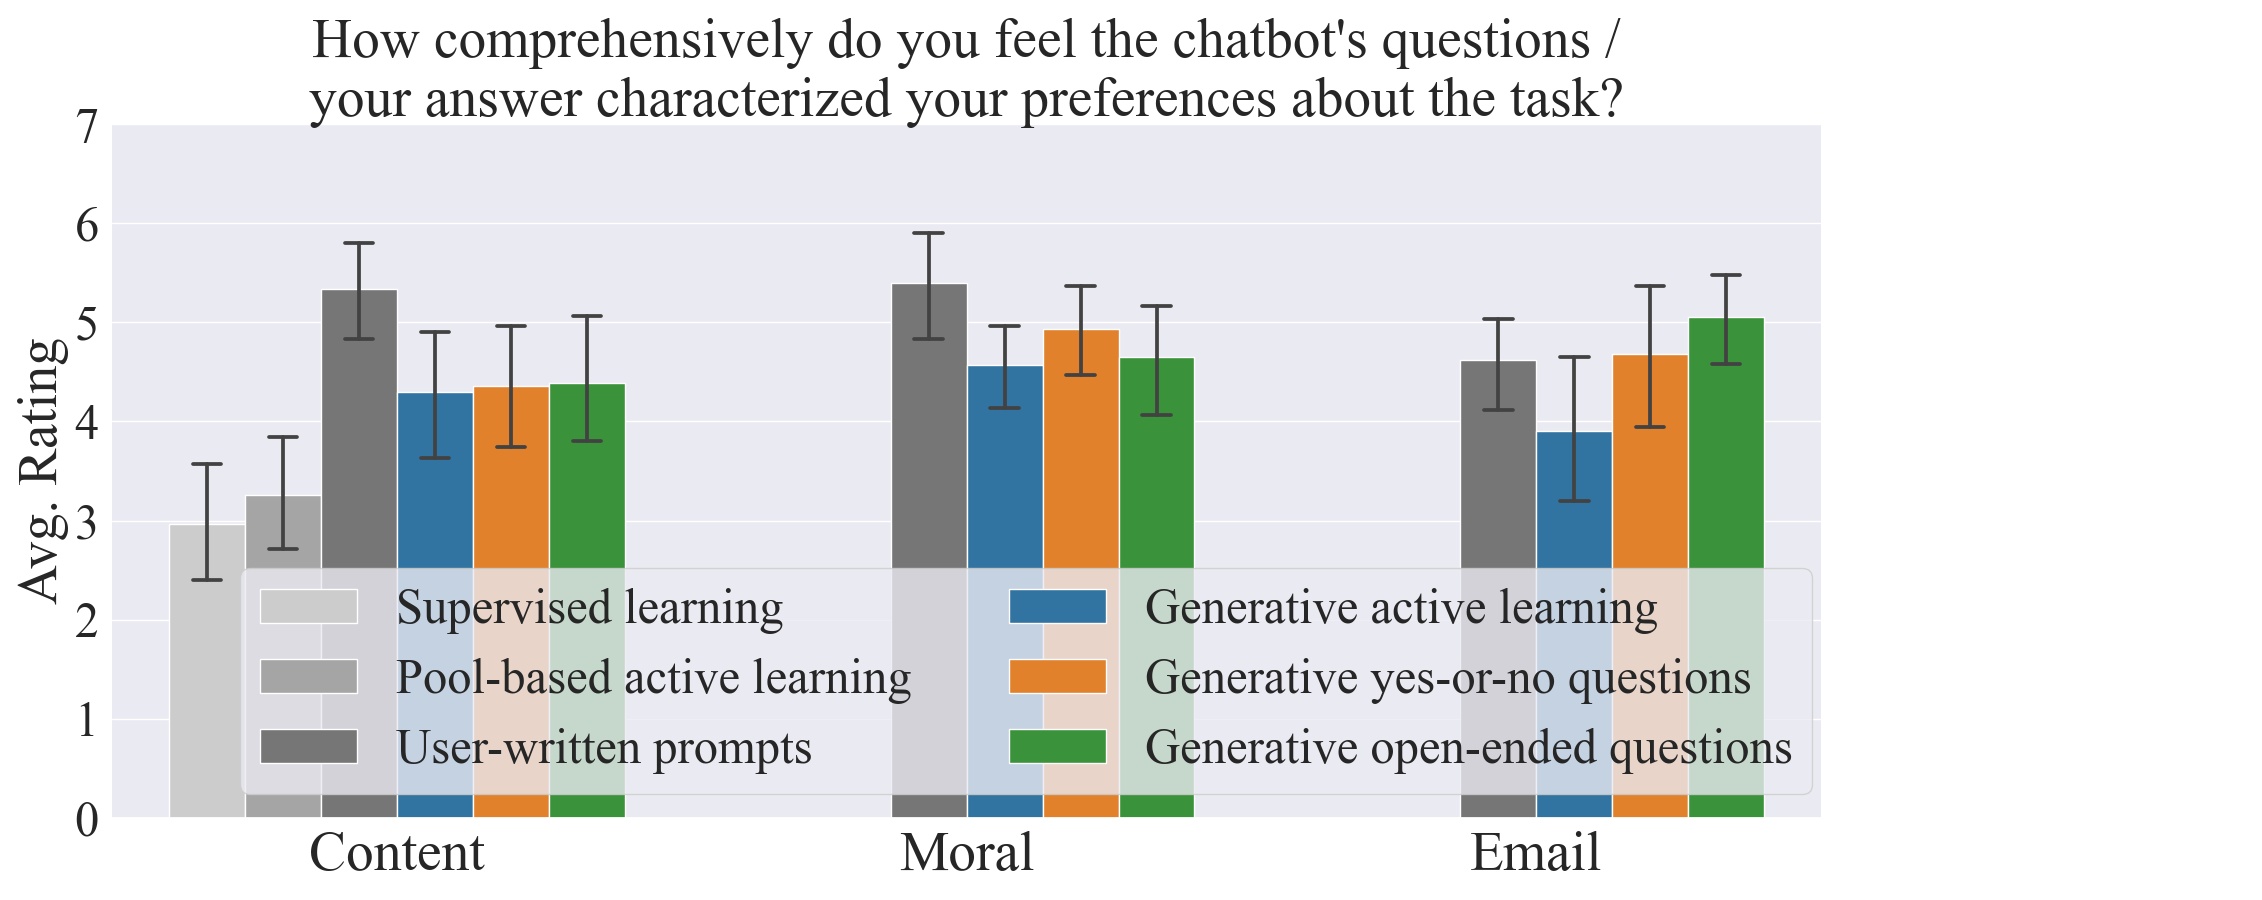
在三个领域的实验中,GATE 方法在多数情况下优于用户自写提示,并在内容推荐领域显著优于监督学习和基于池的主动学习。用户反馈显示,交互式探询的心理负担更低,且能带来新的思考角度。然而,研究也指出,由于样本量和预算限制,部分领域的统计显著性未能确立,且参与者均为说英语的美国人,偏好代表性有限。此外,道德推理任务较为简单,可能无法完全反映人类道德的复杂性。
潜在风险与未来方向
文章提到,GATE 框架存在隐私泄露和用户过度依赖模型预测的伦理风险。未来研究可以探索更原则性的引导方法、利用更大模型,或将其应用于更复杂的现实任务。同时,作者强调,对于涉及道德标准的系统,设计者需设立保护措施,防止任意制定道德标准。尽管 GATE 在模拟人类偏好方面展现出潜力,但在道德推理等微妙领域,模型模拟与真实人类行为的相关性较低,表明其尚不能完全替代人类参与者。
Q&A
GATE框架是什么?它主要解决什么问题?
GATE(生成式主动任务探询)是一个学习框架,让语言模型通过自由形式的互动(如提出开放式问题或生成边缘案例)来主动挖掘用户的模糊偏好,从而更准确地预测用户决策。它主要解决传统方法(如用户编写提示或标注示例)难以表达复杂、模糊偏好以及难以覆盖边缘情况的问题。
GATE框架在哪些领域进行了实验?效果如何?
GATE在内容推荐、道德推理和邮箱验证三个领域进行了实验。结果表明,GATE的准确率通常优于或相当于用户自写提示、监督学习和主动学习,并且用户心理负担更低。
GATE框架具体包含哪些探询策略?
GATE包含三种探询策略:生成式主动学习(语言模型生成示例让用户标注)、生成是非题(语言模型只生成是/否问题)和生成开放式问题(语言模型生成开放式问题,用户自由回答)。
与用户自己编写提示相比,GATE有哪些优势?
GATE在大多数情况下表现优于用户编写的提示,特别是在内容推荐领域显著优于监督学习和主动学习。此外,用户认为交互式探询的心理负担更低,并且能帮助用户意识到之前未考虑到的偏好方面。
GATE框架是否存在伦理风险或局限性?
是的,GATE存在潜在的伦理风险,包括隐私泄露和增加用户对模型预测的过度依赖。此外,研究局限于基于提示的方法,人类样本主要为说英语的美国人,且道德推理领域较为简单,可能无法完全捕捉人类道德的微妙性。
语言模型在GATE中是如何被使用的?
在GATE中,语言模型(如GPT-4)被用于两个角色:一是作为提问策略,根据交互历史生成信息丰富的问题或边缘案例;二是作为预测器,根据交互记录和测试样本预测用户对新样本的决策概率。
