语言模型的“形态”
内容提要
本文主张跳出仅修改harness适配模型的思路,探索改变语言模型的输入输出形态。作者认为decoder-only Transformer并非处理智能体轨迹的终极形态,可结合循环模型与Transformer,分别处理历史与当前观测,实现自动压缩与局部密集注意力。Jev等新形态证明替代权衡空间存在,需配套新目标函数。如今蒸馏与开放环境使这类研究更可行。
延伸解读
为何“模型形态”研究长期被忽视
文章指出,自ChatGPT发布以来,语言模型的输入输出形态基本未变,业界普遍围绕自回归解码器Transformer设计harness。原因在于:前沿实验室不愿偏离已验证的形态,且改变形态的试错成本极高;而调整harness来适配任务则便宜得多。因此,尽管模型架构研究活跃,但大多局限于层内细节,整体形态仍是解码器Transformer。
Jev的启示:替代权衡空间存在
Jev将输出空间显式约束为[0,1],采样时仅需prefill,在特定问题上极快。它并非比前沿模型更智能,但展示了改变模型形态可开辟不同权衡空间。作者认为,类似Jev的新形态需要配套新目标函数(如RLCD),这比单纯扩大规模更需创造力,也更有原则性。
智能体轨迹需要怎样的模型形态
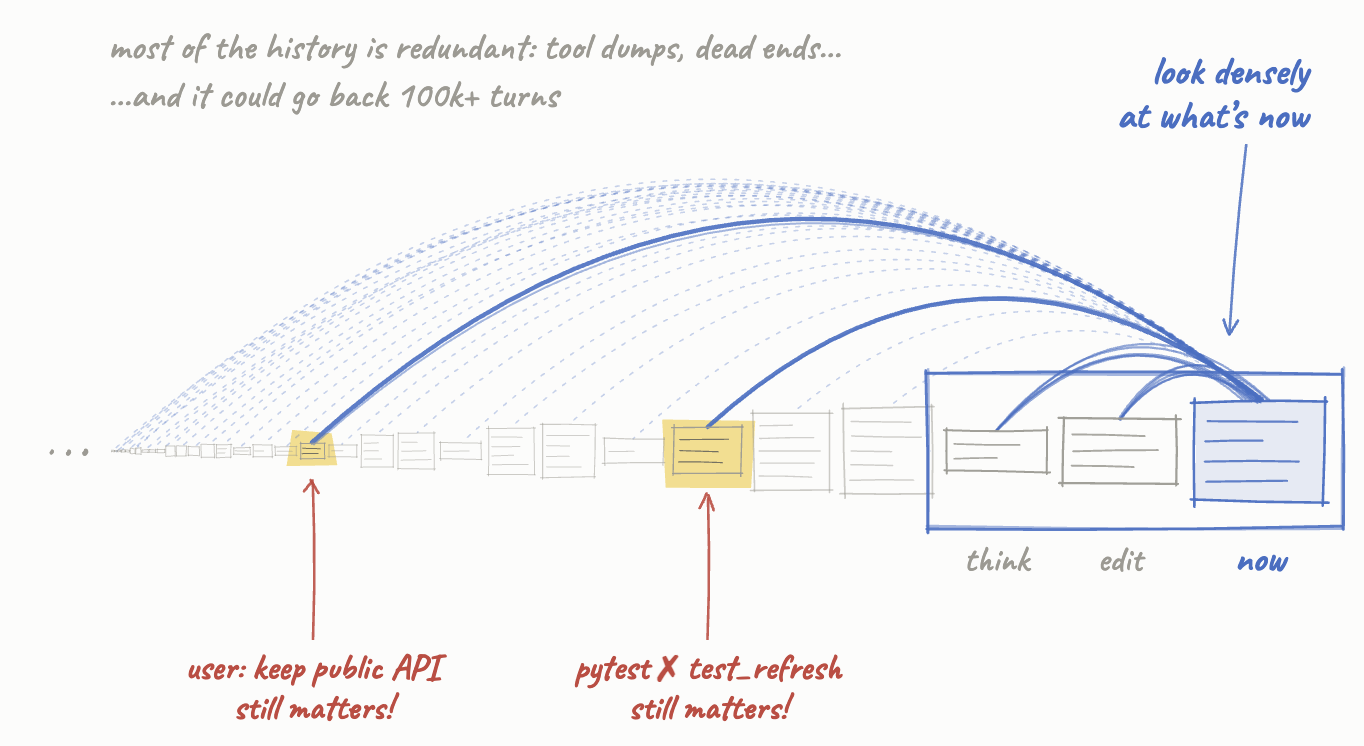
作者认为解码器Transformer并非处理智能体轨迹的终极形态。当前ReAct式智能体将历史与观测直接拼接为token序列,导致上下文有限且需压缩。更高效的形态可能是循环模型与Transformer结合:循环模型处理历史实现自动压缩,Transformer对当前观测做局部密集注意力。这样可避免显式压缩,并利用智能体对近期观测密集关注、对旧历史稀疏提取的结构假设。
现在为何更可行
2022年时,语言模型能力尚不确定,研究形态风险高。如今已确认规模能带来能力,且开放环境、数据与蒸馏技术使复现前沿能力更容易。将解码器Transformer的能力蒸馏到新形态,或引入新目标函数,都比以往更可行。作者认为,这对独立研究者尤其有价值,可能催生不受GPT-6等系统限制的高效应用。
Q&A
语言模型的“形态”具体指什么?
语言模型的“形态”大致指模型的输入/输出结构。最灵活且广泛使用的是自回归、仅解码器(decoder-only)的Transformer,但改变这种约定可以带来效率、长上下文等方面的不同权衡。
为什么当前语言智能体的工作大多围绕设计harness来适配模型?
因为用户总是偏好使用最好的模型,而前沿模型实验室不愿偏离已被证明有效的模型形态,押注替代方案成本极高。因此,设计语言智能体的工作都围绕设计harness来适配语言模型的自回归形态。
作者认为decoder-only Transformer是处理智能体轨迹的最终形态吗?
不是。作者认为decoder-only Transformer并非处理智能体轨迹的自然或最终形态,这正是存在上下文管理技巧(如压缩)的原因。
针对智能体轨迹,作者提出了什么样的替代模型形态?
作者提出一种更成本高效的语言模型形态,可能结合循环模型和Transformer,分别处理历史与当前观测,实现局部密集注意力和“自动压缩”历史,从而无需显式压缩。
Jev是什么?它如何体现语言模型形态的替代权衡空间?
Jev是Typesafe AI于2026年9月发布的语言模型,其输出空间被显式约束为[0,1]。这种约束使模型在采样时只需预填充(prefill-only),从而极快地回答特定类别问题。它代表了围绕语言模型形态的替代权衡空间的可能性,例如用作快速条件预测工具(模糊if语句逻辑),对递归语言模型(RLM)harness有用。
为什么现在研究语言模型形态比过去更可行?
因为我们已经知道通过规模可以实现超人类智能和长上下文,并且有大量开放的环境、数据和配方来近似前沿模型的能力。此外,现在更容易将decoder-only Transformer的能力蒸馏到其他形态,或引入新目标函数。
