


生成式人脸图像压缩与压缩域视觉任务分析 | TCSVT 2024
内容提要
本论文提出了一种分层端到端人脸图像编码模型,能够在高压缩比下提供高质量的人脸图像重建,并支持多种视觉分析任务。通过联合优化和基于压缩域的多任务分析,模型能够在大幅降低比特率的同时,保持与RGB图像相当的分析效果和重建质量。实验结果证明了该模型的实用性和有效性。
延伸解读
压缩与视觉分析融合的意义
传统图像压缩与视觉分析独立研究,本论文将两者结合,提出分层端到端人脸图像编码模型。该模型在高压缩比下同时保证高质量重建和支持多种视觉分析任务,通过联合优化和压缩域多任务分析,大幅降低比特率的同时保持与RGB图像相当的分析效果。这为压缩域直接进行机器视觉分析提供了新思路。
分层编码与多任务分析设计
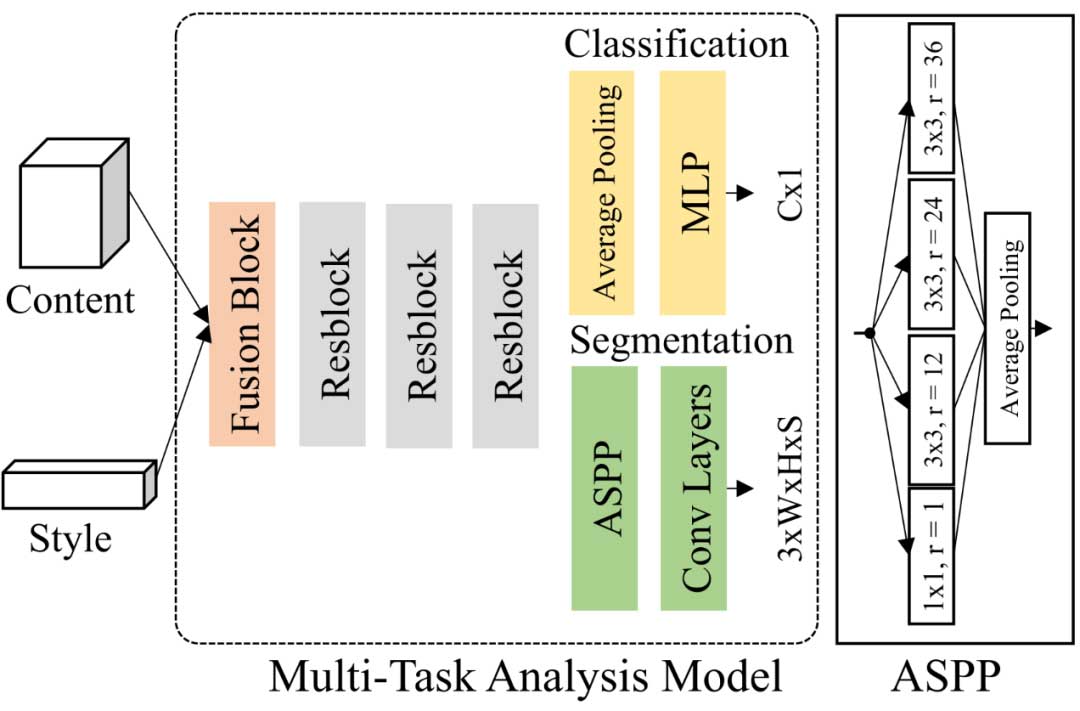
模型包含分层编码器、解码器和概率估计模型,采用不同编码器分别支持重建和语义分析。训练策略分为面向人类视觉和面向机器感知任务,采用多种失真度量满足人眼需求。基于压缩域的多任务分析网络通过联合训练与独立训练优化,探索压缩与机器视觉感知的关系,实验显示多任务学习对分析任务有正向作用。
性能权衡与实验验证
实验表明,模型在节省99.6%比特率的同时,重建图像感知质量与RGB图像相当,多任务分析网络在mIoU指标上仅损失0.8%准确度。但高压缩率下视觉分析性能提升以重建质量和压缩率为代价,存在视觉分析-失真-人眼感知的权衡。这验证了压缩域表征的有效性,但也提示需根据应用场景平衡压缩率与分析性能。
局限性与未来方向
论文指出,基于生成方法的图像压缩模型对强调像素保真度的指标(如PSNR和MSE)存在局限性,其主要优势在于保留人眼感知导向信息和灵活支持机器感知分析。未来编解码器研究可参考此方向,但需注意该方法目前仅在人脸图像数据上验证,泛化到其他图像类型可能面临挑战。
Q&A
该论文提出了什么样的人脸图像编码模型?
该论文提出了一种分层端到端人脸图像编码模型,能够在高压缩比下提供高质量的人脸图像重建。
该模型如何支持视觉分析任务?
该模型通过联合优化和基于压缩域的多任务分析,能够保持与RGB图像相当的分析效果和重建质量。
实验结果显示该模型在比特率节省方面的表现如何?
实验结果证明该模型在节省99.6%比特率的同时,能够保证重建图像的感知质量。
模型的训练策略有哪些?
训练策略分为面向人类视觉任务和面向机器感知任务,采用多种失真度量以满足人眼视觉需求。
多任务分析网络的优势是什么?
多任务分析网络在分析感知任务上有正向作用,提升了准确度。
该模型在视觉分析性能与重建图像质量之间有什么关系?
该模型在高压缩率下显示出视觉分析性能的提升与重建图像质量之间的权衡关系。
