


什么是扩散模型?
内容提要
扩散模型基于前向加噪与反向去噪的马尔可夫链生成数据,训练目标为预测噪声。改进包括余弦噪声调度、学习方差、分类器与无分类器引导、DDIM加速采样、渐进蒸馏及一致性模型。潜在扩散在隐空间操作以降低计算成本,U-Net和Transformer为主流架构,ControlNet与DiT扩展了条件生成能力。
延伸解读
扩散模型与其他生成模型的区别
文章指出,GAN训练不稳定且生成多样性不足,VAE依赖替代损失,流模型需特殊架构保证可逆变换。扩散模型则通过固定加噪和去噪过程学习,隐变量维度与原始数据相同,训练更稳定,但采样速度慢。这些差异有助于理解扩散模型在生成质量与训练稳定性上的权衡。
条件生成中的引导策略
文章介绍了分类器引导和无分类器引导两种条件生成方法。分类器引导需额外训练分类器,利用其梯度调整噪声预测;无分类器引导则通过联合训练条件与无条件模型,在采样时组合两者分数,无需独立分类器。实验表明无分类器引导在FID和IS之间取得更好平衡,且被GLIDE等模型优先采用。
加速采样的关键方法
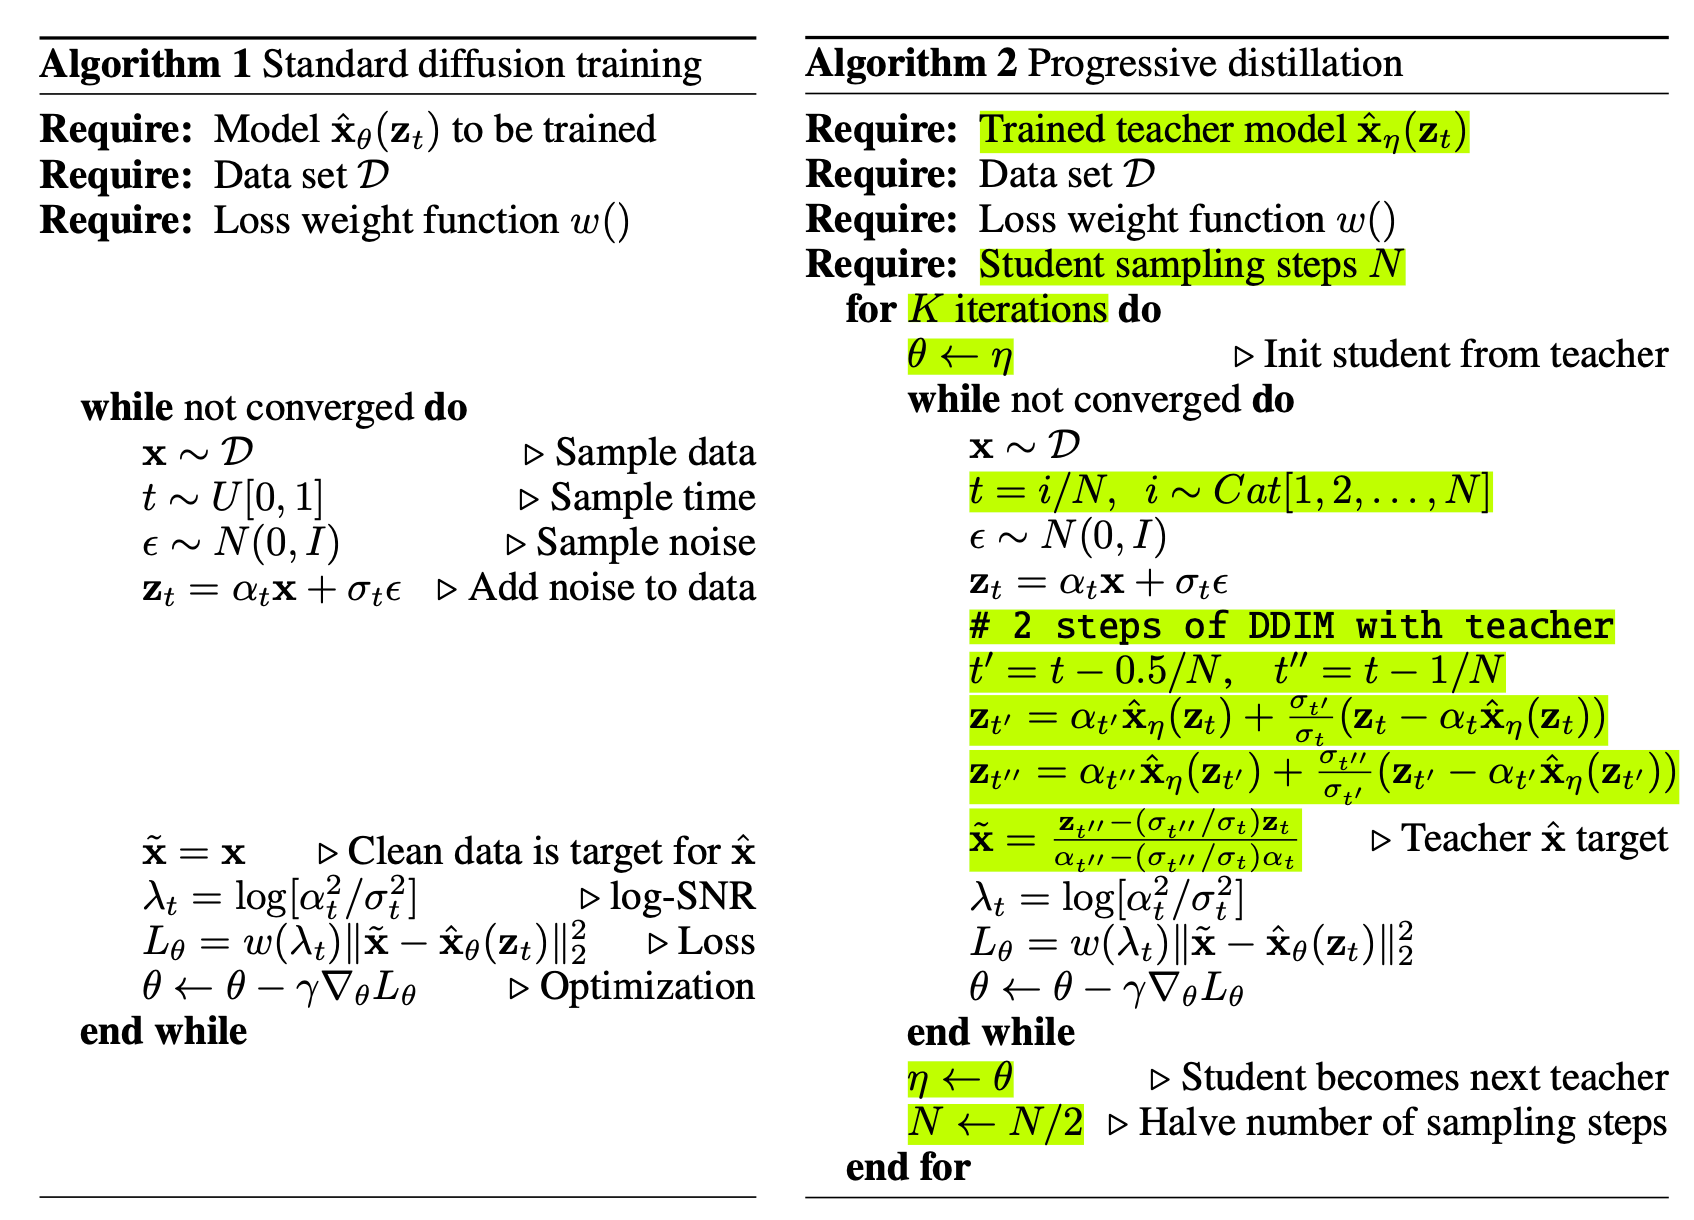
由于DDPM采样需上千步,速度极慢,文章提到多种加速方案:DDIM通过确定性采样和跳步大幅减少步数;渐进蒸馏将采样步数逐次减半;一致性模型学习将任意噪声点直接映射回原始数据,支持单步生成。这些方法在保持生成质量的同时显著提升效率,但需注意不同方法在步数减少时的质量权衡。
潜在扩散模型的计算优势
潜在扩散模型(LDM)在隐空间而非像素空间运行扩散过程,先通过自编码器去除像素级冗余,再在隐空间进行语义生成。这样做降低了训练和推理的计算成本,同时保持生成图像的感知质量。文章指出,这种两阶段压缩(感知压缩与语义压缩)是LDM高效的关键,但隐空间的选择可能影响细节还原能力。
Q&A
扩散模型的基本工作原理是什么?
扩散模型受非平衡热力学启发,定义了一个马尔可夫链,通过前向过程逐步向数据添加随机噪声,然后学习反向过程从噪声中重建数据样本。前向过程使用方差调度控制噪声添加,反向过程则训练神经网络来近似条件概率分布,从而生成数据。
扩散模型与GAN、VAE等生成模型相比有什么优势和不足?
扩散模型训练过程固定,潜在变量维度高(与原始数据相同),生成质量高。但生成速度慢,因为需要模拟数千步的马尔可夫链。GAN训练不稳定且多样性有限,VAE依赖替代损失,流模型需要特殊架构构建可逆变换。
如何加速扩散模型的采样过程?
加速方法包括:使用DDIM(去噪扩散隐式模型)进行确定性采样,减少采样步数;采用渐进蒸馏(Progressive Distillation)将采样步数减半;以及一致性模型(Consistency Models)直接映射噪声到数据,支持单步生成。
什么是无分类器引导(classifier-free guidance)?它有什么优点?
无分类器引导通过联合训练条件和无条件扩散模型,在采样时结合两者的分数估计来引导生成,无需独立分类器。优点是在FID和IS之间取得良好平衡,且比CLIP引导更受青睐,因为它避免了对抗样本问题。
潜在扩散模型(LDM)是如何降低计算成本的?
LDM在潜在空间而非像素空间运行扩散过程。它首先用自编码器去除像素级冗余,然后在学习到的潜在表示上应用扩散过程进行语义生成。这样训练成本更低,推理速度更快。
扩散模型常用的网络架构有哪些?
主流架构包括U-Net和Transformer。U-Net常用于像素空间扩散,而Transformer(如DiT)在潜在空间扩散中表现良好。ControlNet扩展了条件生成能力,通过附加网络实现空间条件控制。
