


SGLang 与 Miles 为 DeepSeek-V4.1 提供首日支持
内容提要
DeepSeek-V4.1 的 SGLang 服务栈优化包括:采用低比率压缩与滑动窗口注意力,跨层共享压缩 KV 和索引选择;Engram 表可卸载至主机内存,KV 缓存容量提升 36% 且吞吐相当;SWA 有界重放以有限重算换取缓存节省,解码端预填吞吐在 H200 上提升 1.56 倍;内核融合与 FP4 索引优化执行效率;Miles 训练后端支持量化感知训练与路由重放,训练与推理的对数概率差距小且稳定。
延伸解读
Engram 卸载的取舍:容量与通信的平衡
文章显示,将 Engram 表卸载到主机内存可释放 GPU 显存,使 KV 缓存容量提升 36%,且解码吞吐与首 token 延迟相当。但两种主机布局各有代价:主机分片保留 all-reduce 通信,共享主机布局虽消除该通信,却在测试容器中因大页支持缺失而未被采用。实际部署时需权衡 CPU-GPU 互联、大页可用性与工作负载,而非默认选择共享布局。
有界重放是近似优化,需评估质量边界
编码端重放通过重算缓存前缀最后 128 个 token 来重建窗口 KV,解码端仅对后段层计算尾部 128 个 token,两者都在重建边界截断局部注意力,因此重算的隐藏状态可能与完整预填充不同。文章明确称其为近似,质量需实证评估。测试中解码端重放在 8x H200 上预填充吞吐提升 1.56 倍,且在 4x GB300 上 AIME 2026 的 pass@1 与关闭时相同,但该结果不构成普遍保证。
训练与推理对齐:量化感知与路由重放
Miles 训练后端复现了服务引擎的 FP4 与 FP8 舍入,并用直通梯度优化离散操作;路由重放将采样到的专家分配喂给训练器,避免路由平局导致路径分歧。值得注意的是,索引器 top-k 选择被重新计算而非存储重放,因为量化输入匹配后重放未带来可测的一致性收益。这减少了为每个 rollout token 保留逐层选择的开销,也提示对齐重点应放在量化输入而非选择结果本身。
已验证运行的一致性数据与解释边界
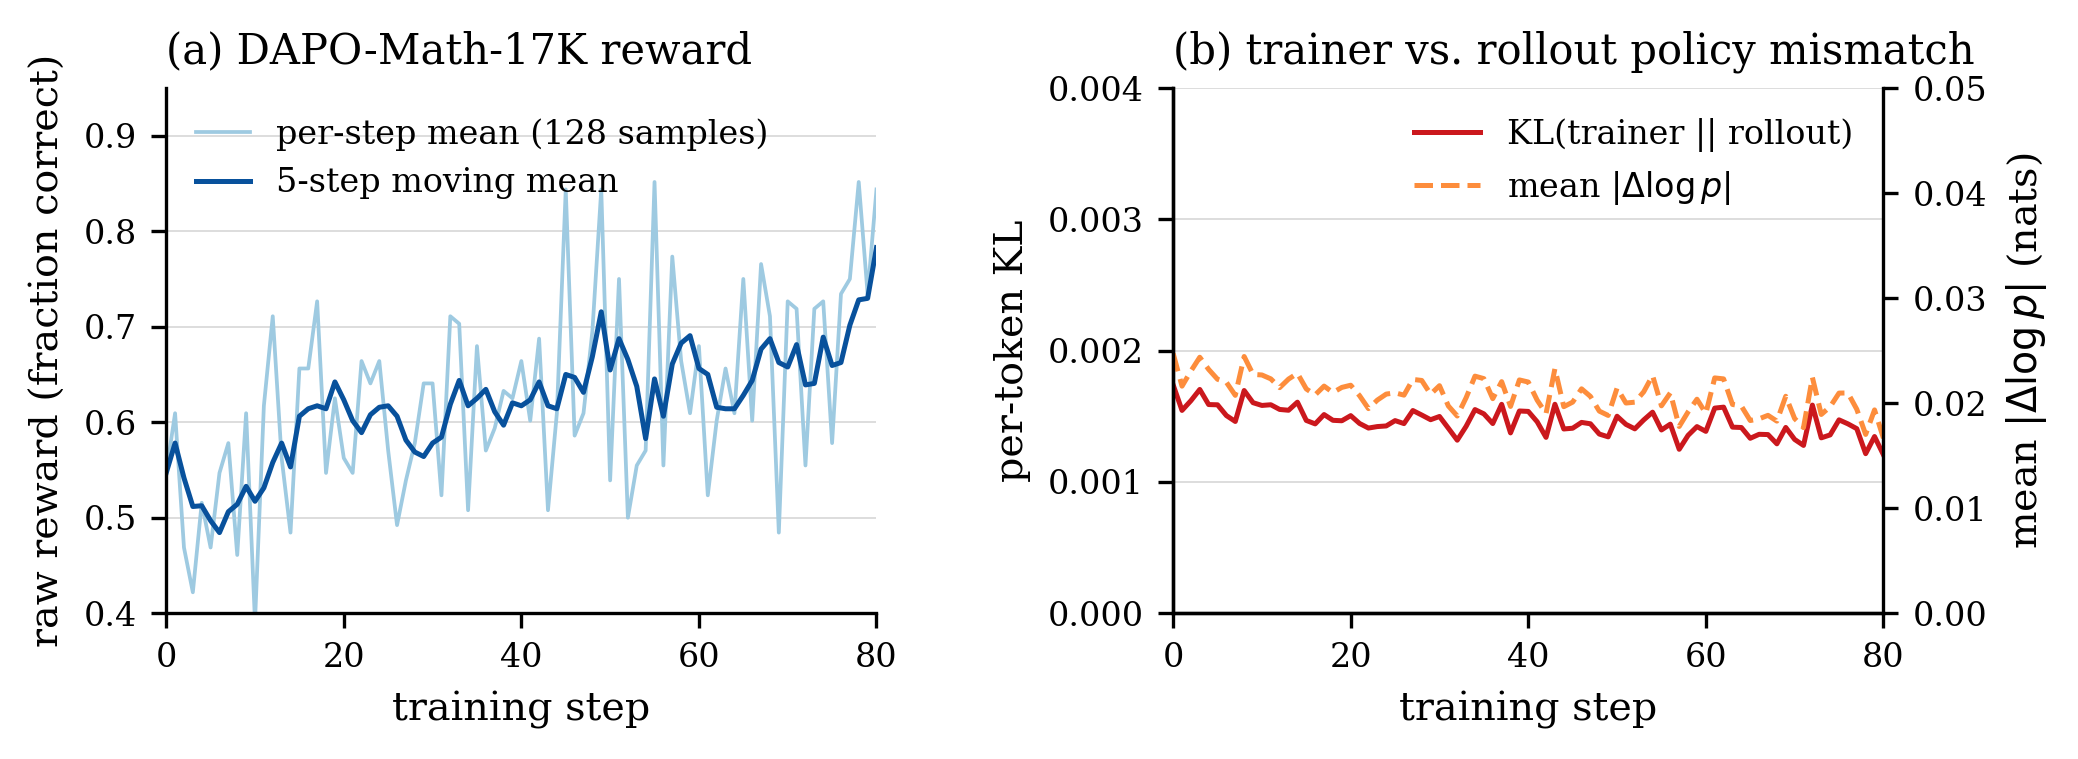
在 16 块 GB300 上的 DAPO 运行中,训练器与 rollout 的每 token KL 在 0.0012 至 0.0017 之间,平均绝对对数概率差距为 0.017 至 0.025 nats,且未持续增长;奖励从 0.51 升至 0.78,运行超过 120 步无失败。文章同时指出,这些测量未隔离差异原因,也不构成数值等价证明。读者应将其视为该配置下的稳定性证据,而非跨模型或跨硬件的通用结论。
Q&A
DeepSeek-V4.1 的 SGLang 服务栈做了哪些主要优化?
主要优化包括:采用低比率压缩与滑动窗口注意力,跨层共享压缩 KV 和索引选择;Engram 表可卸载至主机内存,KV 缓存容量提升 36% 且吞吐相当;SWA 有界重放以有限重算换取缓存节省,解码端预填吞吐在 H200 上提升 1.56 倍;内核融合与 FP4 索引优化执行效率;Miles 训练后端支持量化感知训练与路由重放,训练与推理的对数概率差距小且稳定。
Engram 表卸载到主机内存有什么好处?如何启用?
将 Engram 表卸载到主机内存可以释放 GPU 内存用于 KV 缓存,在 4x GB300 测试中 KV 缓存容量提升 36%,解码吞吐和首 token 延迟相当。启用方式:设置环境变量 SGLANG_ENABLE_DSV41_ENGRAM_HOST_TABLE=1,并通过 SGLANG_DSV41_ENGRAM_HOST_TABLE_LAYOUT 选择 shared(默认)或 per_rank 布局。
SWA 有界重放是什么?它如何提升预填吞吐?
SWA 有界重放是一种用有限重算换取缓存节省的技术。编码器端有界重放在缓存命中时重算缓存前缀的最后 128 个 token 以重建窗口 KV,无需窗口检查点;解码器端仅计算尾部,对每个预填块,层 0-20 处理所有 token,层 21-39 只处理最后 128 个 token。在 8K token 提示的配对测试中,解码端重放将预填吞吐在 8x H200 上提升 1.56 倍,在 4x GB300 上提升 1.37 倍。
Miles 训练后端如何保证训练与推理的对数概率一致性?
Miles 通过量化感知训练复现服务引擎的 FP4 和 FP8 舍入,使用直通梯度优化离散操作;路由重放将采样的专家分配反馈给训练器 MoE 层,防止路由不一致;压缩门、归一化统计、mHC 混合等使用 FP32 计算;确定性归约和矩阵乘法设置确保可重复性。在验证运行中,每 token KL 在 0.0012 到 0.0017 之间,平均绝对对数概率差距为 0.017 到 0.025 nats,且未持续增长。
DeepSeek-V4.1 的跨层共享机制具体共享哪些内容?
跨层共享包括:四个 KV 源层产生压缩 KV 和索引器键,消费者层从最近的 KV 源读取,避免单独存储和生成;层 20 选择最多 2048 个八位置块作为候选发布给后续索引源层,后续层将 top-512 限制在这些共享候选内;八个索引源层用自己的查询评分并选择最多 512 个压缩位置,其余压缩注意力层复用最近的选择而不运行索引器。窗口 KV 仍各层独立。
使用 SWA 有界重放有哪些限制或注意事项?
两种模式都会在重建边界截断局部注意力,重算的隐藏状态可能与完整预填不同,因此是一种近似,需要实证评估质量。编码器重放不支持推测解码;解码器尾部计算不支持输入对数概率或完整提示隐藏状态捕获。两种模式均为可选(--enable-encoder-swa-bounded-replay 和 --enable-decoder-swa-bounded-replay),可以组合使用。
