


[译] 大模型推理的极限:理论分析、数学建模与 CPU/GPU 实测(2024)
内容提要
本文分析了大模型推理的速度瓶颈,探讨了访存带宽与算力的关系。实测数据表明,推理速度受限于访存带宽,尤其在生成文本时,模型逐个处理token,导致并行性不足。以Mistral 7B为例,计算推理所需的最小时间,强调低精度量化可降低延迟。建议在设计推理系统时考虑访存带宽的影响,以优化性能。
延伸解读
推理速度的理论下限
文章通过数学建模指出,大模型推理速度存在理论下限,主要受限于访存带宽。以Mistral 7B为例,FP16精度下每生成一个token需加载约14.2GB数据,在RTX 4090上理论最小延迟为14.1ms。实际实现如calm能达到理论极限的90%,说明优化空间有限。这一下限可用于评估推理系统性能,若实际速度远低于理论值,则表明软件或硬件存在优化空间。
量化对延迟的影响
低精度量化能显著降低推理延迟,因为延迟与每个权重使用的bit数成正比。例如,在RTX 4090上,使用8位权重时理论延迟降至7.0ms,实际测试中calm达到7.8ms/tok。因此,对于低延迟场景,采用FP16、FP8等低精度格式是有效手段。但需注意,量化可能影响模型质量,需在精度和速度间权衡。
多用户场景的瓶颈转移
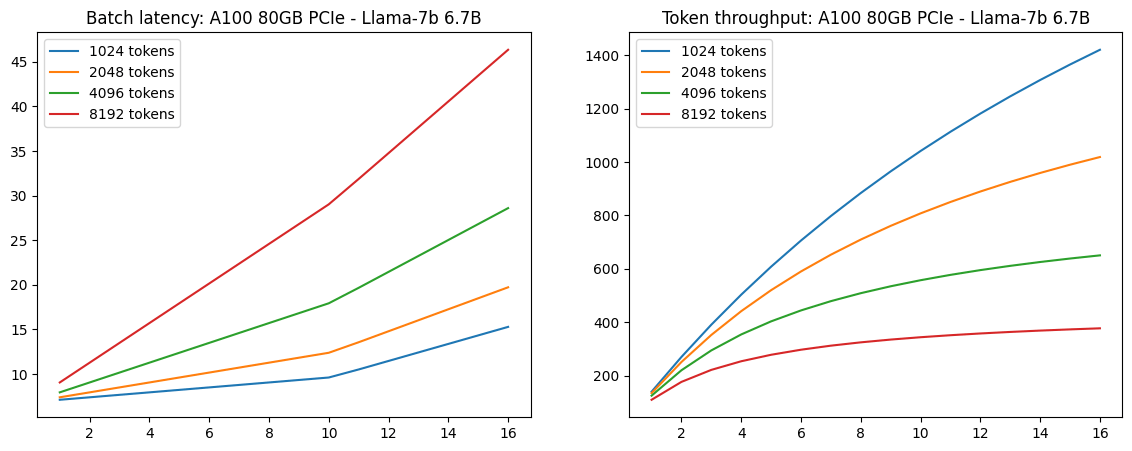
在多用户并发场景下,推理瓶颈从访存带宽转向算力(ALU)。因为批处理能复用权重矩阵,提高带宽利用效率,但KV-cache带宽随请求数增加而增加。对于混合专家模型(MoE),批处理初期增加带宽需求,当专家利用率显著后,推理逐渐变为算力受限。因此,生产环境需根据场景平衡带宽与算力。
GQA对长上下文的重要性
对于长上下文模型,KV-cache的访存开销可能成为主要瓶颈。以Cohere Command-R为例,在100K上下文下,attention部分的数据量占比可达75%。引入GQA(分组查询注意力)可将KV-cache大小和带宽减少至1/4,使长上下文推理更实用。因此,评估模型架构时,GQA的收益巨大,尤其对于长上下文应用。
Q&A
大模型推理的速度瓶颈是什么?
大模型推理的速度瓶颈主要是访存带宽,尤其在生成文本时,模型逐个处理token,导致并行性不足。
Mistral 7B模型在推理过程中每生成一个token需要加载多少数据?
每生成一个token,Mistral 7B模型需要加载约14.2GB的数据。
低精度量化如何影响推理延迟?
低精度量化(如FP16、FP8)可以显著降低推理延迟,因此在设计推理系统时应考虑其影响。
GQA技术如何提高推理效率?
GQA(Grouped Query Attention)可以显著减少KV-cache的大小和所需带宽,从而提高推理效率。
在多用户场景中,推理性能的关键指标是什么?
在多用户场景中,推理性能的关键指标仍然是访存带宽。
如何评估推理系统的性能?
推理系统的性能评估应关注访存带宽,即使在多用户场景中,访存带宽仍然是关键指标。
