利用 JDK 内联函数加速后量子密码学
内容提要
JDK 以纯 Java 实现支持后量子密码算法 ML-KEM、ML-DSA 和 HSS/LMS,保证可移植性。HotSpot 通过 @IntrinsicCandidate 注解将热点方法替换为利用 CPU 特性的平台专用机器码,Java 实现作为后备。ML-KEM 的 NTT、多项式乘法等操作适合内联优化,ML-DSA 需专用实现。基准测试显示内联可显著提升吞吐量,ML-KEM 最高提速 3.18 倍。
延伸解读
内联函数如何平衡性能与可移植性
JDK 的后量子密码算法以纯 Java 实现,保证了跨平台可移植性。HotSpot 通过 @IntrinsicCandidate 注解,在支持特定 CPU 特性(如 SHA-3 加速、向量指令)的平台上,将热点方法替换为优化的机器码,从而提升性能。Java 实现始终作为后备,确保算法在任何平台都能运行。这种设计让开发者既能享受硬件加速,又无需牺牲可移植性。
ML-KEM 与 ML-DSA 的内联优化差异
ML-KEM 和 ML-DSA 虽同属格密码,但内联优化策略不同。ML-KEM 的 NTT、多项式乘法等操作因计算高度规则(256 个系数),适合向量化,已有多个 @IntrinsicCandidate 方法。ML-DSA 使用不同的模数(8380417)和系数表示,需要算法专用内联实现,且包含 ML-KEM 没有的操作(如 implDilithiumDecomposePoly)。因此,HotSpot 通常需要为每种算法单独开发内联函数。
内联加速的实际效果与解读
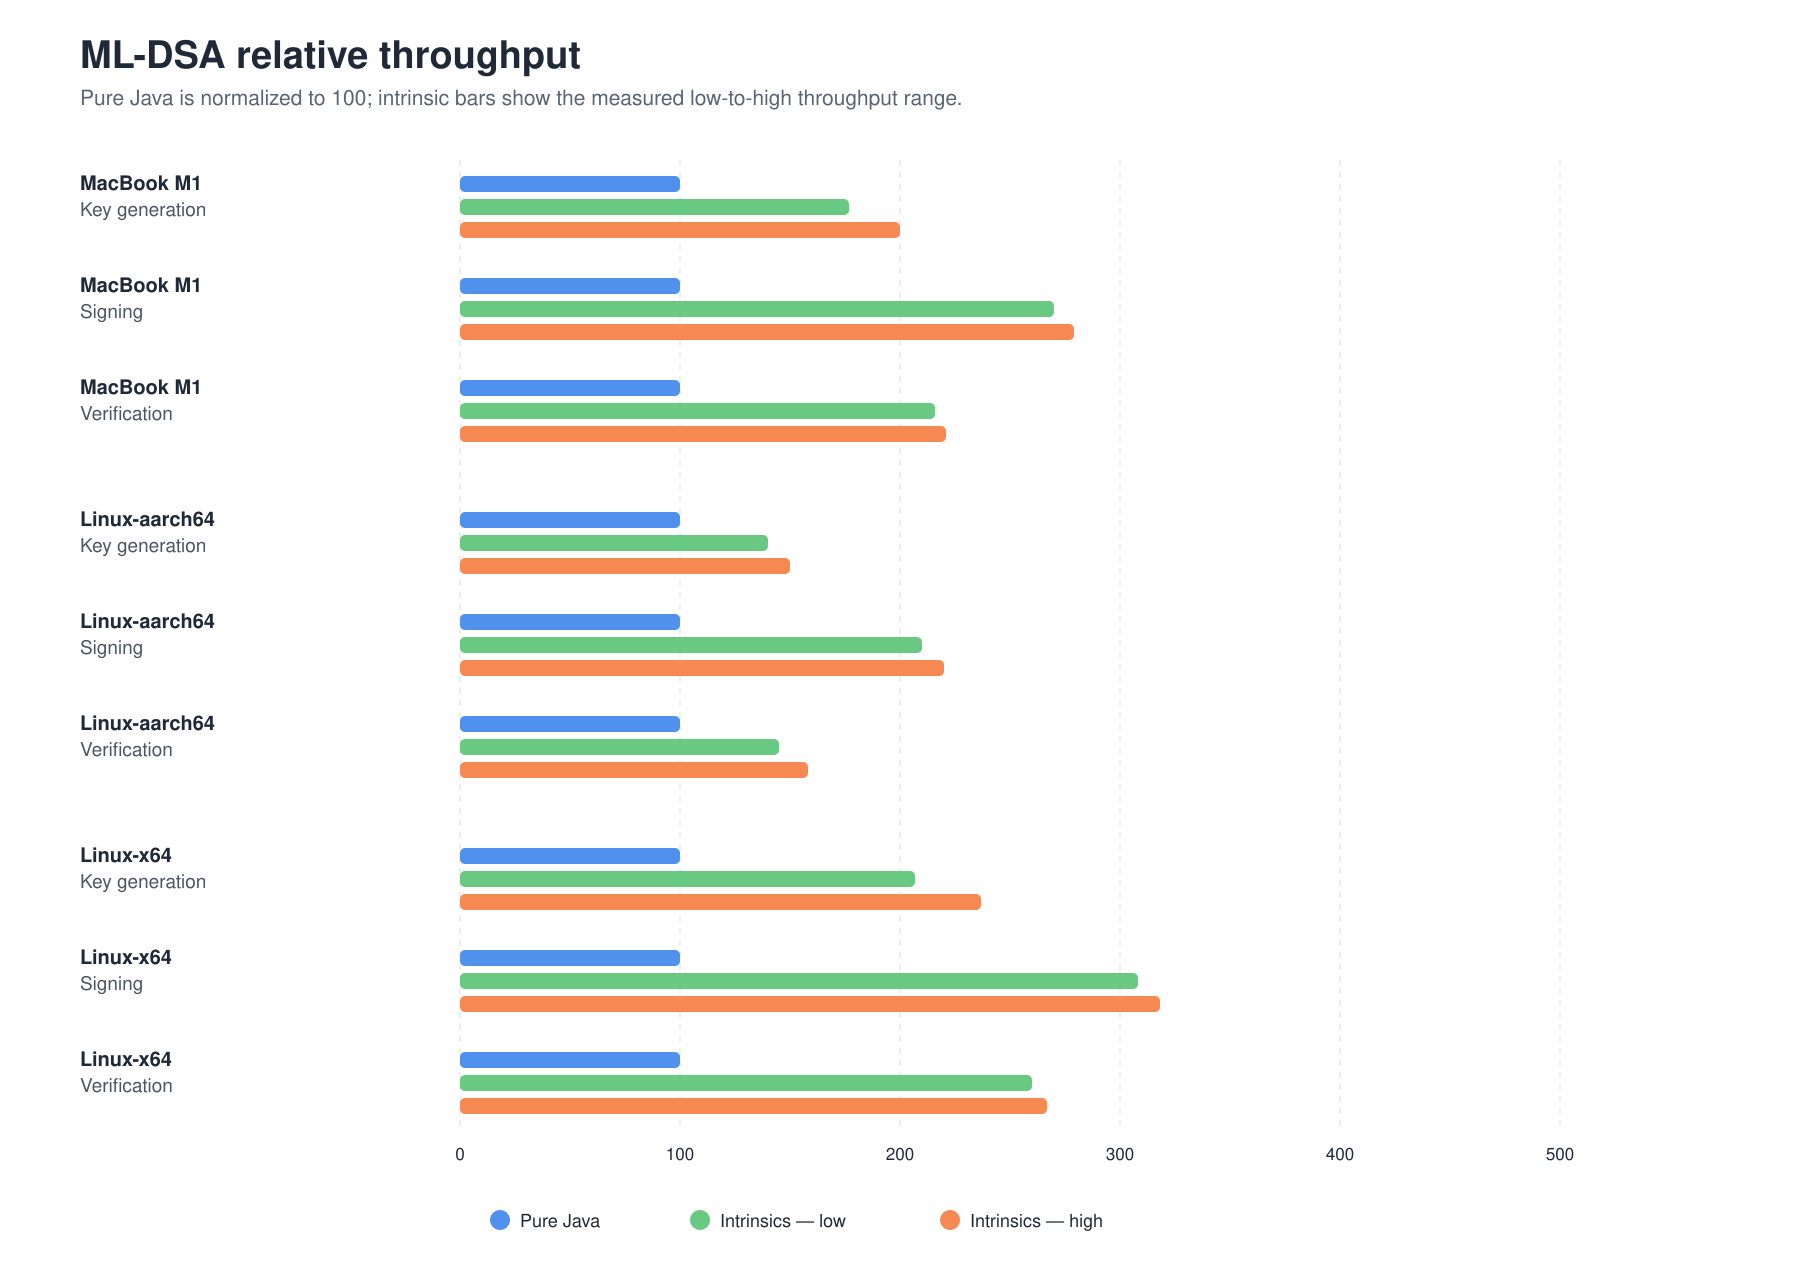
基准测试显示,启用内联后 ML-KEM 吞吐量最高提升 3.18 倍(即提速 218%)。不同参数集提升幅度不同,例如 ML-KEM-512 因计算资源需求较少,吞吐量高于 ML-KEM-1024。对于 HSS/LMS,SHA-256 内联在验证工作负载中尤其重要,因为 SHA-256 占据了大部分执行时间。这些结果说明,针对频繁执行的小型原语进行内联,能显著提升整个密码算法的性能。
Q&A
JDK 支持哪些后量子密码算法?
JDK 支持 ML-KEM(FIPS 203)、ML-DSA(FIPS 204)以及基于哈希的 HSS/LMS 算法(RFC 8554)。
什么是 HotSpot 内联函数(intrinsic)?
内联函数是 HotSpot 用平台专用的优化机器码替换选定的 Java 方法,以利用 CPU 特性(如 SHA-3 加速、向量指令等)。Java 方法仍作为可移植的后备实现。
哪些方法适合被标记为 @IntrinsicCandidate?
适合的方法需同时满足:计算开销大、频繁使用,且平台专用实现相比 Java 后备能带来显著性能提升。
ML-KEM 中哪些操作适合内联优化?
ML-KEM 中适合内联的操作包括:正向和逆向 NTT、NTT 域多项式乘法、多项式加法、Barrett 约减以及位打包/解包。这些操作在密钥生成、封装和解封装的热路径中,且对 256 个系数进行高度规则的计算。
ML-KEM 和 ML-DSA 的内联实现可以互换吗?
不能。虽然两者都是格密码方案,共享 NTT、多项式乘法等操作类别,但 ML-KEM 使用模数 3329,ML-DSA 使用模数 8380417,且系数表示和约减算术不同,因此 HotSpot 通常需要算法专用的内联实现。
内联优化对 ML-KEM 的性能提升有多大?
基准测试显示,启用内联后 ML-KEM 的吞吐量最高提升 3.18 倍(即 218% 的加速)。
