


使用LangChain和Qdrant构建问答应用
内容提要
本文介绍了如何使用LangChain和Qdrant构建问答应用。通过将事实转化为向量并存储在Qdrant中,系统能够进行语义搜索并提取相关文档。使用两个模型,一个用于特征提取,另一个用于文本生成。配置知识库后,用户可以通过简单代码实现问答功能,LangChain会自动处理大部分流程。
延伸解读
为何需要向量数据库与双模型
文章指出,ChatGPT类模型在无上下文时难以保证事实准确性,因此需要提供已知事实作为上下文。Qdrant作为向量数据库,通过语义搜索从大量知识中预选可能相关的文档,再交给LLM提取答案。同时,系统需要两个模型:一个嵌入模型将事实转化为向量并存储,另一个生成模型根据上下文回答问题。这种分工解决了特征提取和文本生成的不同任务。
LangChain如何简化开发流程
LangChain提供了统一接口,避免了编写样板代码。其VectorDBQA链自动从Qdrant加载事实并输入OpenAI LLM,用户只需几行代码即可实现问答。文章强调,甚至无需直接操作QdrantClient,因为LangChain在后台处理了所有集成细节。这降低了构建复杂问答系统的门槛,让开发者能专注于价值创造。
知识库构建与扩展的注意事项
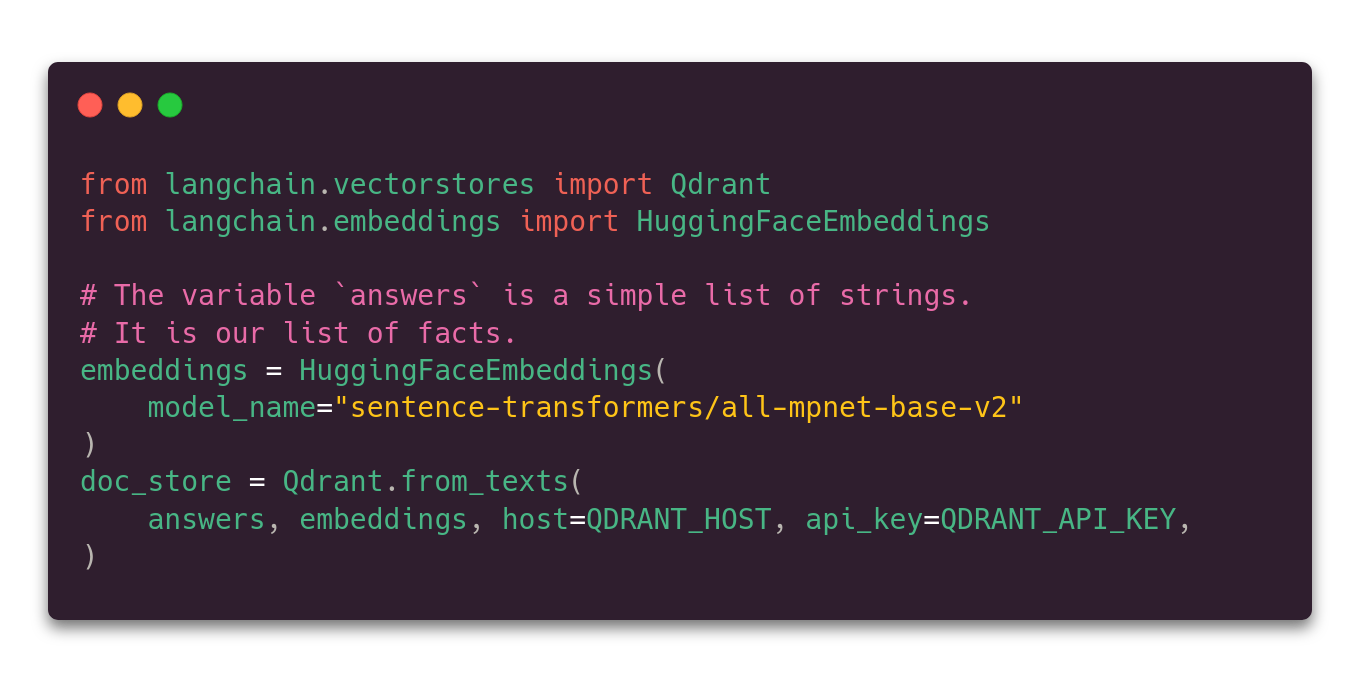
构建知识库时,文章使用Natural Questions数据集,但需预处理提取纯文本。答案通过嵌入模型向量化后存入Qdrant。知识库可轻松扩展新事实,但前提是新事实与问题的相似度能进入Qdrant返回的顶部结果。这意味着扩展的有效性依赖于语义搜索的质量,并非所有新增事实都能被自动利用。
实际测试表现与局限性
文章展示了几个测试查询,如询问Scott Joplin的音乐类型,系统正确回答;但对于歌词含义的问题,系统回答“我不知道”。这表明当上下文缺乏相关信息时,LLM会承认不知道,避免编造。然而,回答质量取决于Qdrant检索的相关文档是否包含答案,以及LLM能否正确提取。因此,系统并非万能,其准确性受限于知识库覆盖和检索效果。
Q&A
如何使用LangChain和Qdrant构建问答应用?
可以通过配置知识库、使用特征提取模型和文本生成模型,并利用LangChain的简单代码实现问答功能。
Qdrant在问答应用中有什么作用?
Qdrant作为向量数据库,能够进行语义搜索,帮助提取相关文档以支持问答。
构建问答应用需要哪些模型?
需要两个模型,一个用于特征提取,将事实转化为向量,另一个用于文本生成。
如何配置知识库以支持问答功能?
需要获取API密钥,并处理公共数据集以提取问题和答案,最后将答案向量化。
LangChain如何简化问答应用的开发?
LangChain提供统一接口,减少了样板代码的编写,使开发过程更加简化。
问答应用的测试步骤是什么?
测试步骤包括输入查询,LangChain会处理所有必要的过程以找到答案。
