


在 Amazon EKS 上共享 GPU:Time-Slicing、NVIDIA DRA 与 HAMi 的功能验证和选型建议
内容提要
本文在 Amazon EKS 与 A10G 上实测三种 GPU 共享方案。Device Plugin Time-Slicing 部署简单,但无显存与算力隔离,双活跃时单服务吞吐约减半,显存超配会导致后启动服务失败。NVIDIA DRA 支持结构化设备发现与 Claim 生命周期管理,分时功能仍为 alpha 且无运行时隔离。HAMi 提供用户态显存配额与计算节流,可限制显存并触发 OOM,但属软件隔离,非 MIG 硬件隔离。建议可信、错峰负载用 Time-Slicing,需软件配额选 HAMi,关键业务独占 GPU。
延伸解读
共享不等于隔离:三种方案的风险边界
文章实测表明,Device Plugin Time-Slicing 和 NVIDIA DRA 分时模式均不提供显存与算力隔离,显存超配会导致后启动服务初始化失败;HAMi 虽提供用户态显存配额和计算节流,但属软件隔离,不能作为不可信租户间的安全边界。三种方案都无法消除物理 GPU、驱动和节点级故障域。选型前需明确:共享提升的是资源密度,而非隔离等级。
性能趋势:邻居空闲影响小,双活跃吞吐近减半
在 vLLM 测试中,Time-Slicing 与 HAMi 呈现相似趋势:邻居空闲时单请求输出速率接近独占基线;两个对称服务同时活跃时,每个服务吞吐约降至基线一半。这说明共享适合流量错峰场景,若峰值重叠明显,需按双活跃口径规划容量,并验证 P95/P99 延迟是否满足 SLO。
迁移 HAMi 时需重算显存参数
HAMi 的 gpumem 配额会改变容器可见显存,vLLM 的 --gpu-memory-utilization 按可见显存计算。文章实测从 Time-Slicing 迁移时沿用 0.40 导致 KV Cache 预算不足、服务无法启动,调整为 0.85 后正常。迁移共享方案时不能直接复制原参数,应结合模型权重、KV Cache 和运行时开销重新测算。
生产落地前需核验的部署边界
文章指出,Time-Slicing 与 DRA 分时模式均不支持 EKS Auto Mode,与 Karpenter 组合时需采用静态 GPU 容量;DRA 分时功能在测试版本中为 alpha。此外,不应让多个设备管理组件同时分配同一 GPU 节点上的设备。生产前应固定 AMI、驱动、Chart 和镜像 digest,并演练 OOM、插件重启和节点异常等场景。
Q&A
在 Amazon EKS 上共享 GPU 有哪些方案?各自有什么特点?
文章实测了三种方案:1) Device Plugin Time-Slicing:通过 ConfigMap 将一张物理 GPU 暴露为多个可调度槽位,部署简单,但无显存和算力隔离,适合可信、显存可规划、流量错峰的工作负载。2) NVIDIA DRA Driver Time-Slicing:支持结构化设备发现和 ResourceClaim 生命周期管理,分时功能为 alpha,无运行时隔离,适合需要结构化设备选择的场景。3) HAMi:提供用户态显存配额和计算节流,可限制显存并触发 OOM,但属软件隔离,非 MIG 硬件隔离,适合需要软件配额控制的场景。
Time-Slicing 共享 GPU 时,两个服务同时活跃性能会下降多少?
在 A10G 上使用 vLLM 测试,独占基线单请求输出速率 63.5 tokens/s,双活跃时每个服务降至约 31 tokens/s,约为基线的一半;10 并发聚合吞吐从 460.6 tokens/s 降至每个服务约 214-222 tokens/s,两者之和约 436.4 tokens/s。邻居空闲时影响较小,单请求速率接近基线。Time-Slicing 不保证每个 Pod 固定比例算力。
Time-Slicing 下显存超配会导致什么问题?
Time-Slicing 不会为每个 Pod 预留显存,已分配显存不会因其他 Pod 申请而回收。测试中将两个 vLLM 服务的 --gpu-memory-utilization 均设为 0.90 顺序启动,第二个服务因剩余显存不足(约 1.57 GiB 可用,需约 20.07 GiB)初始化失败,进入 CrashLoopBackOff。生产环境需根据模型权重、KV Cache、最大上下文和并发制定显存预算。
HAMi 如何实现显存配额和计算节流?效果如何?
HAMi 通过 Scheduler 根据 Pod 请求的显存和计算份额调度,并通过 Device Plugin 注入 HAMi-Core 动态库,对受支持的 CUDA/NVML 调用执行用户态显存配额检查和计算节流。测试中两个 Pod 各配 6144 MiB 显存配额,容器内可见显存即为 6144 MiB;分配 4 GiB 成功,7 GiB 触发 CUDA OOM。计算份额 gpucores:50 下,双活跃时两个 Pod 各完成约 27 次/秒 GEMM,近似均分。但属软件隔离,非硬件隔离。
NVIDIA DRA 在 GPU 共享中起什么作用?目前成熟度如何?
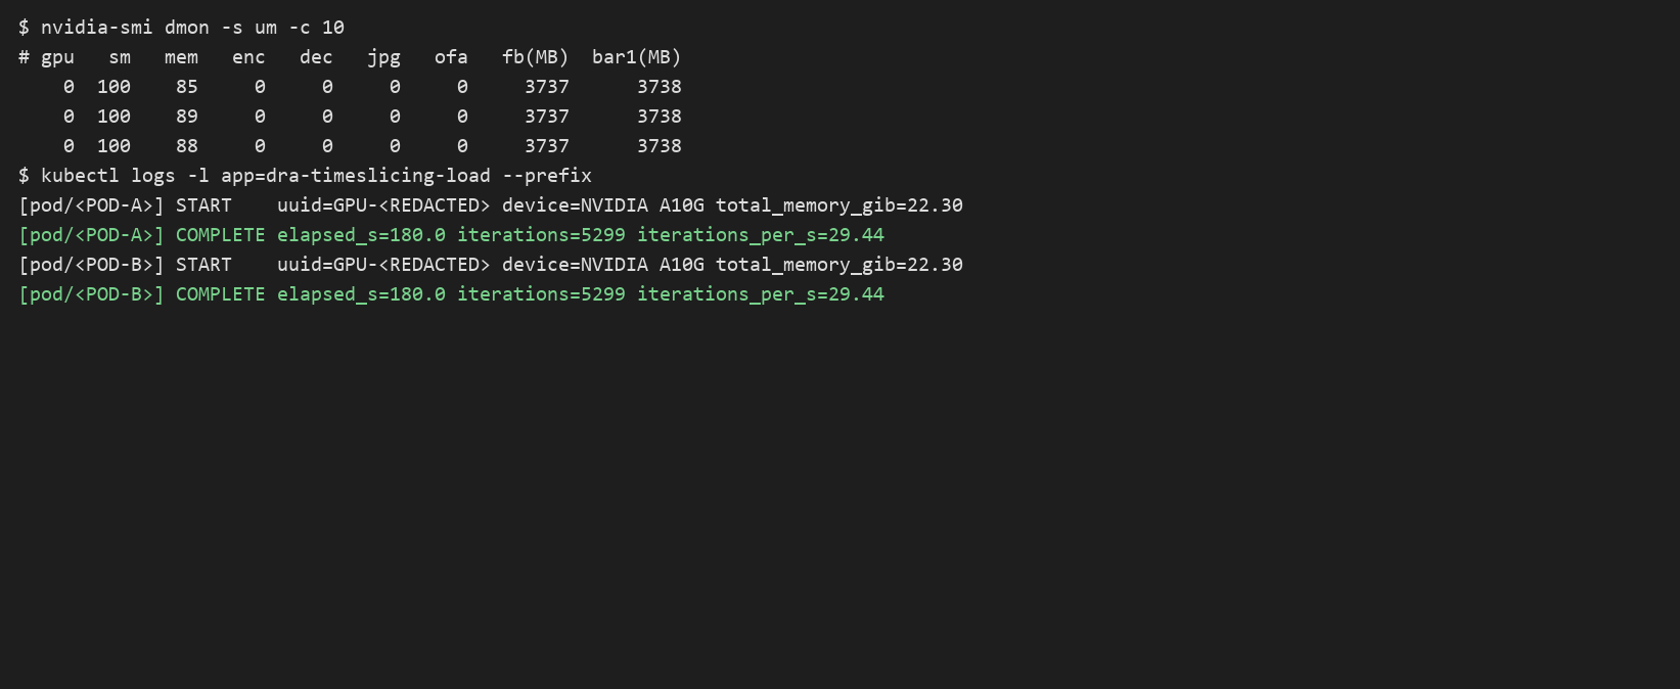
NVIDIA DRA 是 Kubernetes 的结构化设备分配框架,通过 ResourceSlice 发布 GPU 型号、显存、UUID 等属性,工作负载通过 DeviceClass 和 ResourceClaim 描述需求。多个 Pod 可引用同一个配置了 Time-Slicing 的 ResourceClaim 来共享同一张 GPU。测试中两个 Pod 看到相同 GPU UUID,并在 180 秒内各完成约 5300 次 GEMM。但 Time-Slicing 功能在 0.5.0 版本中为 alpha,需显式启用,且无运行时显存或计算隔离。
生产环境选择 GPU 共享方案时有哪些限制和检查项?
关键限制:Time-Slicing 和 DRA Time-Slicing 无 Pod 级显存/算力隔离;HAMi 属软件隔离,不能作为不可信租户安全边界;三种方案均共享物理 GPU 故障域;不应让多个设备管理组件同时管理同一 GPU 节点;DRA Time-Slicing 为 alpha;Time-Slicing 下 DCGM 难以按容器归因指标。生产前应测算显存预算、测试多种流量模式、验证 SLO、演练 OOM 和节点故障、固定版本和镜像 digest、建立监控和回退方案。关键业务建议独占 GPU。
