
使用Qdrant和N8N与代码库进行聊天
内容提要
本文介绍了如何使用Qdrant和N8N构建与代码库的聊天服务。首先,需要设置Qdrant实例,并获取OpenAI API密钥和GitHub访问令牌。工作流程包括将GitHub仓库数据导入Qdrant,并利用这些数据创建聊天服务。通过配置相关节点,用户可以实现数据的提取、转换和加载,从而与代码库进行对话。
延伸解读
工作流拆解:从数据导入到对话
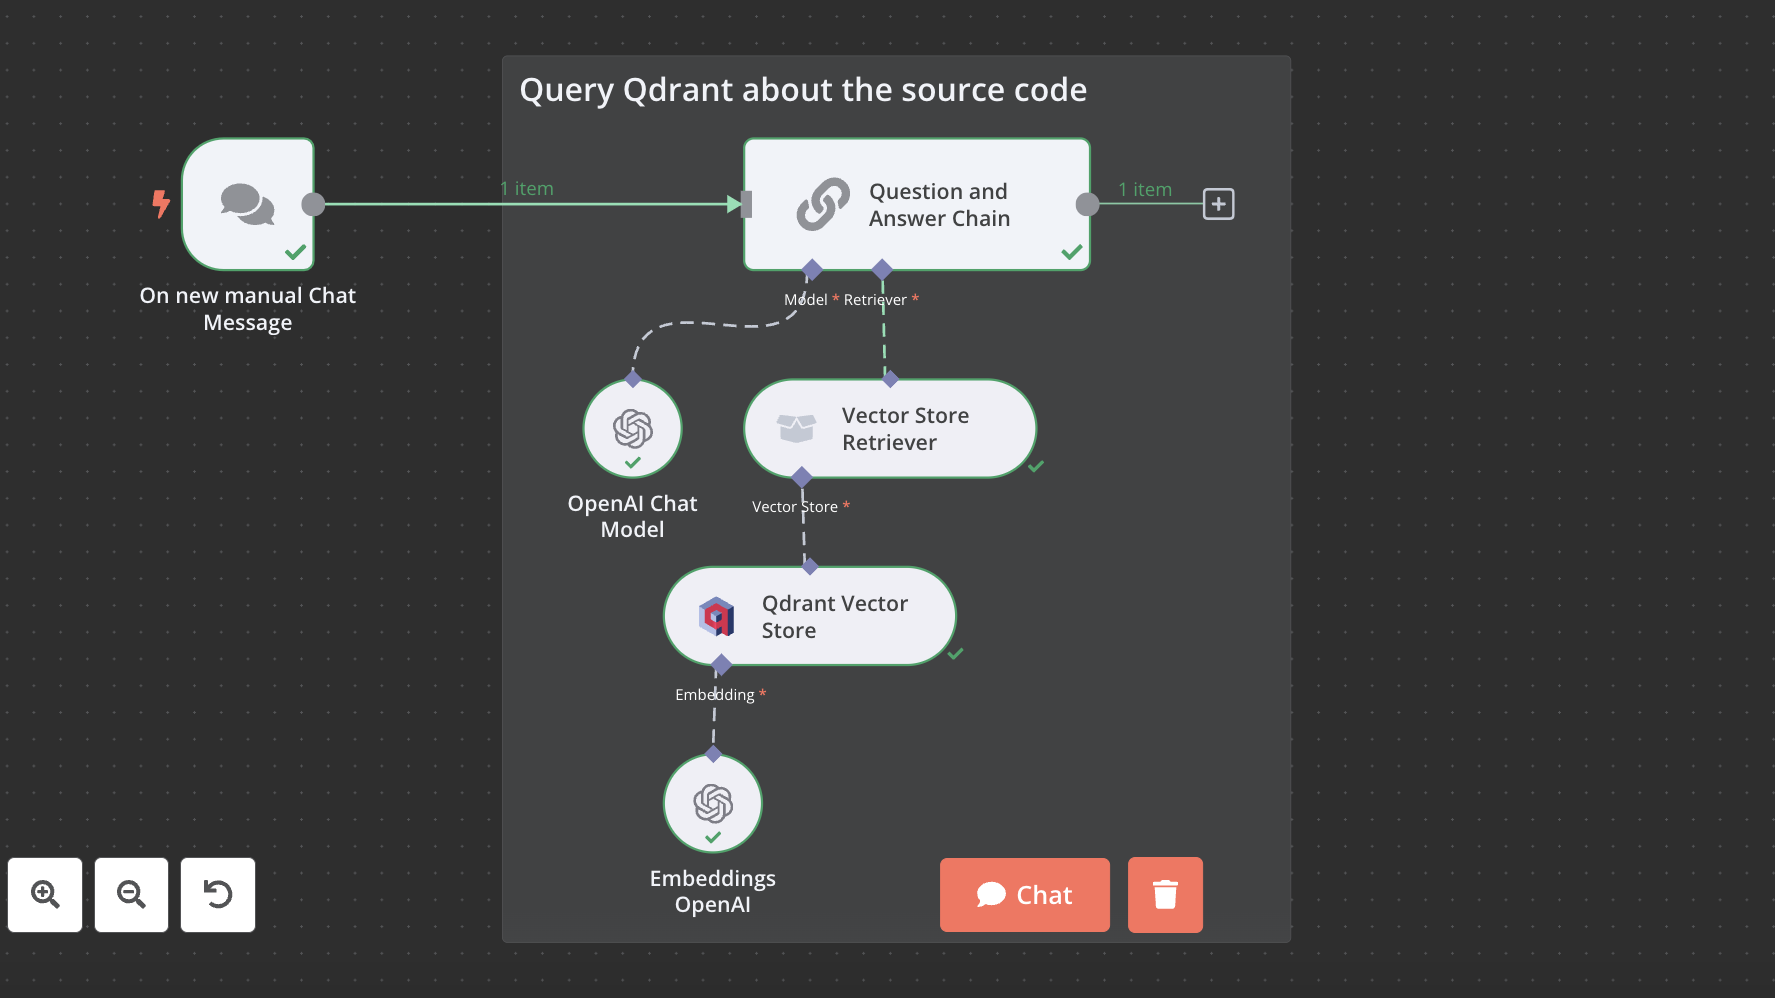
文章将整个服务拆分为两个独立工作流:第一个负责将GitHub仓库数据导入Qdrant,第二个负责基于已导入数据提供聊天服务。这种分离设计让数据更新与查询互不干扰,也便于分别调试。导入流程使用GitHub Document Loader拉取代码,经Recursive Character Text Splitter切分后,由Embeddings OpenAI生成向量并存入Qdrant。聊天流程则从Qdrant检索相关片段,交给Retrieval Q&A Chain和OpenAI Chat Model生成回答。
关键配置与默认值选择
文章给出了具体的配置示例:嵌入模型使用text-embedding-ada-002,聊天模型使用gpt-3.5-turbo,文本分割器采用默认参数。这些选择降低了上手门槛,但读者需注意,默认分割策略可能不适合所有代码库结构。Qdrant Vector Store节点在插入时若集合不存在会自动创建,这简化了初始化步骤。此外,GitHub Document Loader需要指定仓库名和分支,示例中为qdrant/demo-food-discovery@main,实际使用时需替换为自己的仓库信息。
扩展与集成可能性
除了手动触发,文章提到N8N支持定时工作流和事件触发,这意味着可以定期同步代码库变更,保持Qdrant中的数据最新。对于希望将聊天界面嵌入自有应用的开发者,可以使用@n8n/chat包。这种低代码方式让不熟悉向量数据库和LLM编排的开发者也能快速搭建服务。不过,文章未涉及权限控制、数据隐私或成本优化等生产环境常见问题,读者在落地时需自行评估。
Q&A
如何设置Qdrant实例以便与代码库聊天?
需要运行Qdrant实例,并获取OpenAI API密钥和GitHub访问令牌。
使用N8N构建聊天服务的工作流程包括哪些步骤?
工作流程包括将GitHub仓库数据导入Qdrant,并创建聊天服务。
在将GitHub数据导入Qdrant时需要使用哪些节点?
需要使用Qdrant Vector Store、GitHub Document Loader、Embeddings OpenAI和Recursive Character Text Splitter节点。
如何与导入的文档进行聊天?
使用Qdrant Vector Store、Retrieval Q&A Chain、Embeddings OpenAI和OpenAI Chat Model节点进行配置。
N8N支持哪些功能来增强聊天服务?
N8N支持定时工作流程和事件触发,还可以使用@n8n/chat包将聊天嵌入到应用程序中。
在构建聊天服务时,如何测试工作流程?
可以连接工作流程到手动触发器,并点击“测试工作流程”来运行它。
