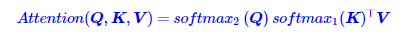

transformer and attention(三)
内容提要
本文介绍了视觉领域中使用transformer的方法,包括Vision Transformer、SASA-Layer和Rethinking and Improving Relative Position Encoding for Vision Transformer等模型。这些方法在图像分类和其他视觉任务中表现出色。
延伸解读
线性注意力:去掉Softmax的动机与代价
文章指出,标准注意力中QK^T的Softmax操作复杂度为O(mn),当序列长度n远大于维度d时成为瓶颈。线性注意力通过去掉Softmax,将复杂度降至线性级别。但为保证注意力分布特性,需满足相似度非负,例如用激活函数替代核函数。文章还提到将指数泰勒展开近似为1+q_i^T k_j,以及稀疏注意力作为替代方案。这些方法在降低计算量的同时,可能牺牲部分建模能力,读者需权衡效率与效果。
视觉Transformer的位置编码:从绝对到相对
文章对比了绝对位置编码和相对位置编码。绝对位置编码(如三角函数编码)为每个位置分配固定向量,但限制了模型处理的最大序列长度。相对位置编码则编码两个token之间的相对距离,可推广到未见长度,但可能增加训练和测试时间。在视觉领域,图像是二维数据,相对位置编码需要处理行偏移和列偏移,例如SASA-Layer将距离分解为行和列并分别嵌入,再拼接形成相对位置表示。
相对位置编码的两种模式:偏向与语境
文章引用《Rethinking and Improving Relative Position Encoding for Vision Transformer》,将相对位置编码分为偏向模式和语境模式。偏向模式独立于输入嵌入,仅作为可学习的偏置加到注意力权重上;语境模式则与查询、键或值交互,例如用可训练向量与Q或K相乘。此外,为计算二维相对位置,文章介绍了无向映射(Euclidean、Quantization)和有向映射(Cross、Product),其中有向映射能保留方向信息,但可能带来额外计算开销。
视觉Transformer的变体:Swin与Twins的效率改进
文章提到Swin Transformer通过分层结构和移位窗口方案,将自注意力限制在不重叠的局部窗口内,同时允许跨窗口连接,从而降低计算复杂度并适应视觉任务中尺度变化大的特点。Twins则重新审视空间注意力设计,提出Twins-PCPVT和Twins-SVT两种结构,强调高效且易于实现,仅依赖矩阵乘法。这些变体在图像分类等任务上表现出色,展示了视觉Transformer在效率与性能之间的平衡探索。
Q&A
Vision Transformer 是如何处理图像数据的?
Vision Transformer 通过 patch embedding 将图像分割成 patches 并转换为序列,再加上位置编码,然后像在 NLP 中一样使用 Transformer 处理。
线性注意力是如何降低复杂度的?
线性注意力通过去掉 Softmax 操作,将复杂度从 O(mn) 降低到线性级别,同时要求相似度函数非负以保证注意力分布特性。
SASA-Layer 在相对位置编码上有什么改进?
SASA-Layer 改进了相对位置编码的方法,提出了偏向模式和语境模式,分别独立于输入嵌入和考虑与查询、键或值的交互。
Swin Transformer 如何提高计算效率?
Swin Transformer 通过分层结构和移位窗口方案,将自注意力计算限制在不重叠的局部窗口,同时允许跨窗口连接,从而带来更高的效率。
相对位置编码相比绝对位置编码有什么优势?
相对位置编码可以推广到看不见长度的序列,因为它编码的是两个标记之间的相对成对距离,而绝对位置编码限制了模型处理的 token 数量。
Twins 架构在空间注意力设计上有什么特点?
Twins 架构重新审视了空间注意力的设计,提出了 Twins-PCPVT 和 Twins-SVT 两种高效且易于实现的视觉转换器结构,在多种视觉任务上取得优异性能。
