


LIMIT:指令微调中少即是多
内容提要
研究探讨大语言模型微调:少量高质量样本(如LIMA的1000条)可提升模型表现,但效果取决于数据与评估方式的匹配。实验发现,混合LIMA与指令数据微调能同时提升传统NLP基准和GPT-4评判的对话质量,兼顾两种评估范式。
延伸解读
微调数据需与评估方式匹配
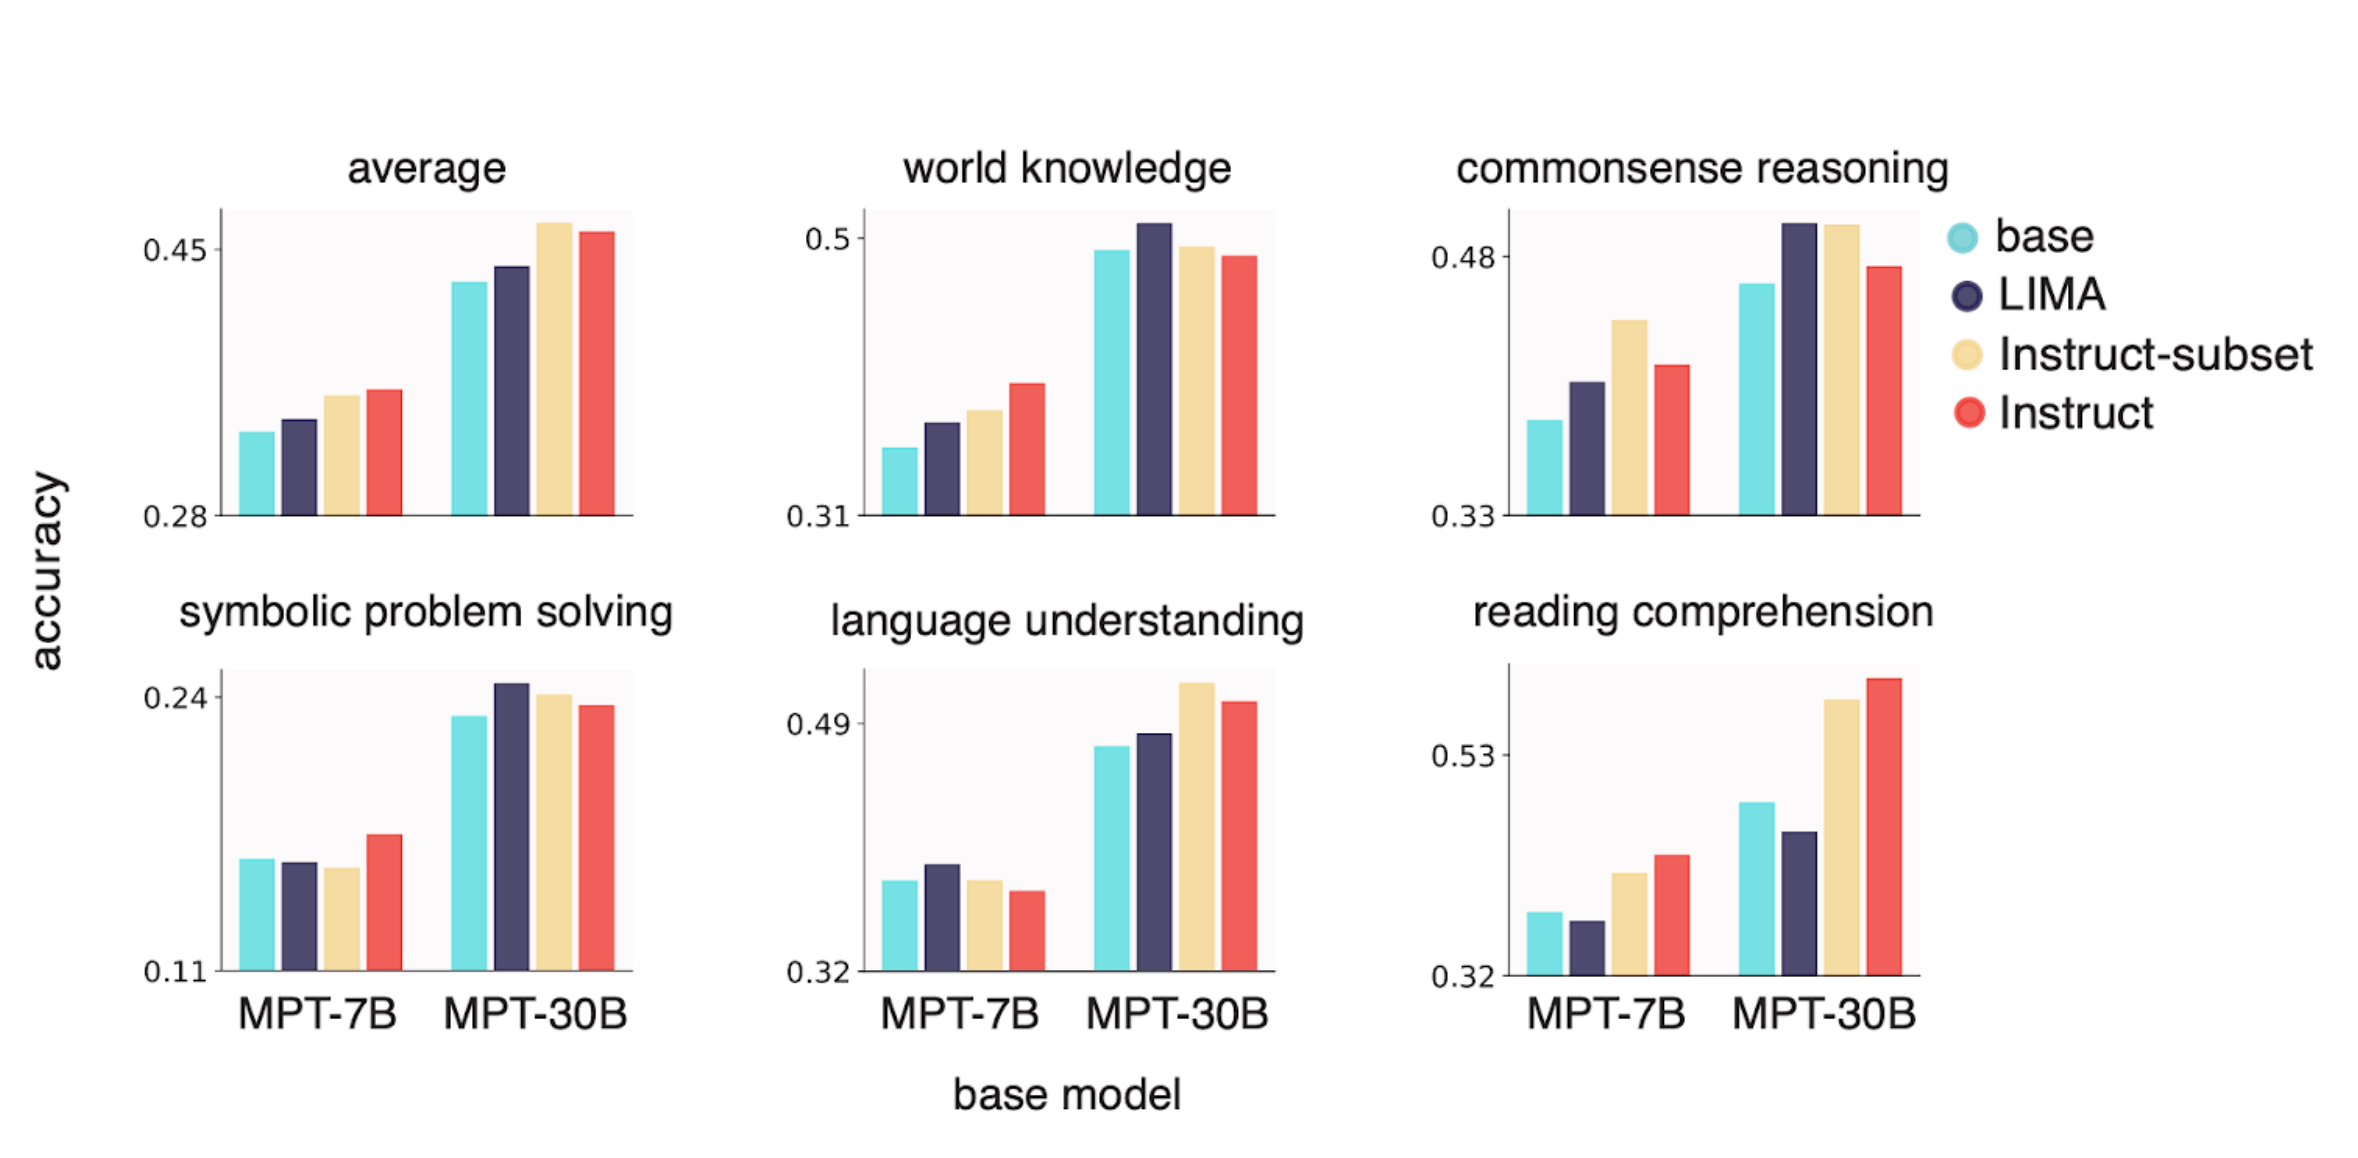
文章发现,用LIMA的1000条高质量样本微调MPT模型,在GPT-4作为评判的对话评估中表现良好,但在MMLU、BIG-bench等传统NLP基准上表现不佳。反之,从Instruct数据集中随机抽取1000-5000条样本微调,在传统基准上接近全量数据效果,却在GPT-4评估中表现较差。这表明微调数据必须与目标评估范式对齐,才能达到预期效果。
混合数据可兼顾两种评估范式
为了同时提升传统NLP基准和GPT-4评判的对话质量,作者尝试将少量Instruct样本与LIMA样本混合微调。结果显示,这种混合策略确实能在两种评估范式上都取得良好表现。这意味着,如果希望模型既能在学术基准上得分,又能像AI助手一样流畅对话,混合不同风格的数据是一个有效且低成本的方法。
风格对齐与知识注入应区分
文章强调,微调分为引入新事实知识和对齐问答风格两种目的。对于知识注入,更多数据通常更好;但如果只是让基座模型学会以特定风格回答,少量高质量样本可能就足够。LIMA的1000条样本正是用于风格对齐,而非灌输新知识。因此,在决定微调数据量前,需明确目标:是提升知识储备,还是改变回答风格。
Q&A
LIMIT 研究的主要发现是什么?
LIMIT 研究发现,仅用几千个高质量样本微调大语言模型就能提升性能,但关键细节是微调数据集必须与评估范式对齐。混合 LIMA 和指令数据微调可以同时提升传统 NLP 基准和 GPT-4 评判的对话质量。
什么是风格对齐微调?
风格对齐微调是指用少量高质量样本微调大语言模型,使其响应风格匹配特定格式(如通用 AI 助手的礼貌、段落式回答,或学术基准的简洁多选格式)。LIMA 论文提出并验证了这种方法。
为什么微调数据集需要与评估范式匹配?
因为不同评估范式期望不同的响应风格。传统 NLP 基准(如 MMLU)需要简洁、多选格式,而模型评估(如 GPT-4 评判)期望开放、段落式回答。用与评估范式不匹配的数据微调会导致在该范式上表现不佳。
LIMIT 实验中使用了哪些微调数据集?
使用了三个公开数据集:LIMA(1k 样本,高质量开放问答)、MPT Instruct-v1(59.3k 样本,含 Dolly-15k 和 HH-RLHF)、MPT Instruct-v3(56.2k 样本,含阅读理解、数学、文本到 SQL 等)。
如何同时提升传统 NLP 基准和 GPT-4 评判的对话质量?
通过混合微调数据集:将几千个指令数据样本(如 Instruct-v1/v3)与 LIMA 样本混合,用这个混合集微调模型,可以在传统 NLP 基准和 GPT-4 评判的对话评估上都取得良好表现。
LIMIT 研究对指令微调中“少即是多”的观点提供了什么证据?
研究复现了 LIMA 的结果:用 1,000 个 LIMA 样本微调 MPT 模型,在 GPT-4 评判下表现良好;用 1,000-5,000 个域内样本微调,在传统 NLP 基准上达到与全量数据相当的性能。这表明少量高质量样本足以实现风格对齐。
