

使用Scikit-LLM将大语言模型摘要功能融入你的Scikit-Learn流水线
内容提要
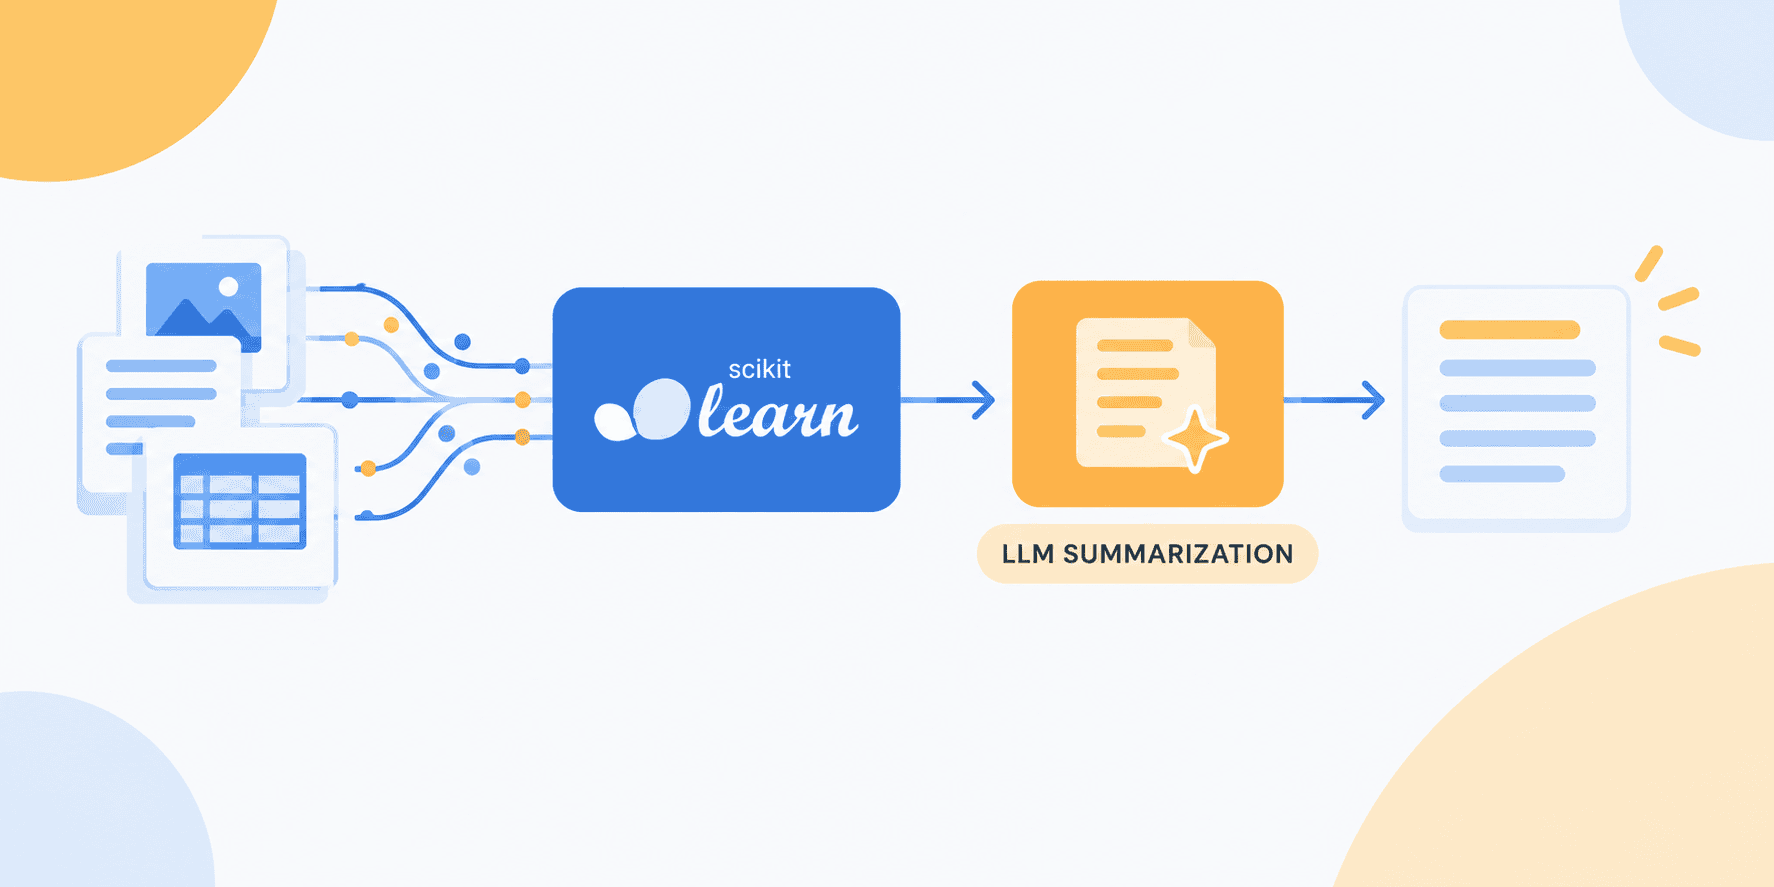
文章介绍如何用Scikit-LLM将大语言模型摘要功能嵌入scikit-learn流水线:先用Groq免费模型将冗长嘈杂文本压缩为简短摘要,再用TF-IDF向量化,最后用逻辑回归分类。整个流程可端到端训练和预测,仅需少量示例即可完成能源、金融、医疗等主题分类,兼顾LLM与传统轻量模型的优势。
延伸解读
小样本分类成功的背后机制
文章仅用三个训练样本就训练出逻辑回归分类器,作者解释这并非模型真正学会了主题概念,而是LLM摘要充当了精确过滤器,将冗长文本压缩为关键词,随后TF-IDF向量化器的词汇表被限制在这些少量词上,分类任务退化为简单的关键词匹配。这提醒读者,小样本效果依赖于摘要质量,若摘要偏离主题,分类性能会下降。
免费工具链的实用配置
整个流程可完全在Google Colab中运行,使用Groq的免费API和开源模型openai/gpt-oss-20b,无需支付token费用。配置时需将Scikit-LLM的请求地址指向Groq的OpenAI兼容端点,并通过Colab的Secret变量管理API密钥。这种设置降低了实验门槛,但需注意API密钥仅显示一次,且免费服务可能有速率限制。
流水线设计的权衡与局限
将LLM摘要作为预处理步骤嵌入scikit-learn流水线,使得端到端训练和预测成为可能,同时保留了传统轻量模型的高效性。然而,摘要步骤依赖外部API调用,会引入延迟和网络依赖,且摘要质量受模型能力影响。此外,TF-IDF仅基于摘要词频,可能丢失原文中的细微语义,适合主题分类等粗粒度任务,不适用于需要深层理解的场景。
Q&A
Scikit-LLM 是什么?它如何与 scikit-learn 结合使用?
Scikit-LLM 是一个将大语言模型(LLM)功能集成到 scikit-learn 流水线中的工具。它提供了如 GPTSummarizer 等估计器,可以像 scikit-learn 组件一样在 Pipeline 中使用,从而在传统机器学习流程中无缝嵌入 LLM 驱动的文本摘要等任务。
如何用 Groq 的免费 API 配置 Scikit-LLM?
首先在 Groq 网站注册并生成 API 密钥,然后在 Google Colab 中将其保存为名为 GROQ_API_KEY 的 Secret 变量。接着在代码中通过 SKLLMConfig.set_gpt_url("https://api.groq.com/openai/v1") 和 SKLLMConfig.set_openai_key(groq_key) 将请求路由到 Groq 的免费端点。
这个 LLM 摘要加分类的流水线具体包含哪些步骤?
流水线包含三个步骤:1) 使用 GPTSummarizer 对长文本进行摘要,压缩为简短文本;2) 使用 TfidfVectorizer 将摘要转换为 TF-IDF 向量;3) 使用 LogisticRegression 分类器进行分类。整个流水线可以端到端训练和预测。
为什么仅用三个训练样本就能训练出有效的分类器?
因为 LLM 摘要器首先将嘈杂文本压缩为包含关键信息的简短摘要,然后 TF-IDF 向量化器仅基于这些摘要中的少量词汇构建特征空间,使得分类任务简化为关键词匹配,逻辑回归很容易学习。
这个流水线在预测新文本时是如何工作的?
对于新文本,流水线会自动依次执行:先用 GPTSummarizer 生成摘要,再用 TfidfVectorizer 将摘要转换为向量,最后用训练好的 LogisticRegression 进行分类,输出预测类别。中间摘要可以通过 named_steps['summarizer'].transform() 获取。
使用 Scikit-LLM 和 Groq 构建这样的流水线有什么优势?
优势包括:完全免费(使用 Groq 免费模型),无需微调 LLM,仅需少量示例即可工作,结合了 LLM 的摘要能力与传统轻量模型(TF-IDF 和逻辑回归)的效率,整个流程在 scikit-learn 框架内无缝集成,易于实现和部署。
