

模块化:在Mojo🔥中快速⚡实现k-means聚类:Python到Mojo🔥加速k-means聚类的移植指南
内容提要
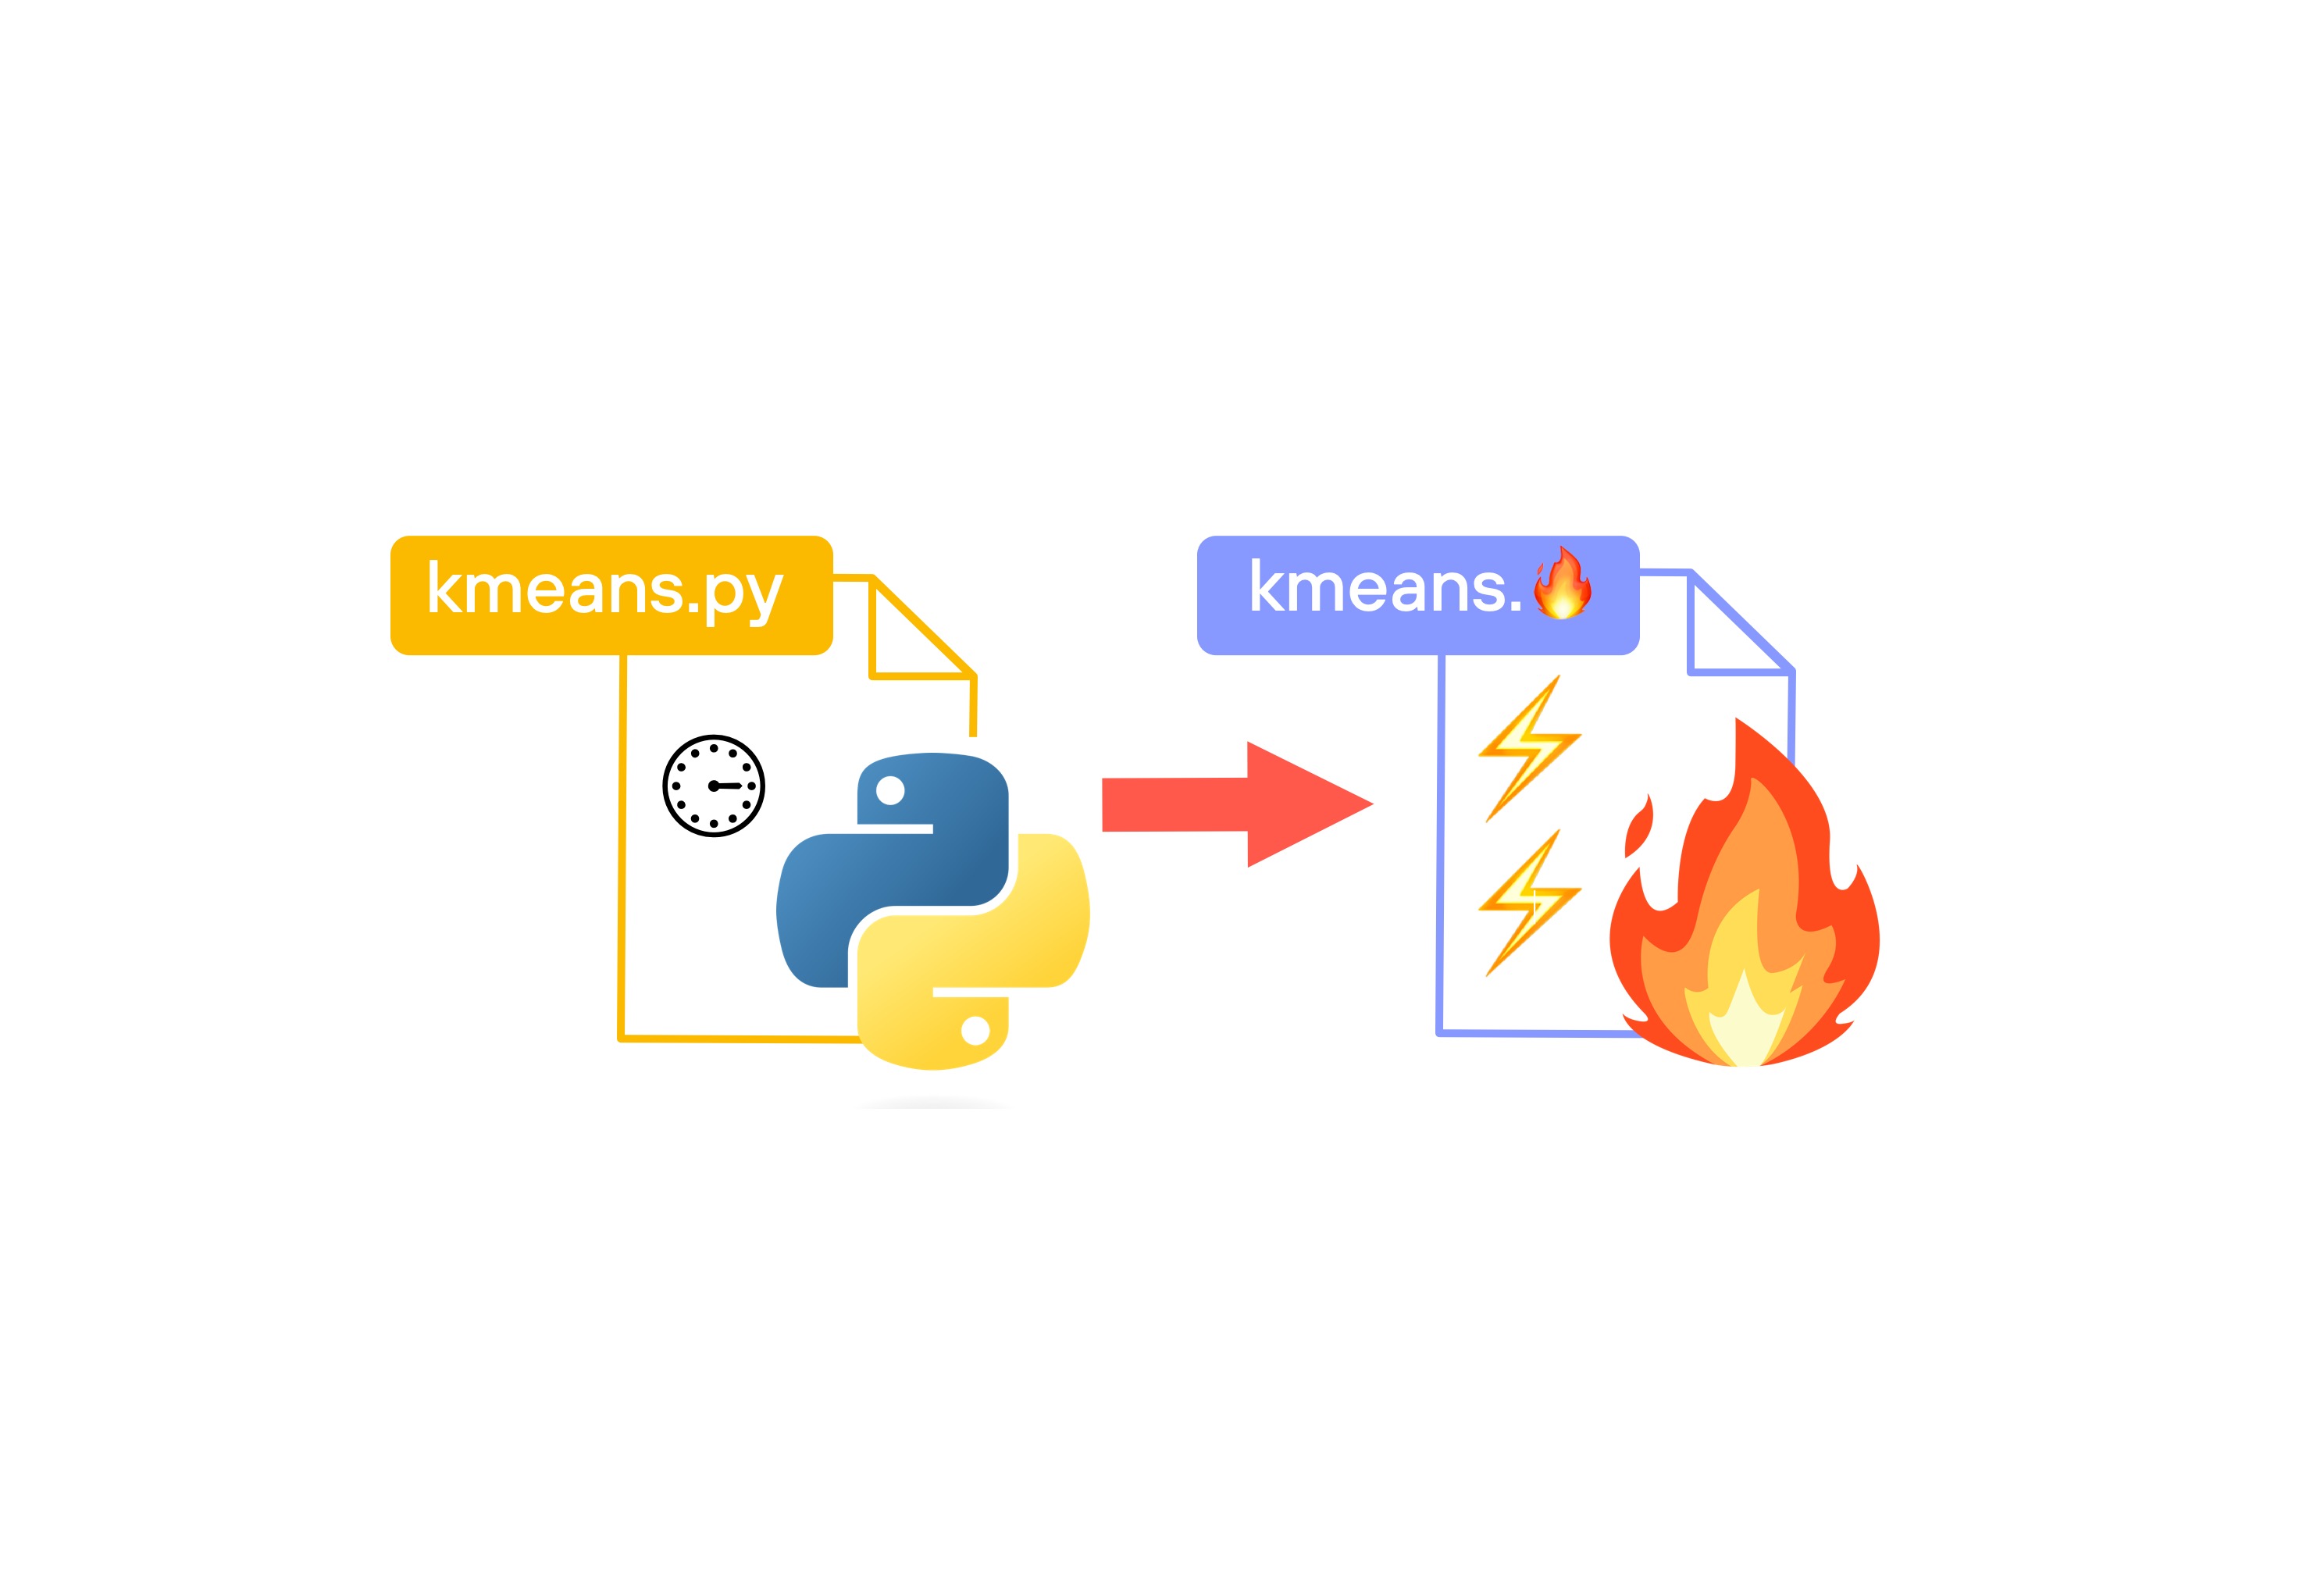
本文讨论了k-means聚类算法及其在Python和Mojo中的实现。k-means算法根据数据点到质心的距离将其分组成簇。文章提供了代码示例,并比较了Python+NumPy和Mojo实现的性能。由于其向量化和并行化能力,Mojo提供了显著的加速。文章还包括基准测试结果,并提供了Python和Mojo实现之间的代码差异的见解。
延伸解读
性能提升的幅度与条件
文章基准测试显示,Mojo实现的k-means相比Python+NumPy有6到250倍的加速,具体取决于数据集规模、特征数量和聚类数。例如,在3000样本、100特征、5簇的配置下,Mojo比Python快约14倍,比scikit-learn快约6倍。但作者强调,加速比受多种因素影响,并非固定值,实际性能需结合具体工作负载评估。
从Python迁移到Mojo的关键改动
移植代码时,主要变化包括:用struct替代class,用fn替代def并添加类型声明,变量需用var声明,以及用Mojo标准库函数替换NumPy操作。此外,Mojo中需手动实现矩阵操作和向量化距离计算,而Python依赖NumPy的C实现。这些改动旨在利用Mojo的编译时优化和并行化能力。
与scikit-learn的对比及收敛差异
在相同配置下,Mojo实现比scikit-learn快6倍以上,即使scikit-learn收敛所需的迭代次数更少。文章指出,scikit-learn可能因初始质心更接近最终解或使用多种收敛准则而更快收敛。但Mojo通过向量化和并行化,在每次迭代中计算距离的效率更高,从而在总时间上胜出。
实现细节与性能权衡
Mojo版本手动实现了向量化和并行化的欧氏距离计算,利用SIMD指令和parallelize函数加速。但作者也指出,在特征数增加时,加速比可能下降,因为受限于本地机器的核心数。这表明Mojo的性能优势依赖于硬件并行能力,在多核系统上可能更显著。
Q&A
k-means聚类算法的基本原理是什么?
k-means聚类算法通过迭代将数据点分配到最近的质心,并不断更新质心以减少簇内距离。
Mojo与Python在实现k-means聚类时有什么主要区别?
Mojo在类型声明和性能优化方面有所不同,且通过向量化和并行化能力显著加速了k-means算法的执行。
使用k-means++算法有什么好处?
k-means++算法用于选择初始质心,以提高收敛速度和聚类效果。
Mojo的k-means实现相比Python+NumPy快多少?
在基准测试中,Mojo的k-means实现比Python+NumPy快6到250倍,具体取决于数据集的规模和特征数量。
如何将Python代码迁移到Mojo以提高性能?
迁移时需要添加类型声明,使用Mojo特有的强类型和向量化特性,以实现显著的性能提升。
k-means聚类的基准测试结果如何?
基准测试显示Mojo的k-means实现相较于Python和scikit-learn在速度上有显著提升,尤其在处理大规模数据时。
