
实时零售智能:在Databricks上使用Lakebase和AI搜索构建电商推荐系统
内容提要
某亚洲时尚电商平台基于Databricks构建实时个性化推荐系统,服务百万月活用户和十万级SKU,每秒处理约千条事件。系统采用湖仓分层架构与特征存储,确保训练与推理一致。推荐分批量预计算(首页等)和实时会话评分(相似商品等)两条路径,均实现毫秒级响应,并支持冷启动、模型迭代与漂移监控。
延伸解读
双路径服务架构的权衡
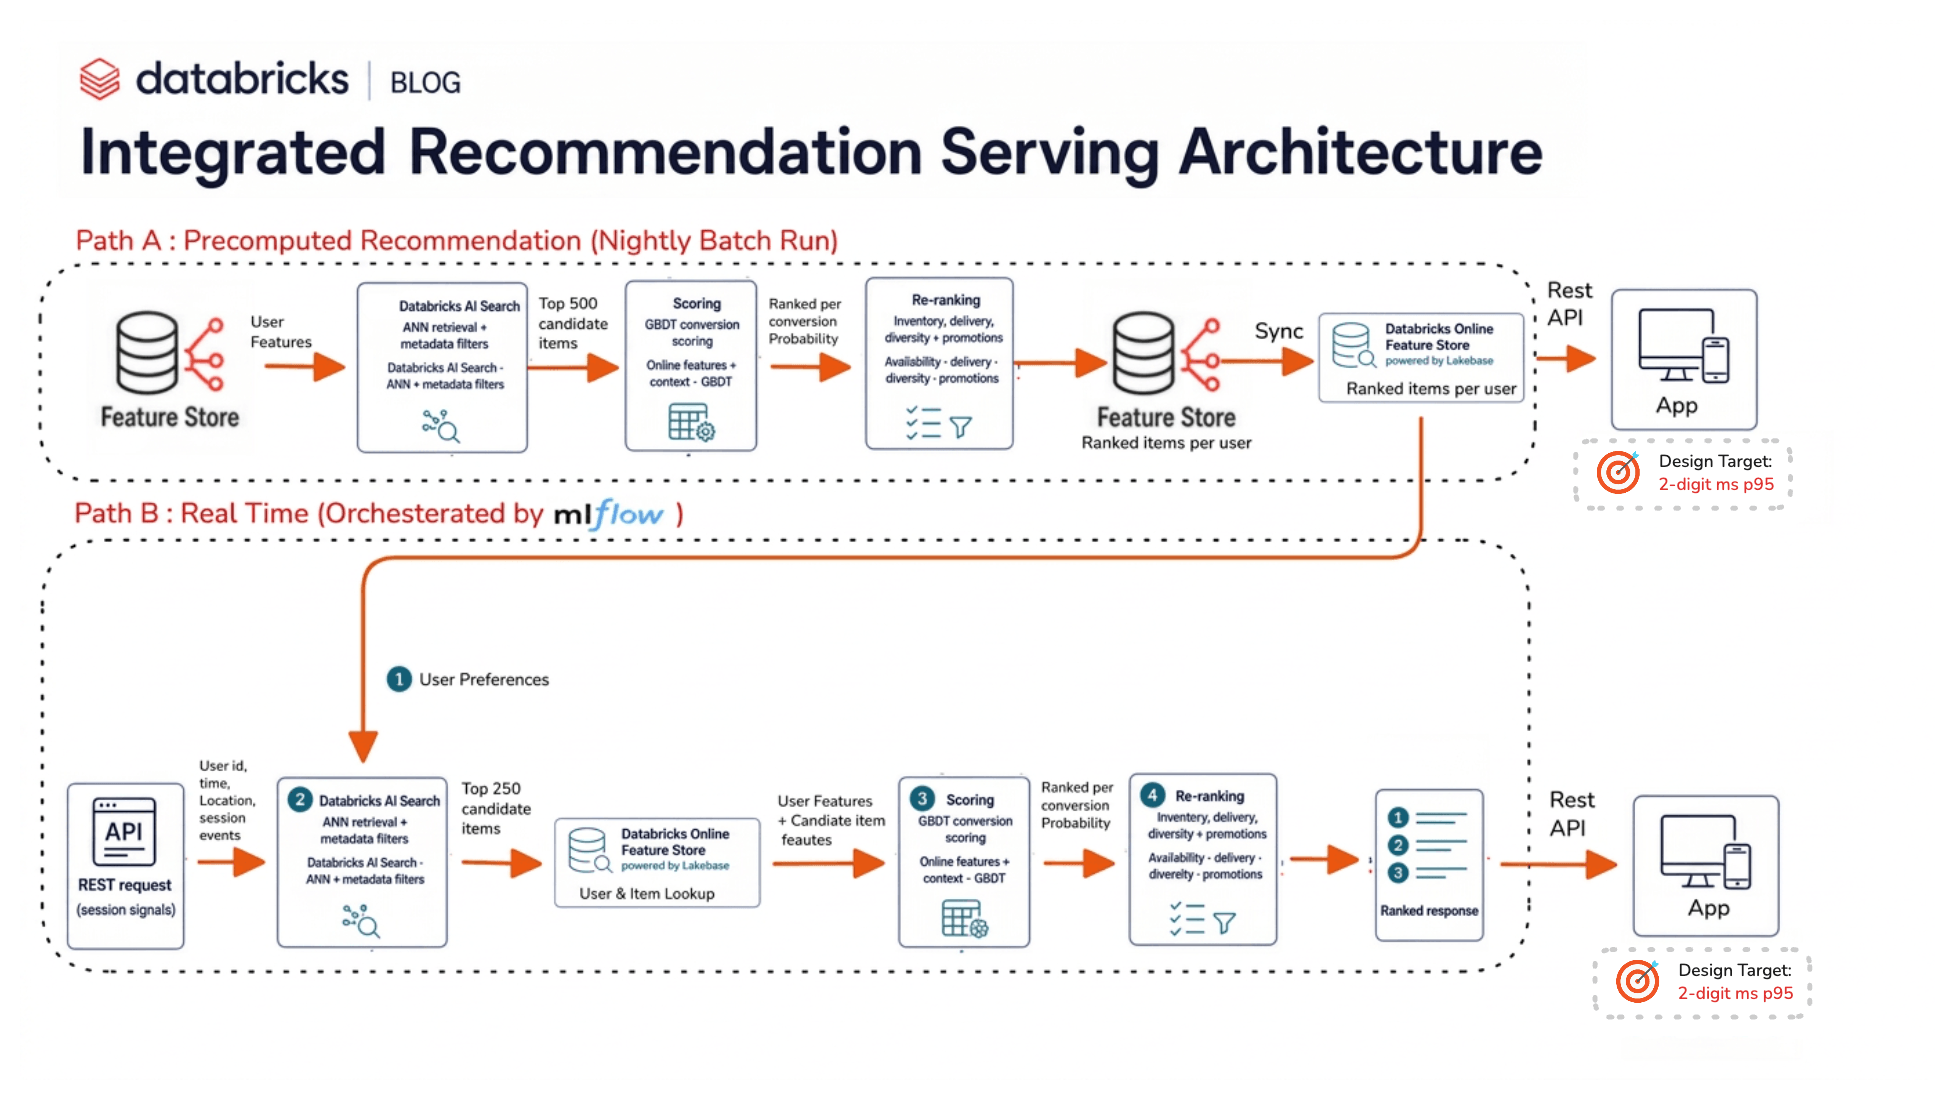
文章将推荐服务分为批量预计算和实时会话评分两条路径。批量路径每晚运行,结果写入Lakebase供键值查询,延迟极低但新鲜度限于前一天;实时路径在请求时同步执行完整漏斗,延迟也在两位数毫秒内,但依赖请求负载中的会话信号。这种设计平衡了吞吐与实时性,适合首页等稳定场景和相似商品等动态场景。
冷启动策略的工程实现
针对新用户和新商品,系统分别采用默认嵌入和属性嵌入。新用户基于人口统计信号构建初始向量,并随交互快速收敛;新商品从标题、类别、品牌、价格和图像特征生成嵌入,通过最近邻继承初始分数,并在下一次每日批量中露出。这些方法无需历史行为数据,但依赖属性质量和嵌入更新频率。
特征一致性与治理机制
Databricks Feature Store统一管理离线和在线特征,确保训练与推理使用相同定义,避免偏差。Unity Catalog提供从原始点击流到最终预测的完整血缘和细粒度访问控制,保护PII的同时允许聚合特征用于训练。特征按不同节奏刷新:行为聚合每日更新,商品目录每周同步,嵌入每日重算,以平衡新鲜度与计算成本。
模型迭代与漂移监控
模型每周通过Databricks Workflows重新训练,MLflow管理实验跟踪和版本。平台支持冠军/挑战者部署,根据在线指标逐步切换流量。监控涵盖ML指标和业务KPI(点击率、转化率、每会话收入),并自动检测特征和预测分数漂移。服务日志通过请求级标识关联回训练管道,确保反馈循环产生无泄漏的训练数据。
Q&A
这个电商推荐系统每天要处理多少事件?数据是怎么接入的?
系统每秒处理约1000条事件,包括商品浏览、搜索、加购、购买和会话元数据。数据通过Lakeflow Connect的Zerobus Ingest接入,直接写入Unity Catalog的Delta表,无需自建消息代理。Zerobus兼容标准Kafka生产者客户端,只需修改bootstrap server配置即可。
推荐系统如何保证训练和推理时特征的一致性?
通过Databricks Feature Store管理离线特征(用于训练)和在线特征(用于服务),确保训练和推理使用相同的特征定义。在线特征通过Lakebase在线表提供,推理时自动可用。Unity Catalog治理所有层,提供从原始点击流到最终预测的血缘追踪。
批量预计算推荐和实时会话推荐分别用在哪些场景?
批量预计算(Path A)用于首页轮播、分类页排名、邮件和推送等用户身份和场景已知的界面,每晚批量计算并存入Lakebase,服务时直接键值查询。实时会话评分(Path B)用于商品详情页的“相似商品”、“搭配推荐”或动态重排搜索结果,需要根据用户当前会话信号实时计算。
系统如何处理新用户和新商品的冷启动问题?
新用户:根据人口统计信号(位置、设备类型、注册上下文等)构建默认用户嵌入,用于ANN搜索,随着交互快速收敛到真实偏好。新商品:根据商品属性(标题、类别、品牌、价格、图像特征)生成嵌入,通过向量空间找到相似商品并继承初始推荐分数,新商品在下一个每日批量周期中展示。
模型是如何迭代和监控的?
模型每周通过Databricks Workflows重新训练,使用MLflow进行实验跟踪和版本管理。支持冠军/挑战者部署,根据在线性能指标逐步切换流量。监控包括ML指标和业务KPI(点击率、转化率、每会话收入),并自动检测特征分布或预测分数分布的漂移,触发调查或加速重训练。
实时推荐路径的延迟是多少?如果超时有什么降级策略?
实时会话评分路径(Path B)的延迟在两位数毫秒以内(< 2-digit ms)。如果实时路径超出延迟预算,系统会优雅降级,返回缓存的热门商品或Path A中预计算的用户推荐结果。
