


视频人脸修复方案 :无需预对齐的解析引导时序一致性模型 PGTFormer
内容提要
该论文提出了一种名为PGTFormer的盲视频人脸修复模型,通过语义解析的引导选择最佳的面部先验,生成时序一致且无伪影的结果。该模型无需面部预对齐,能提高视频的时序一致性。在多个定量指标和主观视觉对比实验中,该方法表现优异。
延伸解读
无需预对齐:简化流程与降低误差
传统视频人脸修复通常依赖复杂的对齐操作,以确保帧间匹配,但这会增加计算成本并可能引入对齐误差。PGTFormer通过端到端设计去除对齐步骤,利用语义解析引导先验选择,从而简化流程并避免对齐误差,提升修复效率。
两阶段训练:先验构建与修复协同
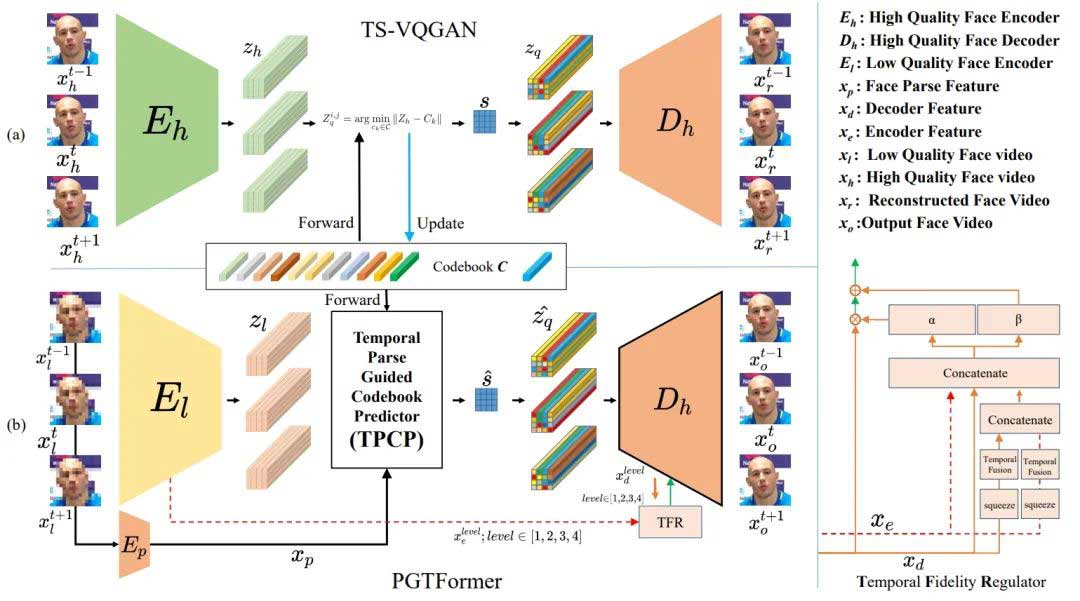
PGTFormer采用两阶段训练:首先训练TS-VQGAN,通过自监督学习从高质量视频人脸中提取时空先验;然后训练PGTFormer,利用这些先验进行修复。这种协同工作方式为修复任务提供了丰富的先验知识,有助于在复杂姿态和光照下保持一致性。
定量指标全面领先:PSNR、SSIM与LPIPS
在公开数据集上,PGTFormer在PSNR、SSIM和LPIPS等指标上均优于现有方法。例如,在对齐视频上PSNR达30.74,SSIM为0.8668,LPIPS为0.2095;非对齐视频上分别为29.66、0.8408和0.2230。这些结果证明了其在图像重建、结构保持和感知质量方面的优势。
主观视觉提升:细节与自然度
主观对比实验显示,PGTFormer在恢复眼睛、嘴巴等关键部位时纹理更清晰自然,伪影更少,色彩还原度更高。时序保真度调节器(TFR)增强了帧间时序关联,减少了抖动和不稳定现象,使修复结果更连贯自然。
Q&A
PGTFormer模型的主要创新点是什么?
PGTFormer模型的主要创新点在于无需面部预对齐,通过解析引导选择最佳面部先验,显著提升视频人脸修复的时序一致性和效率。
PGTFormer是如何提高视频人脸修复的时序一致性的?
PGTFormer通过时序保真度调节器增强时序特征的交互,从而提高视频的整体一致性和自然感。
PGTFormer与传统视频人脸修复方法相比有什么优势?
PGTFormer相比传统方法,去除了复杂的对齐操作,采用端到端设计,提升了修复的连贯性和效率。
PGTFormer在定量指标上表现如何?
PGTFormer在PSNR和SSIM等多个定量指标上表现优异,超越了现有的修复方法,证明了其在高质量图像重建方面的能力。
PGTFormer的训练过程分为几个阶段?
PGTFormer的训练过程分为两个阶段:第一阶段是TS-VQGAN训练,第二阶段是PGTFormer训练。
PGTFormer在主观视觉对比实验中表现如何?
在主观视觉对比实验中,PGTFormer在细节保留和自然度上表现突出,尤其在面部关键部位的纹理还原上更为清晰自然。
