


TinyAgent:边缘计算中的功能调用
内容提要
本文介绍了TinyAgent,一个小型语言模型,旨在实现本地功能调用,提升用户查询处理能力。通过高质量数据训练和优化提示大小,TinyAgent在Mac上实现了高效、私密的部署,成功率超过GPT-4-Turbo。关键在于使用LLMCompiler框架和Tool RAG方法,确保模型能够准确调用所需功能。
延伸解读
边缘部署的隐私与延迟优势
文章指出,云端推理面临数据隐私、网络连接和延迟三大挑战。将模型部署在本地边缘设备,如MacBook,可以避免上传敏感数据到第三方,无需稳定网络连接,并减少数据传输时间,从而提升响应速度。TinyAgent的设计目标正是为了解决这些问题,实现高效、私密的本地功能调用。
小模型如何实现复杂推理
传统观点认为,大模型的涌现能力与其参数记忆中存储的通用世界知识相关。但TinyAgent的研究表明,通过高质量、专门针对功能调用的数据微调,小模型无需记忆通用知识也能获得复杂推理能力。在Mac助手场景中,模型只需理解用户查询并调用预定义API,这为小模型在语义系统中的应用提供了新思路。
Tool RAG:优化提示大小的关键
为了在资源受限的设备上高效运行,TinyAgent采用Tool RAG方法动态选择相关工具。与简单RAG不同,Tool RAG将工具选择视为多标签分类问题,使用微调的DeBERTa模型预测所需工具。实验显示,平均仅需3.97个工具即可达到0.998的召回率,提示大小减少约2倍,同时提升了准确率。
量化技术助力实时推理
即使对于1B参数的小模型,在MacBook上部署仍可能面临内存和延迟挑战。TinyAgent通过4-bit量化(组大小32)将模型大小减少4倍,延迟降低30%,且准确率略有提升。这使得TinyAgent-1.1B在本地部署时,端到端延迟仅2.9秒,成功率达80.35%,超过了GPT-4-Turbo的79.08%。
Q&A
TinyAgent是什么?
TinyAgent是一个小型语言模型,旨在实现本地功能调用,提升用户查询处理能力。
TinyAgent如何提高功能调用的准确性?
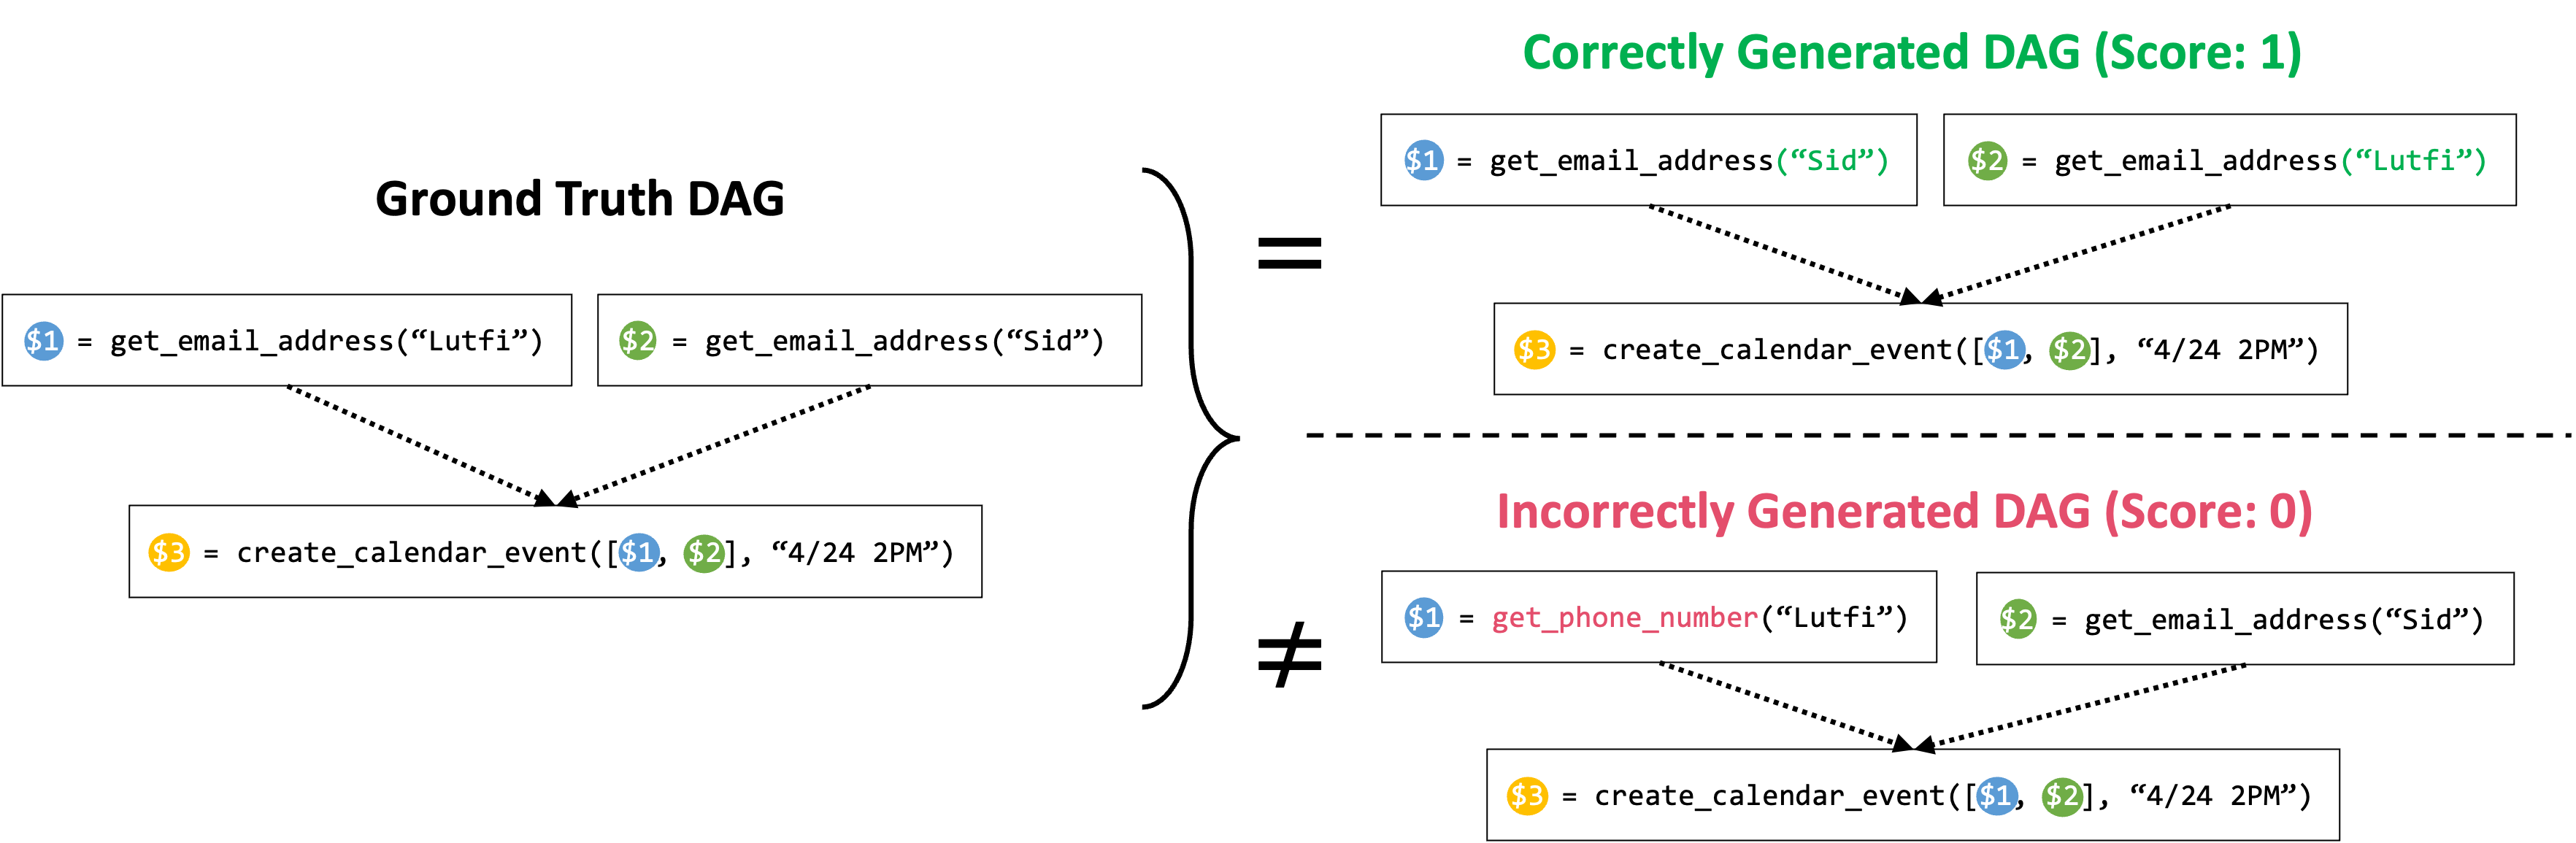
TinyAgent通过使用LLMCompiler框架和精心策划的高质量数据集进行微调,从而显著提升功能调用的准确性。
TinyAgent与GPT-4-Turbo相比有什么优势?
TinyAgent的成功率超过GPT-4-Turbo,并且能够在本地高效、私密地部署。
TinyAgent是如何实现本地部署的?
TinyAgent通过量化技术和优化提示大小,使得模型能够在资源有限的设备上高效部署。
Tool RAG方法在TinyAgent中起什么作用?
Tool RAG方法通过选择相关工具来优化提示大小,提高了模型的性能和响应速度。
TinyAgent如何处理用户查询?
TinyAgent通过调用预定义的API和函数来完成用户的命令,而不需要记忆通用世界知识。
