


对比表示学习
内容提要
对比学习通过优化嵌入空间使相似样本靠近、不相似样本远离,适用于监督与无监督场景。文章梳理了对比损失、三元组损失、N-pair、NCE、InfoNCE等训练目标,以及SimCLR、MoCo、BYOL、CLIP等视觉方法,并介绍文本增强、SimCSE、SBERT等句子嵌入技术。
延伸解读
对比学习损失函数的演进逻辑
从对比损失、三元组损失到N-pair、InfoNCE,训练目标的核心变化是每次比较的样本数量。早期方法只用一个正样本和一个负样本,后续方法将多个正负样本纳入同一批次,利用批内负样本提升效率。InfoNCE还建立了与互信息优化的联系,为自监督学习提供了理论支撑。理解这一演进有助于根据任务需求选择合适的损失函数。
视觉自监督方法的关键设计差异
SimCLR依赖大batch提供负样本,MoCo用队列和动量编码器解耦batch大小与负样本数量,BYOL则完全不用负样本,通过在线网络和目标网络的交互避免表示坍塌。Barlow Twins另辟蹊径,用冗余减少项替代负样本。这些差异直接影响训练成本和硬件需求,例如SimCLR需要大量显存,而MoCo和BYOL对batch大小更友好。
数据增强与负样本采样的实践要点
数据增强是对比学习成功的关键,随机裁剪和颜色扰动被证明特别有效,但增强强度需平衡语义不变性。负样本方面,困难负样本能提升模型判别力,但在无监督设定下容易采样到假阴性,导致性能下降。去偏对比损失和困难负样本挖掘方法通过调整采样概率来缓解这一问题,实际应用中需注意批次内负样本的质量。
文本与多模态对比学习的扩展
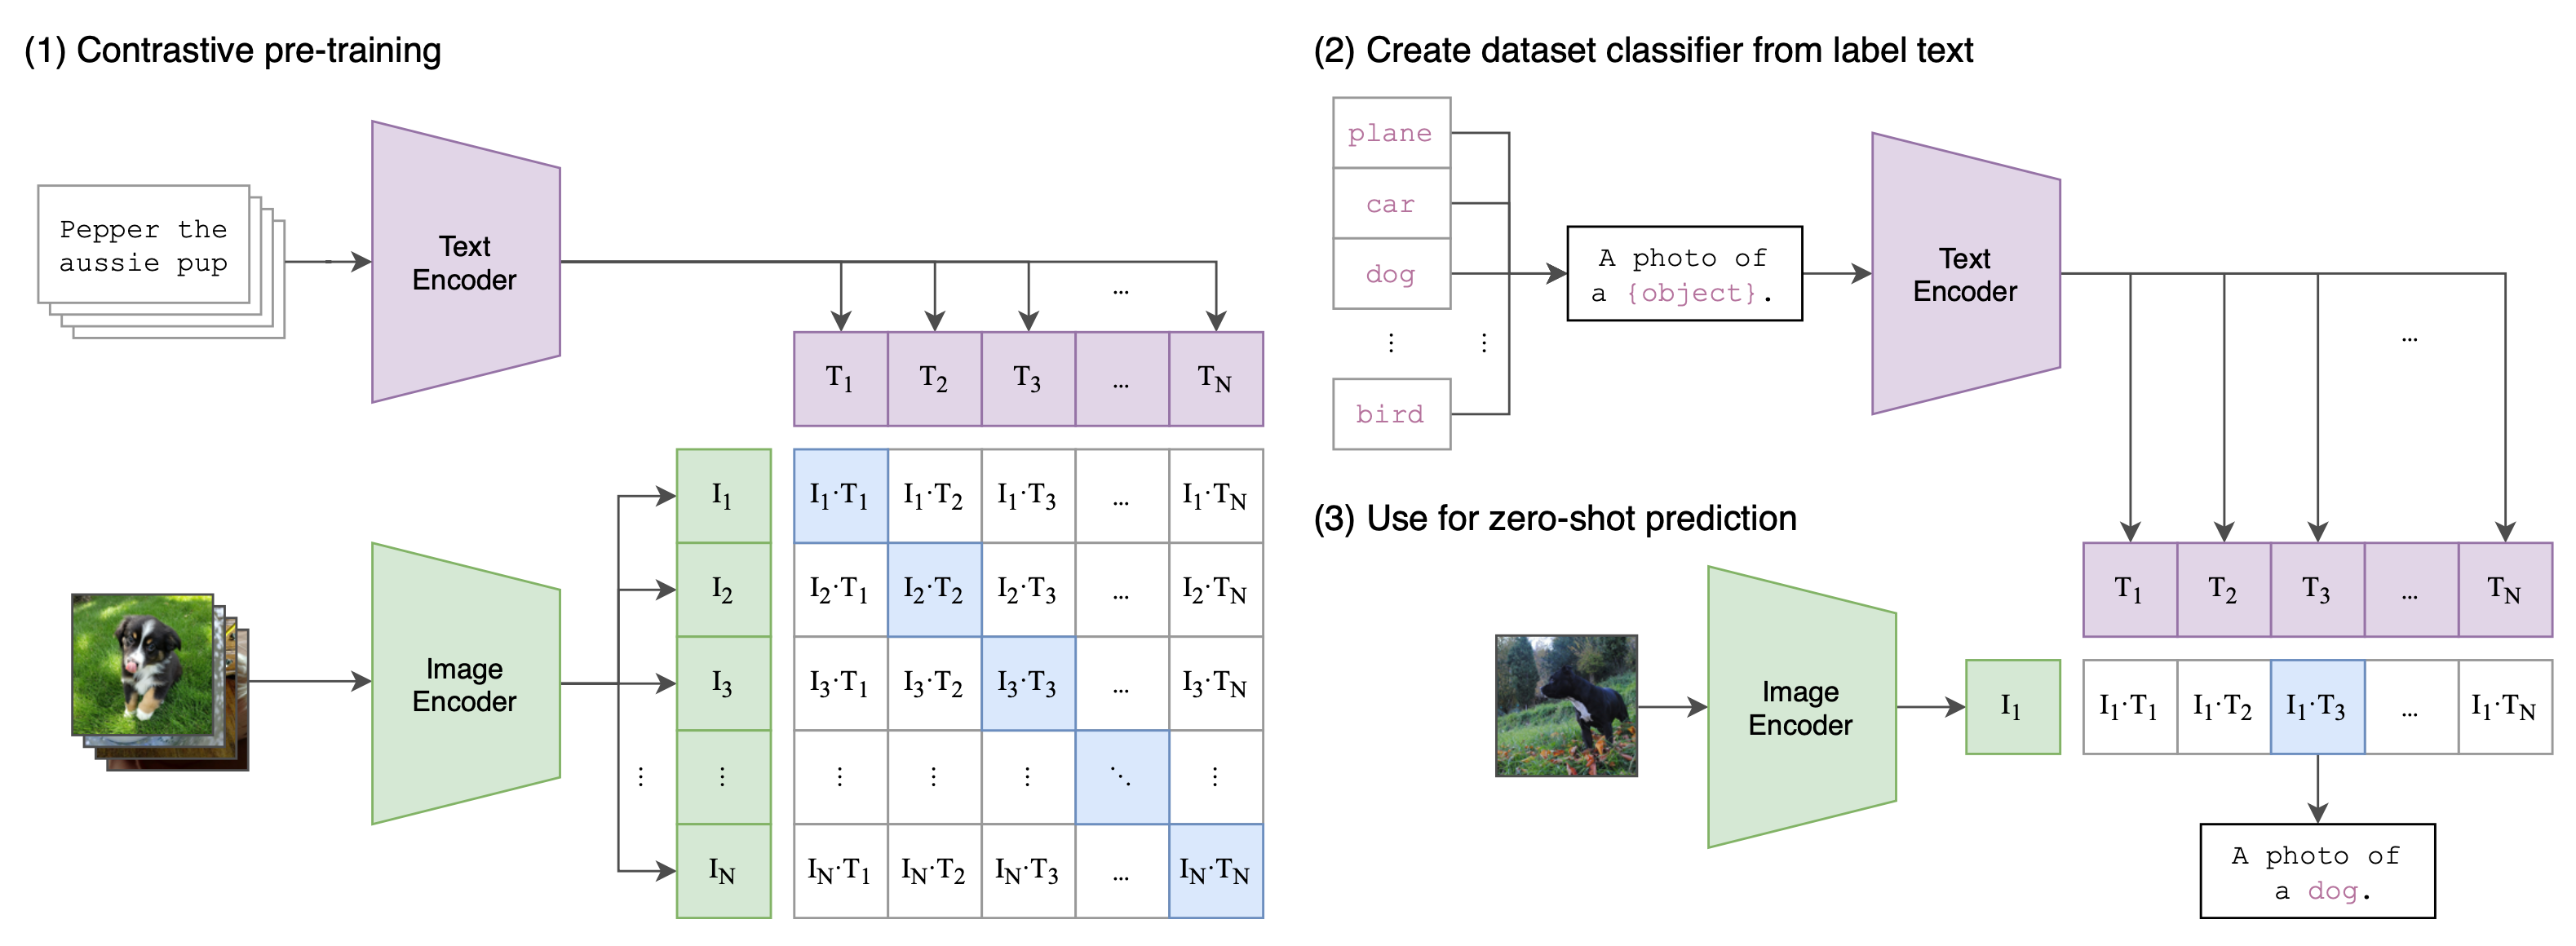
对比学习不仅用于视觉,也扩展到文本和多模态。SimCSE利用dropout作为文本增强,SBERT通过句子对训练句子嵌入。CLIP则用4亿图文对进行对比预训练,将自然语言作为监督信号,实现零样本图像分类。这些方法表明,对比学习的框架具有通用性,但需要针对不同模态设计合适的增强和负样本策略。
Q&A
对比表示学习的核心目标是什么?
对比表示学习的核心目标是学习一个嵌入空间,使得相似的样本对彼此靠近,而不相似的样本对彼此远离。
对比学习中的InfoNCE损失是如何定义的?
InfoNCE损失使用分类交叉熵来从一组不相关的噪声样本中识别正样本。给定上下文向量c,正样本从条件分布p(x|c)中抽取,N-1个负样本从与上下文独立的提议分布p(x)中抽取。损失函数为:L_InfoNCE = -E[log( f(x,c) / sum_{x' in X} f(x',c) )],其中f(x,c)估计密度比p(x|c)/p(x)。
SimCLR和MoCo在负样本处理上有什么主要区别?
SimCLR需要大批次大小以包含足够的负样本,性能会随批次减小而下降;而MoCo使用一个队列作为动态字典,将批次大小与负样本数量解耦,通过动量编码器更新键编码器,因此不依赖大批次。
BYOL为什么不需要负样本也能工作?
BYOL通过在线网络和目标网络的交互学习,目标网络参数是在线网络参数的指数移动平均。它直接引导潜在表示,不使用负样本。但后续研究发现,批归一化的存在隐式地引入了对比学习效果,防止模型崩溃,因此负样本对于避免模型崩溃仍然重要。
对比学习中的困难负样本挖掘是什么?为什么重要?
困难负样本是与锚点样本标签不同但嵌入特征非常接近的样本。挖掘困难负样本对于模型学习有意义的表示至关重要,因为它能迫使模型更好地区分相似但不相同的样本。在监督数据中可以利用标签识别,在无监督中可通过增大批次或内存库来隐式引入,但会带来内存负担。
CLIP是如何利用文本-图像对进行对比学习的?
CLIP联合训练文本编码器和图像特征提取器,在预训练任务中预测哪个标题对应哪个图像。给定一批N个(图像,文本)对,CLIP计算所有N×N个候选对的密集余弦相似度矩阵,通过对称交叉熵损失最大化正确对的相似度,最小化错误对的相似度。
