


Amazon S3 表类数据存储服务现在支持将 Apache Hive 表托管迁移至 Apache Iceberg
内容提要
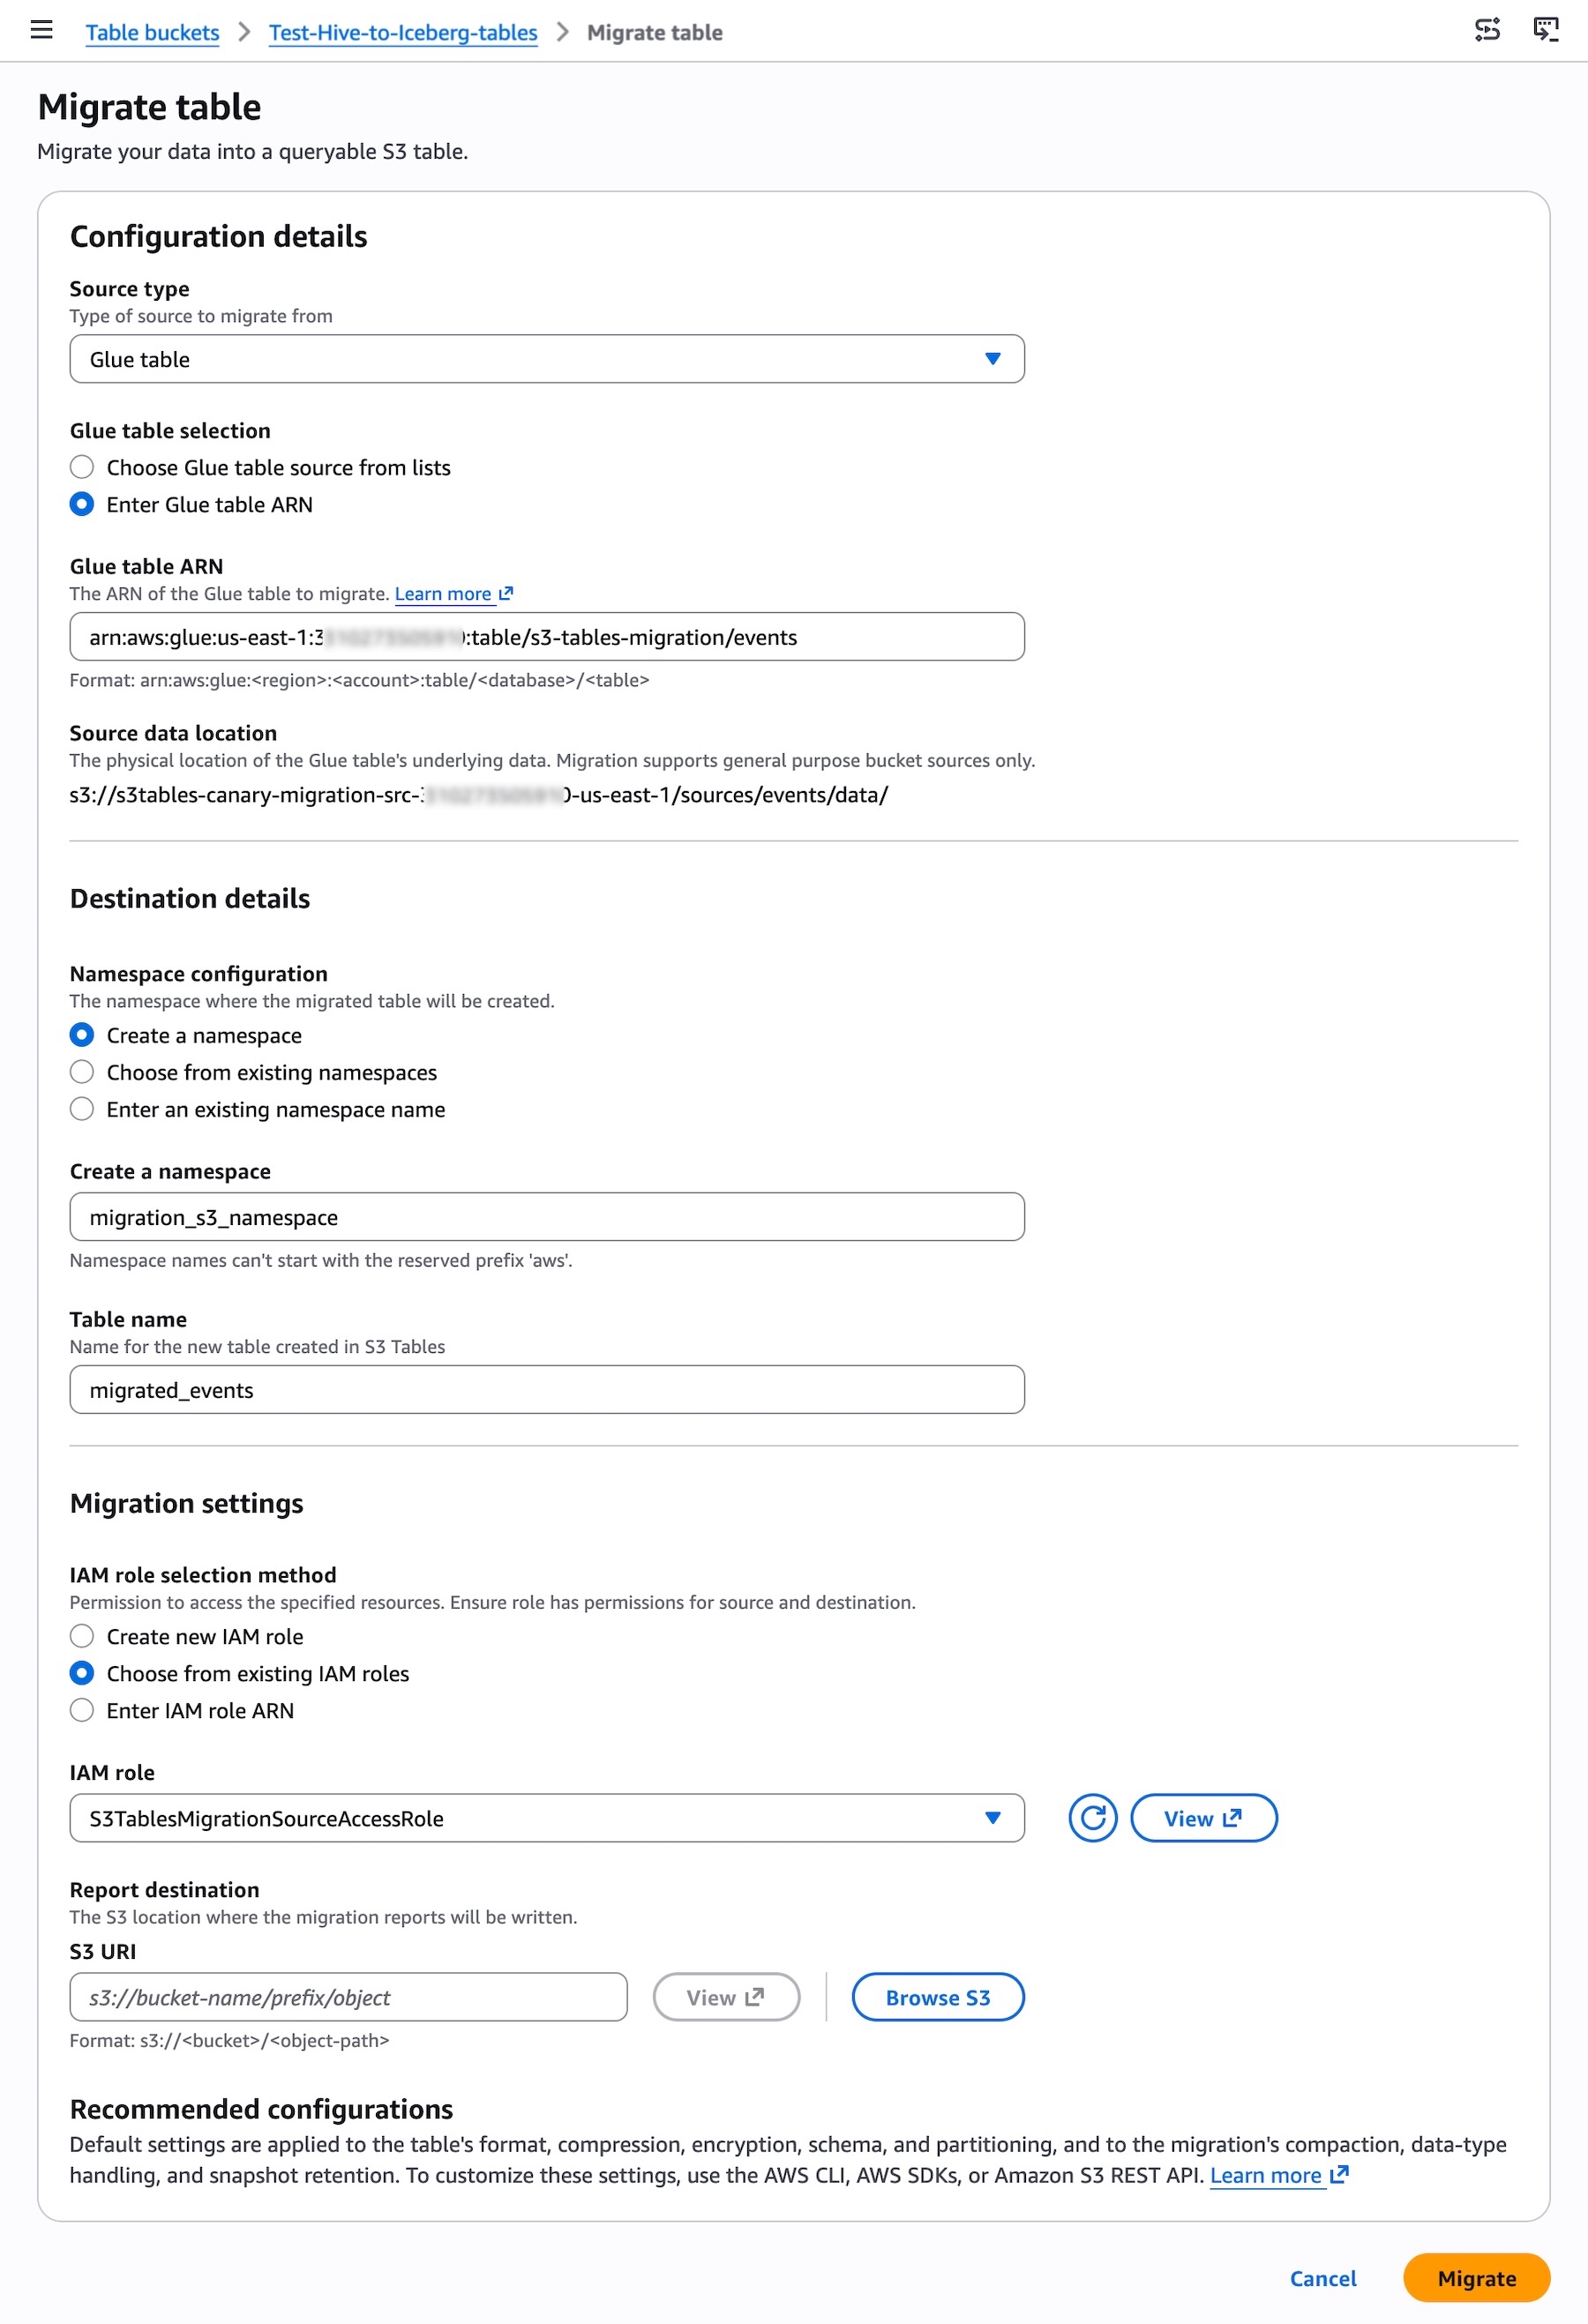
Amazon S3 表类数据存储服务新增托管迁移功能,可将 AWS Glue 中注册的 Parquet 格式 Apache Hive 表迁移至 Apache Iceberg,无需自建管道或预置计算资源,生产负载基本保持运行。服务自动完成数据验证、兼容性检查、类型转换、文件重压缩与合并,支持多次增量同步,仅在切换时短暂离线。按复制数据量计费,源对象保留原存储层。可通过控制台、CLI、SDK 或 Agent Toolkit 操作,已在美、亚太多区域推出。
延伸解读
迁移范围与前置条件
该托管迁移并非适用于所有 Hive 表。文章明确,目前仅支持在 AWS Glue Data Catalog 中注册、以 Parquet 格式存储、且位于同一 AWS 账户和同一 AWS 区域内的 Hive 表。迁移前服务会识别源对象并生成兼容性报告,但用户需自行确认表结构、数据类型等是否在支持范围内,避免因不满足条件而中断迁移。
增量同步与切换窗口
迁移过程支持多次增量同步,每次仅复制变更内容,源表在同步期间仍可写入,因此生产负载基本不受影响。但完成迁移时存在短暂离线窗口,文章描述为“几分钟”。这意味着团队需为最终切换预留操作时间,并确保下游查询在切换期间有应对策略,而非完全无感。
成本与存储层保留
费用仅按复制的数据量计算,不收取 Hive 到 Iceberg 的转换费用。同时,源对象在 S3 智能分层中的访问层保持不变,不会因迁移而触发额外的存储层变更成本。对于数据量较大的表,复制量是主要成本驱动因素,增量同步虽减少重复复制,但首次全量复制仍需纳入预算评估。
操作方式与自动化辅助
迁移可通过控制台、AWS CLI、SDK 或 Agent Toolkit for AWS 发起。文章示例展示了 start-table-migration 命令及 JSON 参数,包括目标表属性、迁移策略和报告输出位置。Agent Toolkit 中的迁移技能可分析 IAM 策略、验证计划并执行开始、同步、完成调用,适合希望减少手动步骤的团队,但需注意该技能为辅助工具,最终切换仍需人工确认。
Q&A
Amazon S3 表类数据存储服务新支持的托管迁移功能是什么?
该功能可将 AWS Glue Data Catalog 中注册的 Parquet 格式 Apache Hive 表迁移至 Apache Iceberg,无需自建管道或预置计算资源,生产负载基本保持运行。
迁移过程中源表还能继续写入吗?切换时会不会停机?
可以。迁移支持多次增量同步,同步期间不会停止对源表的写入操作;仅在最终切换时会有几分钟的短暂离线。
S3 表类数据存储服务托管迁移如何收费?
只需为复制的数据量付费,无需为 Hive 到 Iceberg 的转换付费;源对象保留在其当前存储层(如 S3 智能分层)中。
迁移工作流会自动完成哪些步骤?
服务自动处理数据验证、兼容性检查、类型转换、文件重新压缩和文件合并,并在复制数据前生成兼容性报告。
可以通过哪些方式发起和管理迁移?
可通过 S3 控制台、AWS CLI、AWS SDK 或 Agent Toolkit for AWS 操作,例如使用 start-table-migration 命令启动迁移。
这个托管迁移功能目前在哪些区域可用?有什么限制?
已在美国东部(弗吉尼亚州北部、俄亥俄州)、美国西部(俄勒冈州)、亚太地区(孟买、新加坡、悉尼、东京)和欧洲(法兰克福、爱尔兰、斯德哥尔摩)推出。推出时仅支持同一 AWS 账户和区域内以 Parquet 格式存储的 AWS Glue 注册 Hive 表。
