为我的图标库增强VLM元数据
内容提要
作者尝试为图标库加入视觉搜索:先用CLIP、DINOv2、SigLIP2生成图像嵌入做相似图标检索,效果一般;再用VLM(Moondream)生成图标描述和关键词,标签搜索准确但易被通用词稀释。对比后认为CLIP在相似图标搜索上表现更好。目前尚未决定是否落地,主要顾虑是VLM会带来新增依赖和维护成本。
延伸解读
视觉搜索的两种路径:嵌入与标签
文章对比了两种实现图标视觉搜索的方法:一是用CLIP、DINOv2、SigLIP2等模型生成图像嵌入,通过相似度匹配找相关图标;二是用VLM生成描述和关键词,再基于标签重叠搜索。嵌入方法适合“找相似图标”,标签方法适合“按关键词搜索”,但标签易被通用词稀释,导致相关图标匹配效果不佳。
模型选择:CLIP在相似图标搜索中更优
作者测试了CLIP、DINOv2和SigLIP2,发现它们性能相近,没有突破性差异。但在“点击图标找相似图标”的任务中,CLIP的表现明显好于基于标签重叠的方法。这是因为CLIP能捕捉视觉特征,避免被“方形”“蓝色”等通用标签干扰,而标签方法中独特关键词容易被稀释。
落地顾虑:依赖与维护成本
作者尚未决定是否实现该功能,主要顾虑是引入VLM会带来新的依赖和维护成本。每新增一个图标都需要运行VLM生成描述和关键词,这增加了工作流复杂度。作者对图标项目的新增依赖非常谨慎,认为保持简单是长期维护的关键。
潜在低成本方案:利用macOS本地模型
文章提到Apple在macOS 27中通过CLI提供了基础模型(fm命令),如果Mac仍是处理图标元数据的主要机器,使用fm生成描述和关键词可能是一种低成本的替代方案。但这仍需要评估是否值得引入,作者对此持开放但未决的态度。
Q&A
作者为什么想为图标库加入视觉搜索功能?
作者长期希望实现类似“搜索咖啡,显示所有包含咖啡图案的图标”的功能,以及更智能的“相关图标”推荐,例如点击麦克风图标时能显示其他包含麦克风的图标,并且能理解麦克风的广义类型(动圈、电容、铝带等)。
作者尝试了哪些图像嵌入模型来生成图标相似性?效果如何?
作者尝试了CLIP、DINOv2和SigLIP2。CLIP能生成嵌入并用于相似图标检索,但除非图标视觉上非常独特,否则效果一般;DINOv2和SigLIP2效果与CLIP大致相同,各有优劣,没有突破性提升。
使用VLM(如Moondream)为图标生成描述和关键词的方法效果如何?
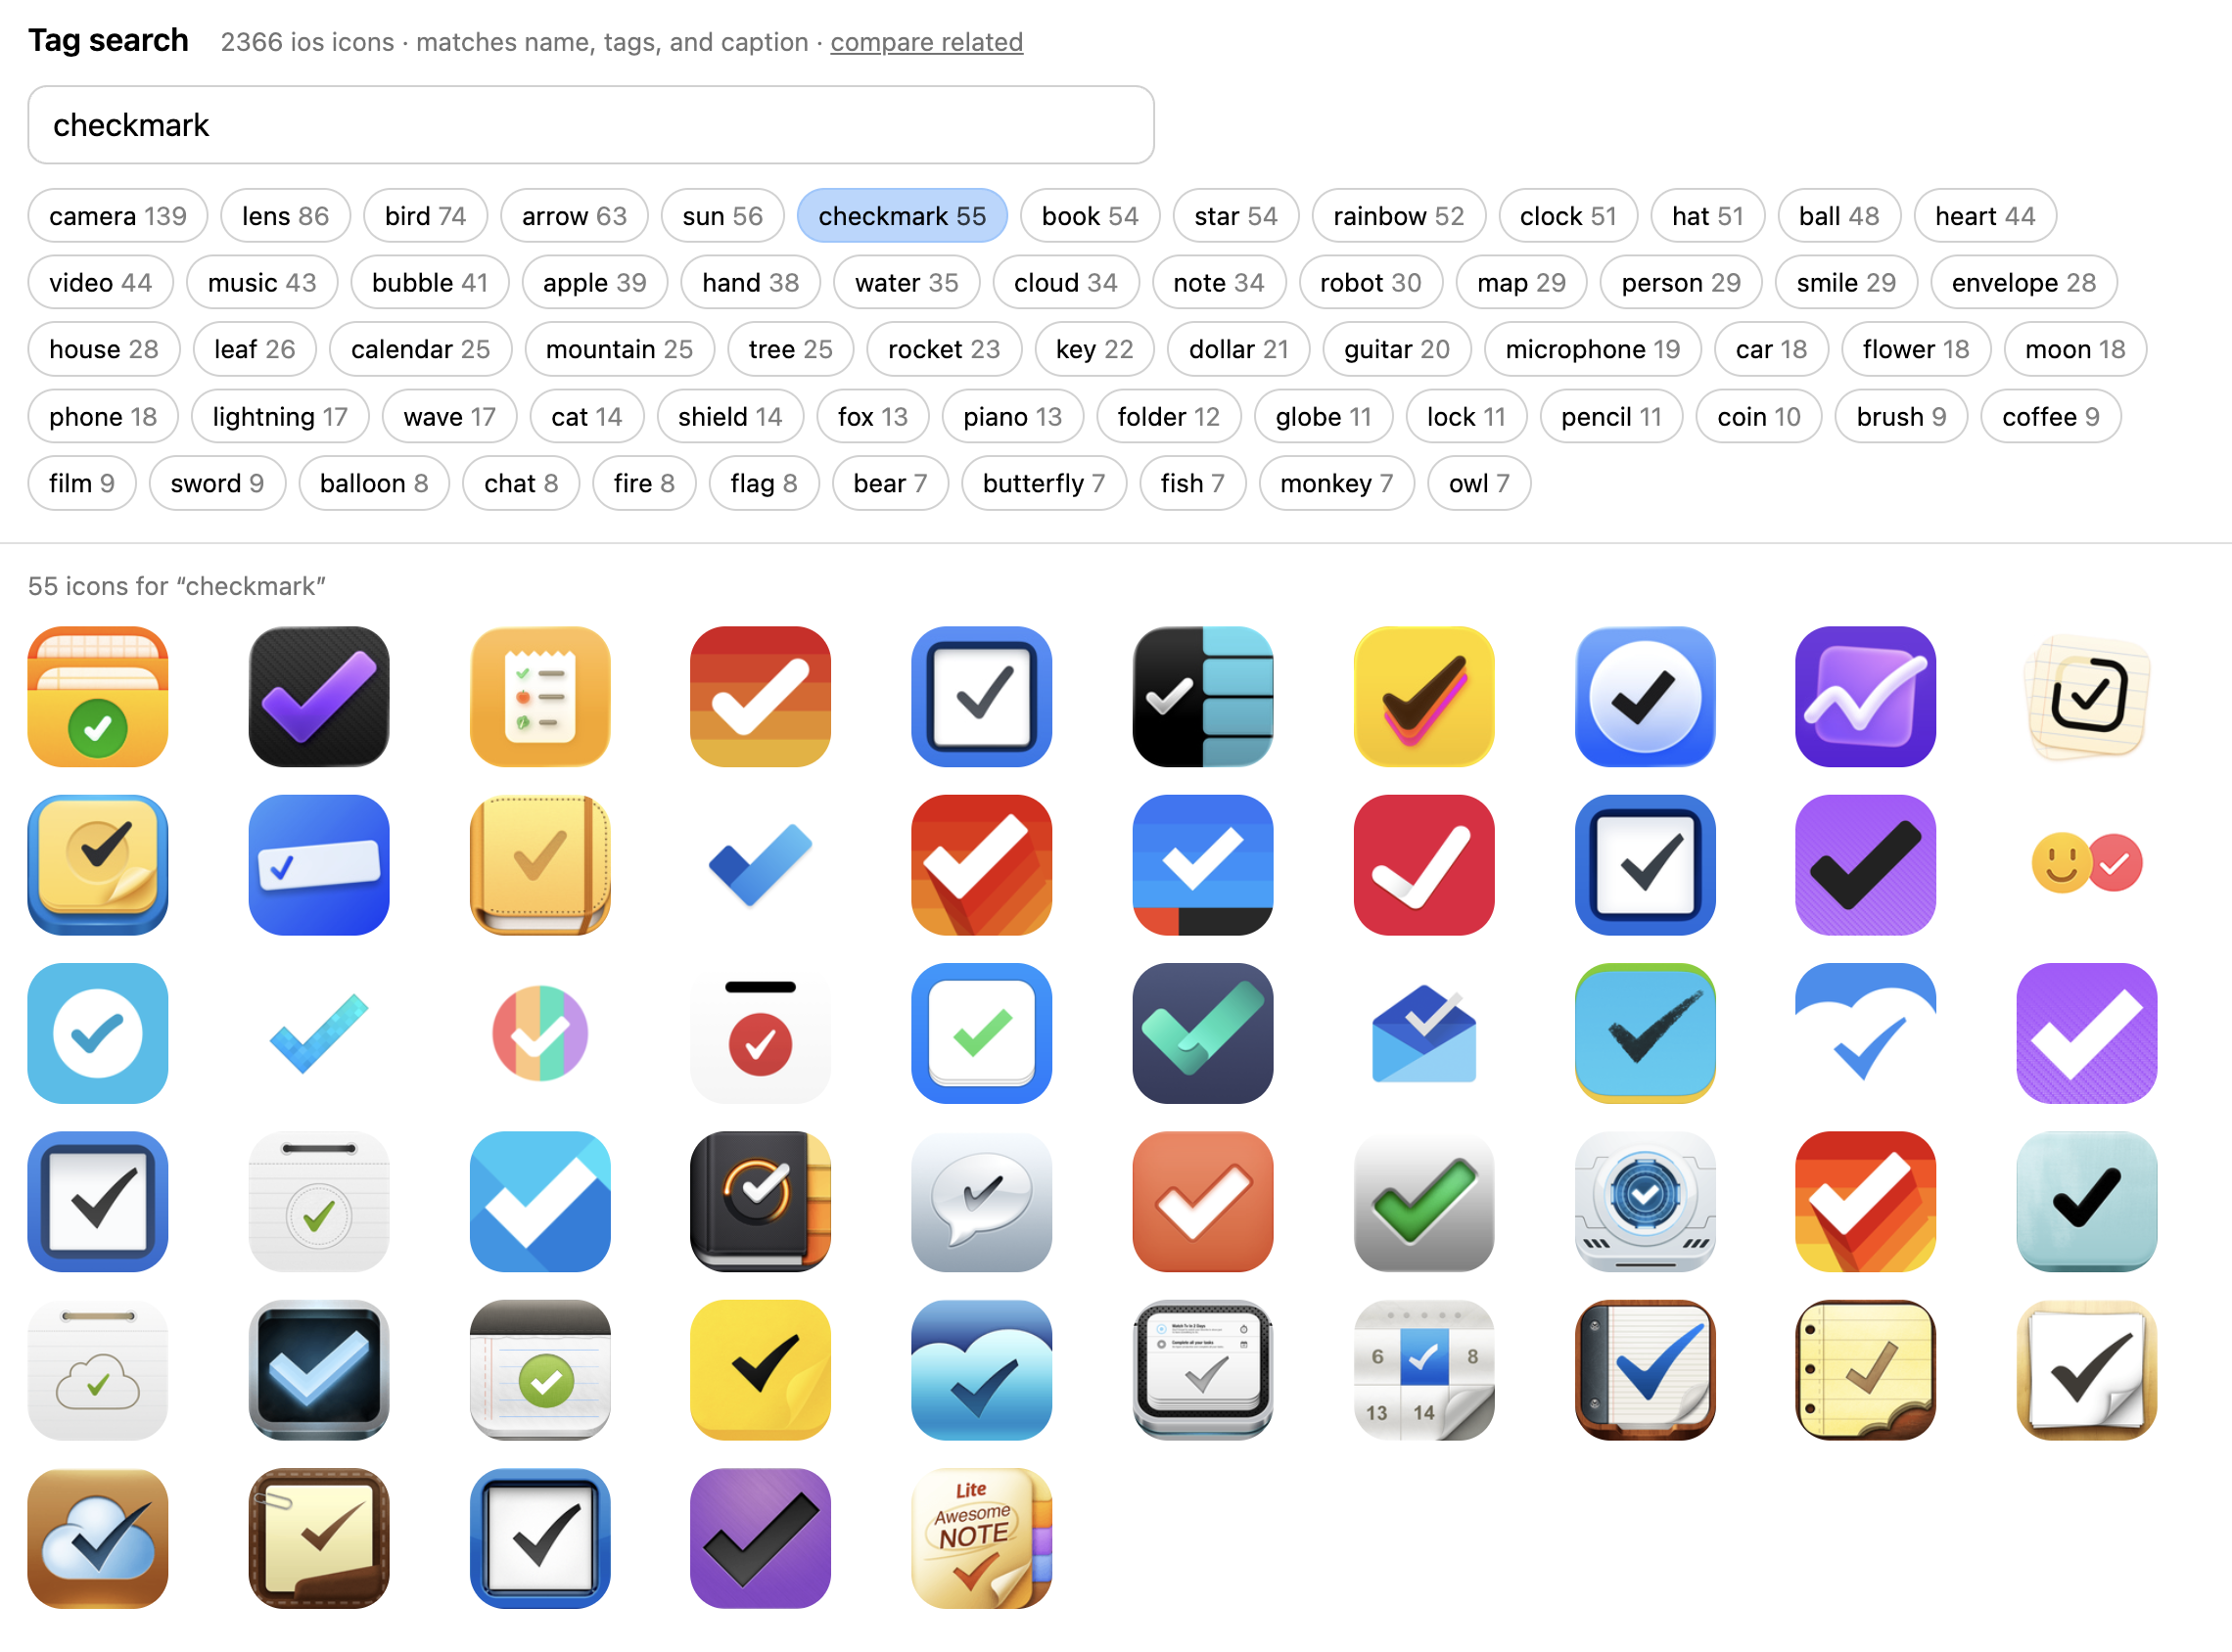
作者用Moondream为每个图标生成描述并提取标签,然后通过标签重叠进行搜索。标签搜索匹配准确,例如点击“checkmark”能显示所有带对勾的图标。但这种方法与CLIP的“相似图标”搜索不同,且标签容易被通用词(如square、blue、simple)稀释。
在“查找相似图标”任务上,CLIP和标签匹配哪种方法更好?为什么?
CLIP表现更好。因为标签匹配中,像“checkmark”这样的独特关键词会被“square”、“blue”、“simple”等通用标签稀释,导致匹配不精准;而CLIP能直接找到视觉上相似的图标,不受通用标签干扰。
作者对于将VLM集成到图标库中有哪些顾虑?
主要顾虑是VLM会成为新增依赖,带来维护成本。每次添加新图标都需要运行VLM生成嵌入或标签,增加了时间和金钱成本。作者对添加新依赖非常谨慎,担心影响项目的长期可维护性。
作者提到macOS 27的本地基础模型可能如何帮助解决依赖问题?
Apple在macOS 27中通过CLI提供了基础模型(如fm命令)。如果作者的Mac仍是主要处理图标元数据的机器,使用fm可以低成本地为每个新图标生成描述和关键词,从而避免依赖外部VLM服务,降低维护成本。
