


Uber如何打造Genie以准确回答问题
内容提要
Uber内部AI助手Genie通过Slack解答工程支持问题,采用RAG而非微调:用Spark ETL管道从Engwiki等来源提取文档,经LangChain分块和OpenAI嵌入模型生成向量,存入内部向量数据库Sia供检索。提问时先检索相关片段,再连同来源URL交给LLM生成带引用的回答以减少幻觉。Genie支持追问、标记解决或转人工,并收集四类反馈存入Hive分析;Uber还用LLM评审评估回答与文档质量。上线一年覆盖154个频道,回答超7万问题,有用率48.9%,节省约1.3万小时。
延伸解读
RAG 与微调的取舍逻辑
Uber 选择 RAG 而非微调,核心原因在于启动速度与维护成本。微调需要高质量、多样化的训练样本和足够算力,且文档更新后需重新训练;RAG 则直接利用现有文档,文档更新即可改善回答,无需重训模型。但文章也指出,RAG 仍需大量工作来收集、准备和评估文档,并非零成本方案。这一取舍适合知识频繁变化、且已有较完善文档体系的场景。
检索与生成分离带来的可诊断性
Genie 将嵌入模型与 LLM 的职责分开:嵌入模型负责检索相关片段,LLM 负责基于片段生成回答。这种分离让故障排查更有针对性——回答不佳时,可以判断是检索到了不合适的片段,还是检索正确但生成有误。文章强调,改进系统需要同时检查这两个阶段,而非笼统归因于模型能力。对构建类似系统的团队而言,这种可观测性设计值得借鉴。
引用来源不等于答案正确
Genie 要求模型基于检索到的子上下文作答,并附上来源 URL,以减少幻觉。但文章明确指出,来源链接并不能保证每句话都正确:检索片段必须相关、底层文档必须准确、模型必须忠实呈现。因此 Uber 仍保留评估环节,用 LLM 评审检查答案是否有上下文支持,并单独评估文档质量。这提醒读者,引用机制是降低风险的手段,而非正确性的充分证明。
反馈分类与人工兜底的价值
Genie 将用户反馈分为已解决、有帮助、无帮助、不相关四类,区分了部分帮助与完全解决、错误回答与超出文档助手能力范围的请求。这种细分让指标更能反映真实效果。同时,当 Genie 无法回答时,会引导用户联系值班工程师,转人工后 Genie 保持静默。文章认为,成功的支持不仅是生成一段文字,还要让用户清楚下一步该做什么,部分帮助若能顺畅衔接人工,仍有价值。
Q&A
Uber的Genie是什么?它主要解决什么问题?
Genie是Uber内部的AI助手,用于回答工程支持问题。它通过Slack频道工作,从Uber的文档中查找相关信息,并用语言模型解释,帮助工程师快速获得答案,减少平台团队on-call工程师的重复性支持负担。
Genie为什么选择RAG而不是微调?
Uber选择RAG是因为它可以直接利用现有文档,无需先构建高质量的微调数据集,能更快上线;同时,更新外部知识库即可改进Genie的信息,而无需为每次文档变更重新训练模型。
Genie如何准备和检索知识?
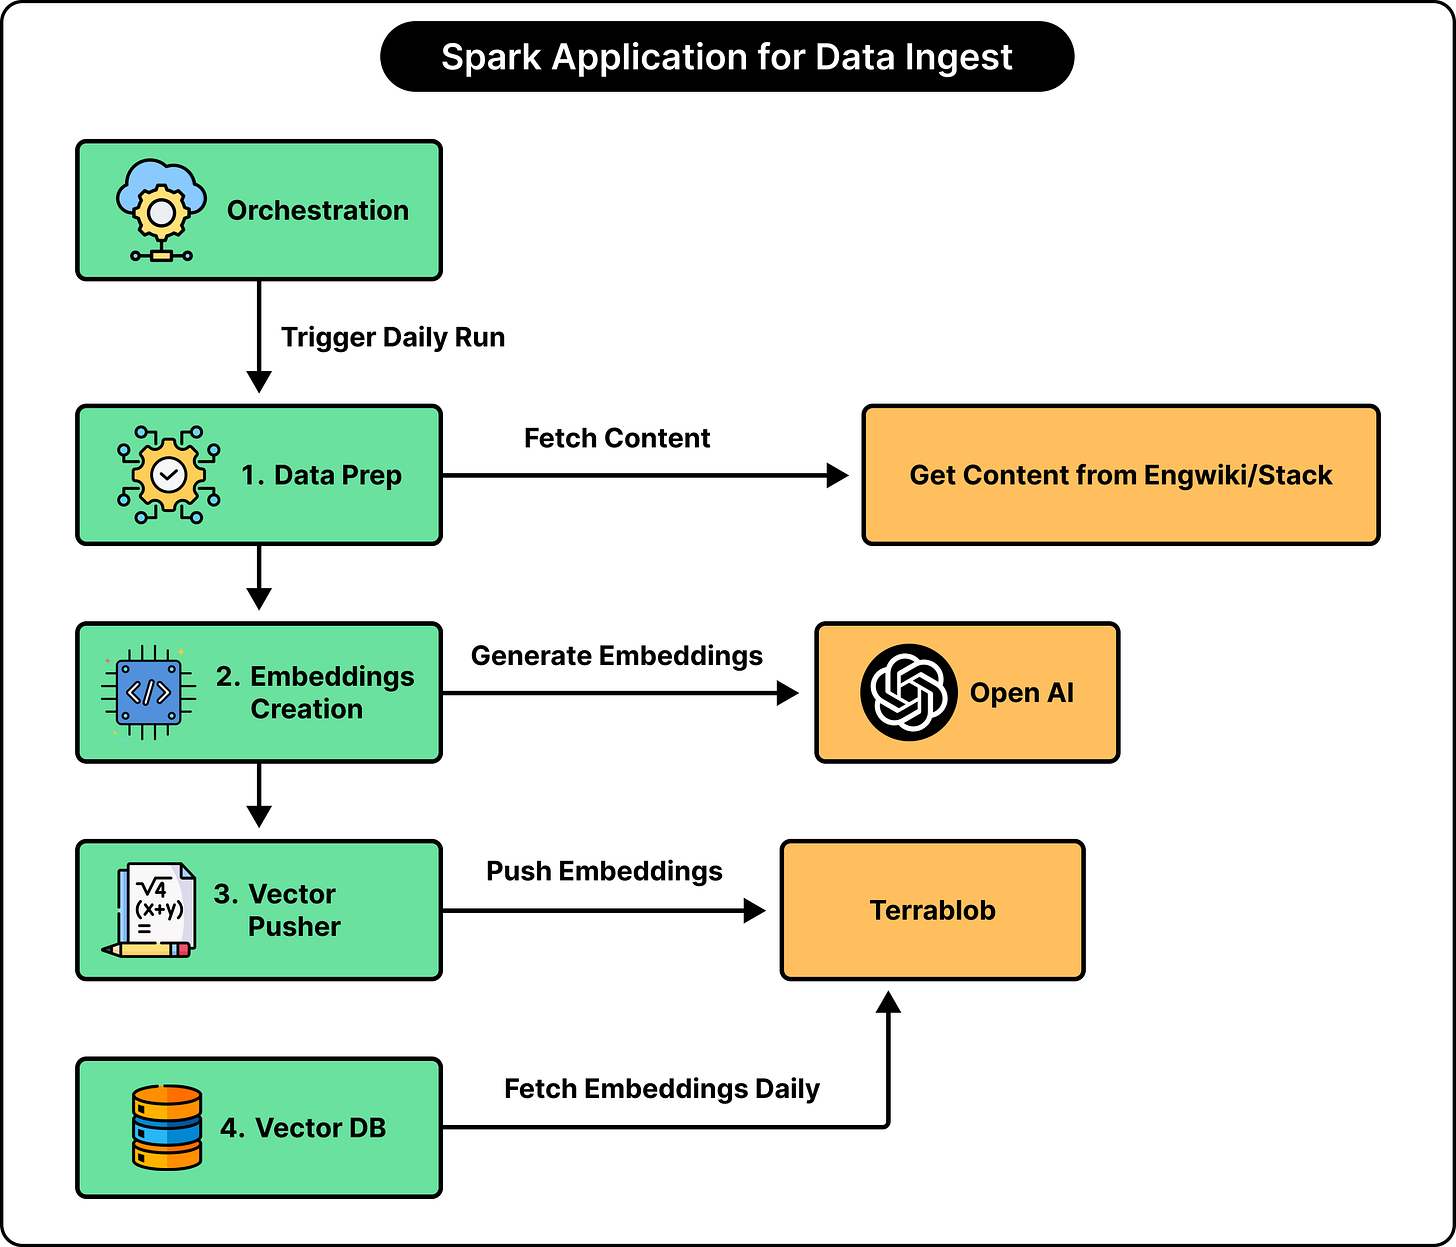
Genie使用Spark ETL管道从Engwiki和内部Stack Overflow等来源提取文档,用LangChain分块,并用OpenAI嵌入模型生成向量,存入Uber的向量数据库Sia。提问时,将问题转为嵌入,在Sia中检索相关片段,连同来源URL交给LLM生成回答。
Genie如何减少幻觉并确保回答有依据?
Genie将每个检索结果作为单独子上下文并附上来源URL,指示模型基于这些子上下文回答并提供引用。这给了模型明确的证据,也让用户能核查来源。此外,Uber还限制知识来源,只选择适合通过模型和Slack暴露的文档。
如果Genie无法回答或用户需要进一步帮助,会怎样?
Genie的回复包含操作按钮,用户可追问、标记已解决或联系人工支持。如果信息不足,Genie会告知用户并引导至负责该平台的on-call开发者。转人工后,人类开发者接管,Genie保持静默,以保持对话聚焦。
Genie如何收集反馈和评估性能?
用户在Slack中选择反馈类别(已解决、有帮助、无帮助、不相关),反馈通过Kafka流入Hive表并展示在仪表盘。Uber还用“LLM作为评审”评估回答的幻觉和相关性,并评估源文档质量,结果发布在报告中以指导改进。
Genie上线后的效果如何?
Genie于2023年9月上线,一年内覆盖154个Slack频道,回答超过7万个问题,有用率48.9%,节省约1.3万小时工程时间。
