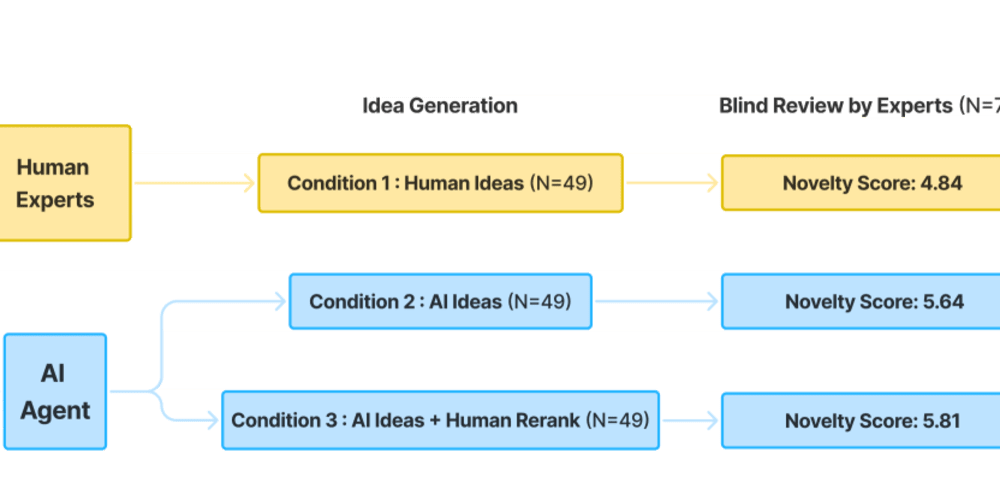
这项研究探讨了大型语言模型(LLMs)是否能够产生新颖且有用的研究想法,并发现LLM生成的想法被评为新颖和有用,证明了它们对研究构思过程的帮助。这项研究为先进的人工智能系统增强人类创造力提供了证据,对科学进步和创新具有重要意义。
FutureHouse Inc.发布了LAB-Bench生物学基准数据集,用于评估人工智能系统在各种生物研究任务中的性能。数据集包括2400多个多项选择题,涵盖文献检索、图表解释、表格解释、数据库访问、协议编写以及DNA和蛋白质序列的理解和处理等主题。研究人员评估了不同模型在文献回忆、补充材料信息检索以及表格和协议数据解释等任务中的表现。结果显示,虽然模型在某些任务中表现良好,但在需要DNA和蛋白质序列处理的任务中表现较差。总体而言,人类在实际研究任务中的表现仍然优于模型。
推特因用户数据被用于训练人工智能系统面临欧洲监管机构质询。Chrome要求输入ZIP归档密码以检测恶意文件。IDC预测2023年中国托管安全服务市场规模为46.1亿元。黑客窃取并公开了CrowdStrike的IoC数据。发布了人脸识别产业法律治理研究报告。
未来的人工智能系统将具备更强的自适应学习能力,并能在物理世界中执行任务和作出反应。AI伦理问题将受到挑战,需要建立人工智能治理框架和监管技术。软件开发者角色可能会演变,开发者将更多地承担监督和管理的职能。软件开发行业可能会民主化,更多没有传统技能的人也可以参与软件开发。
苹果推出了人工智能系统ReALM,能够理解屏幕上的任务、会话上下文和后台进程,通过将屏幕信息转换为文本实现更高效的人工智能。研究人员表示,ReALM的性能优于GPT-4。该系统使得语音助手更具情境感知能力,提供更无缝和免提的用户体验。
拜登敦促国会通过移民法案,包括购买高科技毒品检测机器以增加对芬太尼走私的能力。海关和边境保护局希望通过人工智能系统实现对车辆的快速扫描和处理。目标是到2025年底扫描40%的乘用车和70%的商用卡车。
大型语言模型正被探索应用于循证医学、科学教育、药物发现和材料设计等科研领域,以处理复杂问题并整合知识。研究还涉及其在数据科学模型选择、教学设计、数据驱动写作及差分隐私联邦学习中的应用,强调平衡人机协作、保证质量与伦理,推动透明高效的人工智能系统发展。
美国专利商标局(USPTO)发布了最新指南,指出人工智能系统不能被命名为发明人,但人类可以在创造专利发明的过程中使用AI工具,并且必须披露使用了AI。使用AI的人必须对发明做出重大贡献才能注册专利。USPTO裁定只有“自然人”可以申请专利。
最近的科技新闻包括:1、研究人员开发了一种能将脑电波翻译成文本的人工智能系统。2、微软推出了新的应用程序,允许用户随时访问免费的AI工具。3、三星即将推出的Galaxy S24手机将具备人工智能功能。4、Flowpilot允许使用智能手机设置汽车自动驾驶。5、研究发现,法学硕士在被提示为性别中立或男性时表现更好。6、OpenAI去年收入大幅增长。7、FDA批准了一种基于CRISPR的基因疗法,标志着治疗遗传疾病的新时代。
加州大学伯克利分校的研究人员发现,人工智能系统缺乏创新能力。他们通过实验发现,儿童和成人能够以新方式看待工具并解决问题,而人工智能系统往往无法做到。研究人员建议从儿童的学习方法中汲取灵感,设计出更具创新能力的人工智能系统。
当代人工智能系统需要资源、数据集和计算基础设施,知识的表示通过不同模态呈现,包括动力学和奖励模型、价值函数、策略和原始数据。该论文讨论了这些模态,以实现知识的迁移和推广,并分析了转移出现或稀缺的原因,并强调了从设计到学习的转移的重要性。
本文讨论了人工智能系统的增长对Python开发人员的未来产生的疑问,以及学习Python编程和实践计算思维的好处。还介绍了一些与Python开发者相关的项目和教程。
该论文介绍了一种名为“元提示”的新技术,它在大型语言模型、多模态基础模型和人工智能系统中具有广泛的应用。该技术基于类型理论和范畴论,注重信息的结构和语法,提供了一种超越传统方法的框架。论文详细阐述了“元提示”的定义,并展示了它在不同人工智能应用中的优势。此外,论文还将“元提示”扩展到复杂推理领域,并将其推广到多模态基础模型设置中。这一技术的推广解决了整合不同数据类型的挑战,展示了处理复杂多方面数据的潜力。
SALMON是一种新方法,使用少量人定的原则和基于合成偏好数据训练的奖励模型,实现了对基础语言模型的自动对齐,提高了监督效率、可控性和可扩展性。在各种基准数据集上显著超越了几种最先进的人工智能系统,包括LLaMA-2-Chat-70b。
该研究提出了一种名为SALMON的新方法,使用少量人定的原则和基于合成偏好数据训练的奖励模型,实现了对基础语言模型的自动对齐,提高了监督效率、可控性和可扩展性。在各种基准数据集上显著超越了几种最先进的人工智能系统,包括LLaMA-2-Chat-70b。
该研究使用有监督学习方法,识别出特定领域的模型特征子集,并解释保留特征的语义。研究发现人类如何根据性别包容性和国际性来区分运动类别,以及不同领域中特征对不同语义维度的预测能力。该研究讨论了人工智能系统与人类知识之间的对齐意义。
为了提高人工智能系统的可信度,研究者提出了一种新的训练策略,通过结合熵鼓励损失项和对抗校准损失项,提高样本在领域世界偏移下的校准性和适应性。该方法在不同的数据模式、数据集和网络架构上表现明显优于现有方法,具有技术上的可信度。
介绍了一种受到哲学和精神分析概念启发的人工智能系统,利用想象力将文本输入与其他模态进行连接,从先前学习的经验中丰富所得信息。该系统具备独立感知输入的能力,导致概念的独特解释,被称为“可解释性误解”。通过使用大规模模型评估了系统在情感识别和问答等任务上的表现,采用零样本方法以确保无偏执的情况。该系统在多个数据集上优于最佳大型语言模型,为人工智能跨模态生成深度且可解释的信息,增强人机交互提供了新的可能性。
人工智能系统发布速度加快,但缺乏用户文档,只有Twitter影响者线程。作者提供了人工智能入门指南,介绍了不同AI系统及其用途。ChatGPT 4.0和Bing适用于写作,Bing和Midjourney适用于图像生成,Code Interpreter和Claude 2适用于数据处理,Bing和Khanmigo适用于教育。作者提到了人工智能的担忧,如幻觉和道德问题。强调人工智能是工具,需谨慎使用,注意道德问题。
完成下面两步后,将自动完成登录并继续当前操作。