小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
如何在不显著降低智能水平的前提下缩小语言模型

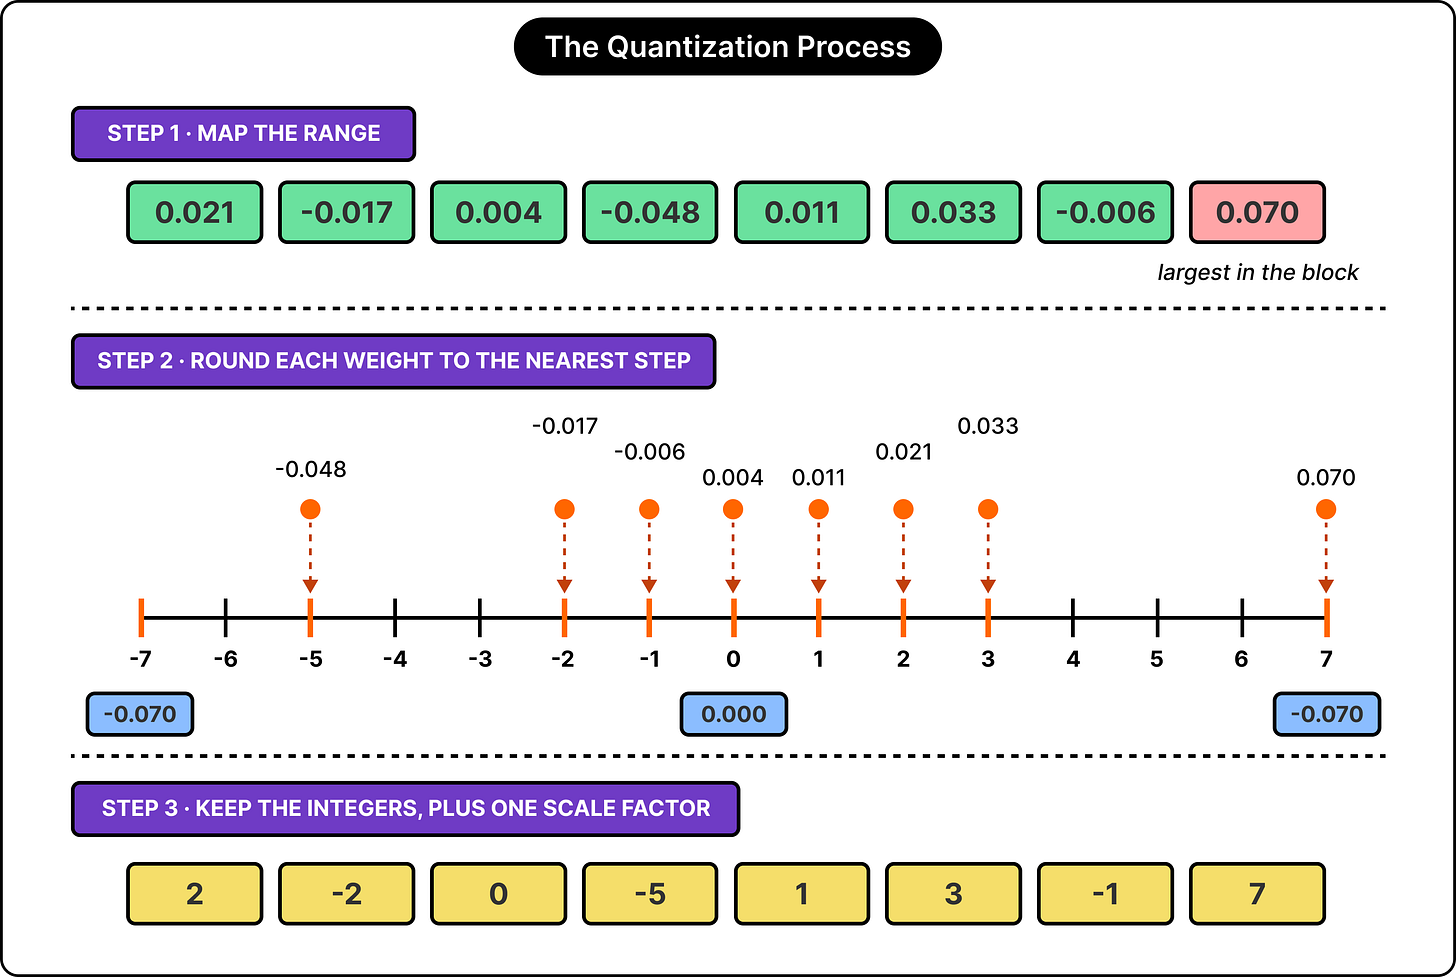
本文介绍了三种压缩大型语言模型的技术:量化、剪枝和知识蒸馏,它们能在不显著降低智能水平的前提下减小模型规模。这些技术可叠加使用,但各有取舍,如量化可能损失细微理解力,剪枝影响复杂逻辑,蒸馏可能缺乏原创性。选择哪种技术取决于模型的具体应用目标。

如何在不显著降低智能水平的前提下缩小语言模型

ByteByteGo Newsletter ByteByteGo Newsletter · 2026-09-01T15:30:41Z

本文介绍量化和剪枝两种模型压缩技术,用于减小大语言模型体积、降低成本并提升推理速度。量化降低权重精度(如4位),剪枝删除冗余权重。文中详述五种方法:bitsandbytes、GPTQ、AWQ、SparseGPT和Wanda,并建议先剪枝后量化,根据需求选择合适方法,以在保持性能的同时实现高效部署。

量化和剪枝方法,让你的大语言模型更精简

KDnuggets KDnuggets · 2026-08-28T12:00:55Z
IDEA剪枝:生成式语言模型预训练中的集成式扩大-剪枝流水线

本文提出一种集成式“扩大-剪枝”流水线,用于生成式语言模型预训练。该方法将扩大模型训练、剪枝和恢复整合到单一余弦退火学习率计划中,并引入迭代结构化剪枝,以缓解知识损失并优化神经元容量分配。实验表明,在将2.8B模型压缩至1.3B(预训练达2T tokens)时,该方法提升了剪枝模型的性能,并揭示了扩大预训练的token效率优势。

IDEA剪枝:生成式语言模型预训练中的集成式扩大-剪枝流水线

Apple Machine Learning Research Apple Machine Learning Research · 2026-08-26T00:00:00Z
紫东太初推出GMC核心集剪枝方法,少80%Token仍满血保真多模态能力

中科院团队提出GMC核心集剪枝方法,解决视觉语言模型Token冗余问题。该方法免训练,通过互补证据筛选和群体信息传输,保留关键视觉信息,减少80%以上Token,性能保持99%以上,并抑制幻觉,兼容Qwen、LLaVA等模型,提升推理速度,降低显存占用。

紫东太初推出GMC核心集剪枝方法,少80%Token仍满血保真多模态能力

量子位 量子位 · 2026-08-12T10:54:29Z

本文探讨大语言模型压缩的三种主要方法:量化、蒸馏和剪枝,它们分别作用于数值精度、训练目标和模型结构,因此不可直接比较。文章分析了GPTQ、AWQ、SmoothQuant等方法的假设差异,指出PPL指标在评估压缩效果时不可靠,且压缩可能损害推理能力、长上下文处理及安全行为,需根据具体应用场景谨慎选择压缩方法。

【Transformer 与注意力机制】51|量化、蒸馏、剪枝:压缩改变的是三种不同的东西

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-08-06T00:00:00Z
MacStudio跑KimiK3:剪枝干掉73%专家 瘦身到350GB

该文章介绍PipeNetwork的kimi-k3-mlx项目,将Moonshot AI的2.8T参数MoE模型Kimi K3转换为苹果芯片MLX格式,通过流式转换和REAP剪枝技术删除73%专家,将模型从1.6TB压缩至350GB,使Mac Studio等大内存设备能本地运行,展示了巨型模型个人化的工程路径。

MacStudio跑KimiK3:剪枝干掉73%专家 瘦身到350GB

极道 极道 · 2026-07-30T03:48:00Z
Kimi K3本地使用版(1.56TB → 594GB),由Unsloth压缩并发布

Unsloth团队将Kimi K3模型从1.56TB压缩至594GB,体积缩小近三倍,最小版本保留78.9%准确率。量化技术降低参数存储位数,使顶级模型可在个人电脑运行。文章还讨论剪枝技术、显存焦虑及低成本部署梦想,推动压缩技术发展,让AI从奢侈品变为消费品。

Kimi K3本地使用版(1.56TB → 594GB),由Unsloth压缩并发布

极道 极道 · 2026-07-29T23:21:00Z
Fortress:通过时间数据增强和特征剪枝稳定搜索推荐的案例研究

文章介绍了Fortress框架,该框架通过识别和去除导致预测不稳定的特征,提升搜索推荐系统的稳定性和准确性。利用历史快照数据,经过四个步骤处理不稳定预测,最终在大型应用市场的模型中验证了其有效性,显著提高了预测稳定性和分类性能。

Fortress:通过时间数据增强和特征剪枝稳定搜索推荐的案例研究

Apple Machine Learning Research Apple Machine Learning Research · 2026-07-06T00:00:00Z

KD-tree是一种用于多维空间搜索的数据结构,能够有效解决最近邻查询和范围查询问题。其构建时间为O(n log n),查询时间为O(log n),但在高维情况下性能会迅速下降,出现“维度灾难”。本文分析了KD-tree的构建和查询算法及其局限性,并与Ball tree等其他结构进行了比较,指出KD-tree在低维场景下表现优异,适用于点云处理和游戏碰撞检测等应用。

KD-tree:切分规则、回溯剪枝与维度增长下的失效边界

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-05-28T00:00:00Z
大模型剪枝新范式:先浓缩,再剪枝——DenoiseRotator技术解读

DenoiseRotator是一种新型的大模型剪枝技术,通过“重要性浓缩”优化参数分布,增强剪枝的鲁棒性并减少性能损失。该方法与现有剪枝算法兼容,已在NeurIPS会议上发表,适用于大规模语言模型的高效压缩。

大模型剪枝新范式:先浓缩,再剪枝——DenoiseRotator技术解读

美团技术团队 美团技术团队 · 2025-12-19T00:00:00Z

机器之心数据服务已上线,提供高效稳定的数据获取服务,帮助用户轻松获取所需数据。

加速近5倍!北大与字节团队提出BranchGRPO,用「树形分叉 + 剪枝」重塑扩散模型对齐

机器之心 机器之心 · 2025-09-22T07:45:56Z
指令跟随剪枝用于大型语言模型

随着大型语言模型的发展,本文提出了一种动态剪枝方法——指令跟随剪枝,能够根据用户指令动态选择模型参数。该方法通过优化稀疏掩码预测器和LLM,显著提升了推理效率和性能,实验结果在多个评估基准上表现优异。

指令跟随剪枝用于大型语言模型

Apple Machine Learning Research Apple Machine Learning Research · 2025-06-30T00:00:00Z
如何优化语言模型大小以便部署

本文探讨了优化语言模型大小的策略,包括模型蒸馏、剪枝、层减少和模块化适应。蒸馏通过教师-学生模型训练小型模型,剪枝移除贡献最小的权重,层减少通过减少网络层数提高效率,模块化方法如LoRA简化模型适应。此外,权重级优化技术如量化和权重共享也被提及,以提高推理速度和减少内存占用。

如何优化语言模型大小以便部署

MachineLearningMastery.com MachineLearningMastery.com · 2025-06-09T16:40:47Z

本研究解决了智能交通场景中车辆具身智能网络(VEANs)中智能体迁移存在的计算延迟和资源限制问题。提出了一种Tiny Multi-Agent Bidirectional LSTM Proximal Policy...

基于双向长短期记忆网络的多智能体深度强化学习及计算感知剪枝用于车辆具身智能网络中的智能体双胞胎迁移

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-09T00:00:00Z

本研究探讨了自编码器的神经网络剪枝,提出了一种基于激活的变异算子来指导权重剪枝。结果表明,该方法在效率上优于随机剪枝,尤其在低维环境中更为有效,提升了自编码器的性能和可扩展性。

Activation-Based Pruning Operator Guiding Evolutionary Autoencoder Training

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-08T00:00:00Z

本研究提出了一种新的结构化剪枝框架SPAP,旨在优化大型语言模型的计算和内存需求。SPAP通过混合整数优化和交替最小化算法,解决了性能下降和微调成本高的问题,实验证明其在推理速度和内存效率上优于现有方法。

SPAP:通过交替优化和惩罚方法进行结构化剪枝

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-06T00:00:00Z

回溯算法是一种搜索方法,通过深度优先遍历树形结构来寻找复杂问题的解,如全排列。其过程包括选择、递归和撤销选择,时间复杂度通常为O(N!),适合暴力穷举,优化时需注意剪枝。

算法模式:回溯

"地瓜哥"博客网 "地瓜哥"博客网 · 2025-04-09T09:30:51Z

本文提出了一种自适应计算剪枝方法(ACP),有效解决遗忘变换器中注意力头快速遗忘的问题。研究表明,ACP可减少约70%的计算量,提高训练吞吐量10%至35%,在长上下文中效果更为显著,且性能保持稳定。

遗忘变换器的自适应计算剪枝

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-09T00:00:00Z
Faster than GRPO by 8 Times on GSM8K! Xiamen University Proposes CPPO, Making Reinforcement Learning Lightning Fast

厦门大学研究团队提出新算法CPPO(完成剪枝策略优化),旨在加速GRPO(组相对策略优化)训练。CPPO通过剪枝低优势的完成结果,减少计算量,提高训练效率。实验表明,CPPO在保持准确度的同时,训练速度比GRPO快8.32倍,具有良好的稳定性和收敛性,适合大规模推理模型训练。

Faster than GRPO by 8 Times on GSM8K! Xiamen University Proposes CPPO, Making Reinforcement Learning Lightning Fast

机器之心 机器之心 · 2025-04-01T03:54:55Z

本文探讨了通过剪枝注意力头来减轻大型语言模型的偏差问题,提出了一种随机模拟退火的方法,有效识别需剪除的偏差贡献大的注意力头,实验表明可减少多达40%的性别偏差。

Attention Pruning: Automatically Mitigating Fairness in Language Models through Proxy Simulated Annealing

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-20T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码