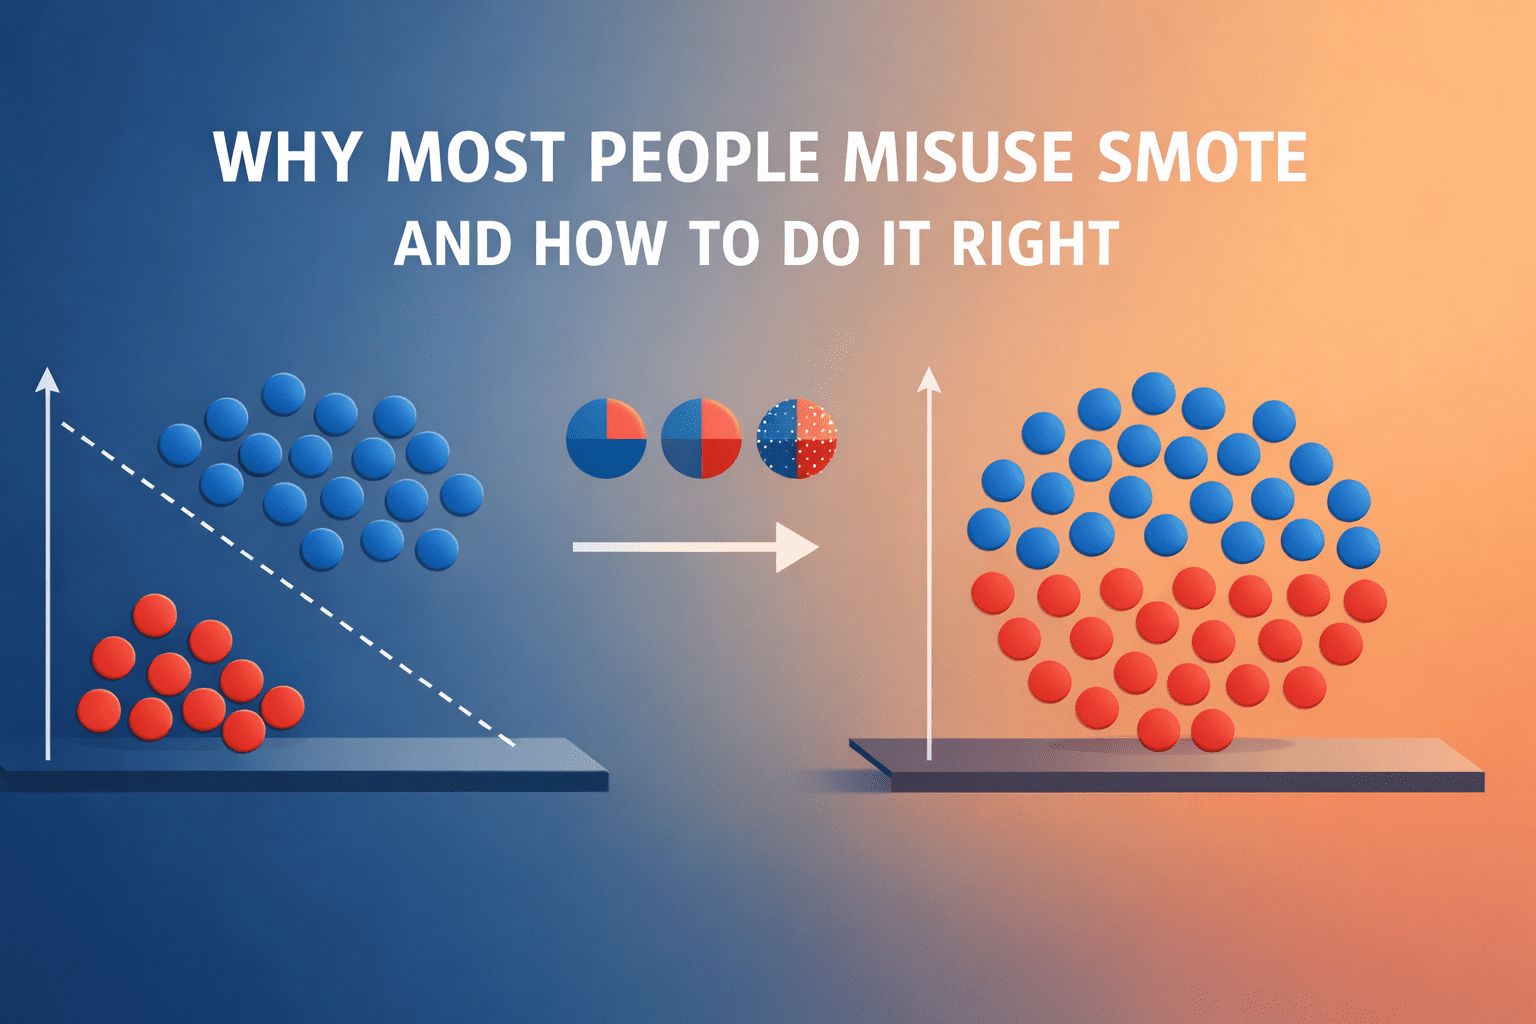




SMOTE是一种解决机器学习类别不平衡问题的数据增强技术,通过在少数类样本间插值生成合成样本,帮助平衡数据集。使用时需先划分训练和测试集,以防数据泄漏。常见误用包括过度平衡和忽视评估指标的上下文。
本文介绍了可控图像-文本合成管道CtrlSynth,旨在提升多模态学习的数据效率和鲁棒性。通过将图像的视觉语义分解为基本元素,用户可自定义合成策略。CtrlSynth利用预训练模型生成自然多样的合成样本,显著提升了CLIP模型在零-shot分类、图像-文本检索和组合推理等任务中的表现。
该研究提出了SMOGAN框架,旨在解决不平衡回归中预测变量偏斜的问题,显著提升了合成样本的质量和模型性能,实验结果表明其优于传统方法。
本研究提出了一种自编排的数据增强方法,通过合并相似文档生成合成样本,解决了关键短语生成模型训练数据不足的问题,有效提升了生成效果。
本研究探讨流匹配模型在样本数据子空间中合成样本的能力,提出的正交子空间分解网络(OSDNet)有效分解速度场,确保生成样本在保持接近性和多样性的同时,准确代表样本数据子空间。
在机器学习中,处理不平衡数据集是一个常见挑战。SMOTE(合成少数类过采样技术)通过生成少数类的合成样本来平衡数据集,从而避免模型偏向多数类。使用SMOTE可以提高模型的准确性,特别是在少数类样本稀缺的情况下。本文通过Python示例展示了如何应用SMOTE。
SSD-KD是一种小规模无数据知识蒸馏方法,通过平衡合成样本的类别分布和难度来提高整体训练效率。实验证明,SSD-KD在极小规模的合成样本条件下,比许多主流方法快一个或两个数量级,同时保持卓越或竞争性的模型性能。
本文介绍了一种通过生成合成样本来训练深度神经网络的数据集精简方法,显著提高了计算效率和性能。研究提出了对比信号、特征匹配和概率图模型等技术,有效减少数据集大小,同时保持高性能,适用于大规模数据集和连续学习任务。
本研究提出了一种数据驱动的学习模型,用于合成按键生物特征数据,并与两种统计方法进行比较。实验结果表明,这些合成样本可以被高精度地检测出来,但在少样本学习的情况下是一个重要的挑战。
完成下面两步后,将自动完成登录并继续当前操作。