本文探讨了通过自我发明谓词和赋分策略来改善逻辑代理的可解释性和奖励学习效率。提出的基于能量的框架和反事实推理方法在机器人操作任务中表现优异,显著提升了样本效率和决策解释能力。
本文介绍了一种基于强化学习的库存管理系统,旨在优化供应链的计算需求和奖励框架。通过GPU并行化和状态动态规划,该系统实现了新的控制策略,并探讨了未来的研究方向,包括离线奖励学习、知识图谱在推荐系统中的应用,以及逆强化学习的算法改进,以提升样本效率和决策支持。
本文提出了一种基于策略的奖励学习(RLP)无监督框架,旨在通过策略样本优化奖励模型,以提升模型对齐人类偏好和价值的性能。研究还介绍了逆强化学习的监督微调方法、RRHF新范式、主动学习的RLHF方法及线性对齐算法,均在不同场景下显示出显著的性能提升。实验结果表明,这些新方法在训练稳定性和模型质量上优于传统算法。
该文综述部分可观测强化学习研究,涵盖从人类反馈学习奖励函数、Q-learning与IoAlergia结合方法、人类模型的个性化与动态需求、过拟合权衡,以及基于信念的奖励、机器人控制改进、元推理教学、逆强化学习和生理计算人机协作,实验验证了自适应任务分配的有效性。
本文综述基于偏好的强化学习(PbRL)的多项进展:提出数据驱动奖励初始化以降低性能波动;利用状态增强和二元反馈改进奖励学习;实现零样本跨任务偏好迁移;构建B-Pref基准;DIP-RL借助人类示范引导Minecraft任务;RP1将基于模型的强化学习视为主动学习;OPPO无需奖励函数建模离线偏好;PRIOR利用先验约束减少反馈;行动剪辑提升离线学习效率;并探讨多代理人机协作中PbRL的应用空白。
该文综述强化学习在自然语言处理中的应用:利用神经编码器-解码器结合强化学习纠正语法错误,效果优于最大似然估计;ELLM借助大语言模型预训练引导智能体探索;SIRLC采用学生-教师评分策略无监督提升大语言模型表现;奖励学习用于文本生成与摘要;结合情感约束生成会话回复;动态黑盒引导微调语言模型;过程监督奖励优化推理;Fine-Grained RLHF细化长文本反馈;策略梯度微调减少重复;并指出强化学习在机器翻译中贡献有限。
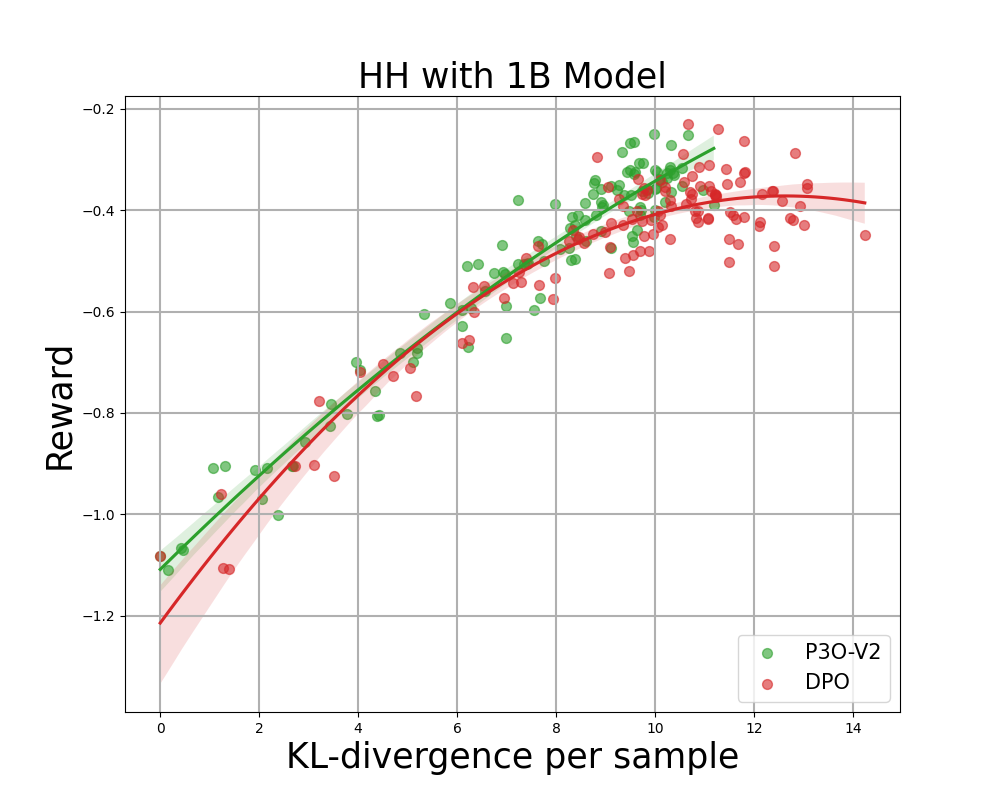
本文探讨了强化学习与人类反馈(RLHF)中奖励学习与强化学习微调之间的矛盾,提出了一种新方法——成对近端策略优化(P3O)。P3O通过比较反馈统一奖励建模和微调过程,在生成任务中表现优于传统方法,更好地与人类偏好对齐,提升生成质量。
该文介绍了一种新的奖励学习模块,可以通过生成模型生成内在奖励信号,提高模块在环境中的动力学建模能力,并为模仿代理提供了模仿者的内在意图和更好的探索能力。该模型在多个 Atari 游戏中的表现优于现有的 IRL 方法,即使只有一次演示,性能也是演示的 5 倍。
完成下面两步后,将自动完成登录并继续当前操作。