


重新思考PPO在强化学习与人类反馈中的角色
内容提要
本文探讨了强化学习与人类反馈(RLHF)中奖励学习与强化学习微调之间的矛盾,提出了一种新方法——成对近端策略优化(P3O)。P3O通过比较反馈统一奖励建模和微调过程,在生成任务中表现优于传统方法,更好地与人类偏好对齐,提升生成质量。
延伸解读
奖励平移问题:RLHF中的隐藏陷阱
文章指出,RLHF中奖励模型使用比较数据训练,但RL微调阶段却优化单一非比较奖励,导致奖励函数不唯一。例如,对奖励函数加上一个与提示相关的常数δ(x),不会改变任何响应对的损失,但会显著影响RL优化结果。极端情况下,策略可能被奖励尺度误导,增加高奖励但无意义响应的概率,而忽略真正有用的相对偏好信息。P3O通过成对策略梯度利用奖励差异,避免了这一问题。
P3O的评估优势:KL-奖励边界与GPT-4胜率
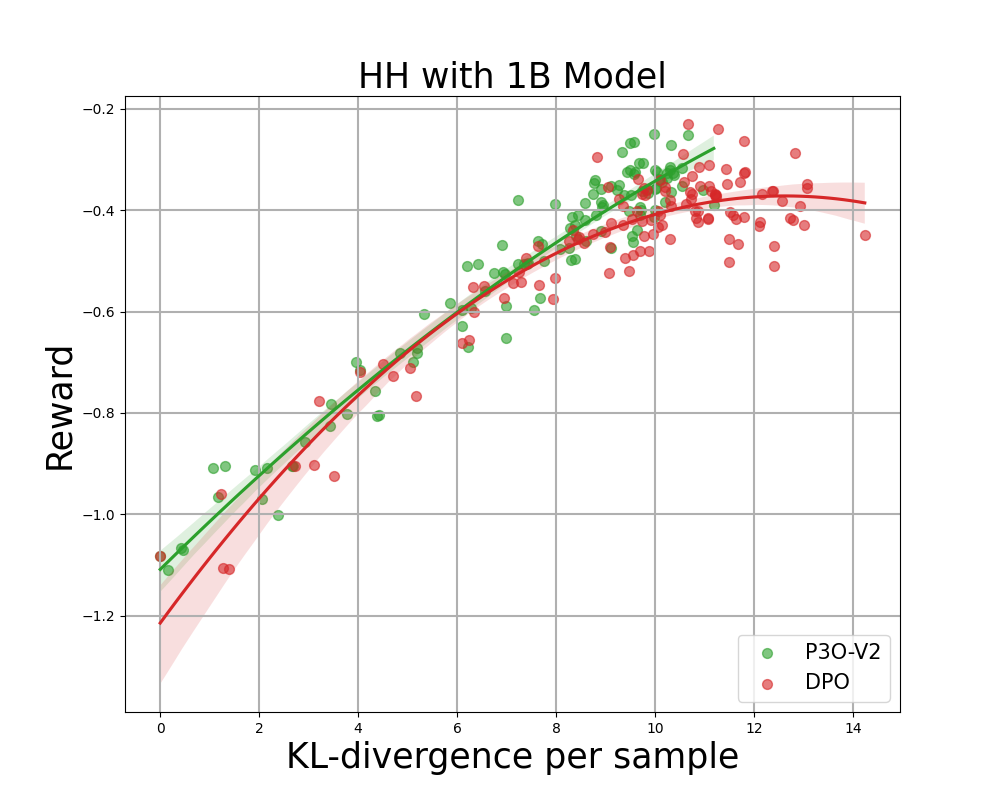
在摘要和问答任务中,P3O在KL-奖励边界上严格优于PPO和DPO,意味着在相同KL散度下能获得更高奖励,或在相同奖励下偏离参考策略更小。GPT-4胜率显示,P3O对PPO胜率57.0%,对SFT胜率69.3%。虽然DPO在奖励上略高于P3O,但其KL散度更大,可能导致生成质量下降,因此GPT-4胜率仅为45.4%。这表明P3O在人类偏好对齐上更均衡。
P3O的实现细节:重要性采样与裁剪
P3O在成对策略梯度基础上,引入重放缓冲区进行重要性采样,并采用裁剪技术避免过大梯度更新。重要性采样从旧策略生成的响应中采样,计算每对响应的权重;裁剪则对重要性采样比和梯度更新进行限制,以更高效地权衡KL散度和奖励。根据裁剪方式不同,P3O分为V1(独立裁剪)和V2(联合裁剪)两个变体,在实验中均表现出色。
Q&A
P3O方法如何解决强化学习与人类反馈之间的矛盾?
P3O通过比较反馈统一奖励建模和微调过程,允许直接基于成对响应进行更新,从而解决了奖励学习阶段与强化学习微调阶段之间的矛盾。
P3O在生成任务中的表现如何?
P3O在生成任务中表现优于传统方法,更好地与人类偏好对齐,提升生成质量。
P3O与传统PPO方法相比有哪些优势?
P3O在KL-奖励边界和GPT-4的胜率方面均优于PPO,显示出更好的与人类偏好的对齐能力。
P3O是如何利用奖励差异而非绝对奖励的?
P3O通过引入成对策略梯度,利用奖励差异来避免奖励平移带来的问题,从而实现更有效的学习。
在评估中,P3O的表现如何?
在评估中,P3O在KL-奖励边界和GPT-4的胜率方面均表现优异,显示出其在与人类偏好对齐方面的优势。
P3O的实现过程中使用了哪些技术?
P3O使用了重要性采样和剪切技术,以提高性能并避免过大的梯度更新。
