本期周刊汇总多个独立开发变现案例:TopTrack.lol通过竞价榜首推广独立音乐;OpenTweet借助提价、AI搜索优化和用户对话实现4000美元MRR;pSEO驱动目录站获得百万曝光;RankLoop.ai专注AI搜索时代的外链自动化;Trendtrack以免费引流加深度分析收费,MRR达90万美元;JuicySearch切入OnlyFans搜索,30天获5万用户;此外还涵盖漏斗优化、macOS工具、SaaS模板及语音操控AI编程代理等案例。
创业者分享反直觉经验:方向比勤奋重要,方向错则越勤奋越糟;不追风口,靠常识降低失败率;C端产品重在坚持与独特品味,放轻松做自己;爱恨背后是利益,应以理性而非情绪应对;真正累人的是人际关系,能力越强越不受环境所困;不必攀附大佬,强大自身资源自来。
研究表明,代码整洁度对AI编程助手的任务完成率影响不大,但显著影响token消耗。干净代码可减少7%至8%的token使用,降低文件重复访问率34%。整洁代码提高效率,减少Agent的回头检查次数,表明其对代码的理解更清晰。因此,维护代码整洁性对降低AI使用成本至关重要。
大语言模型(LLM)不仅仅是预测下一个词的工具。虽然其训练任务是词汇预测,但为了提高准确性,模型必须学习语法、常识和推理等深层结构。这些能力使得模型在新场景中展现出智能行为,因此将其简单视为“猜词”是不全面的。
大模型的发展凸显了推理数据的重要性,优质推理数据集支持复杂推理任务。HyperAI整理了多领域推理数据集,降低了使用门槛,促进科研与模型训练。
本文介绍了一种基于层次记忆的预训练方法,旨在提升小型语言模型的性能。该方法通过访问大型记忆库,有效存储和提取长尾知识,同时保持常识理解。实验结果表明,使用这种记忆增强架构的小模型在性能上可与参数更多的常规模型相媲美,并在资源受限的设备上表现优异。
中国古代历法结合阴历和阳历,依据月相和太阳年制定。二十四节气反映季节变化,传统节假日如春节和清明体现了对自然、祖先和生活的理解与期待。
本文介绍了大噜公司上市(IPO)后的基本投资逻辑。上市使公司从私人转为公众公司,资金通过证券交易所募集。投资者可通过券商购买股票或选择基金、ETF等替代工具。不同市场存在不同风险和门槛,投资者需根据自身情况选择合适的投资方式。
杨乐坤在访谈中批评大语言模型,认为其智能水平不及狗,因缺乏与物理世界的关联。他提出的抽象世界模型(JEPA)强调抽象、分层、预测和最小消耗,以解决AI的局限性。杨乐坤计划创办AMI公司,专注于开源研究,支持自动驾驶和机器人技术。
摩尔线程上市后募集75亿资金,99%用于理财,引发公众愤怒和广泛批评,质疑其重理财轻研发。尽管有分析认为此举合规合理,但市场情绪和舆论压力依然显著。
达芬奇并非完美,他的成功源于复杂的故事和人们对阴谋论的偏爱。现代社会对偶像的崇拜反映了内心的空虚与不安。我们应承认达芬奇的不完美,以重拾勇气,面对不确定的世界。
许小年指出,经济学界和政策制定者缺乏常识,强调应尊重市场而非国家干预。他认为“常感”比“常识”更为重要,许多人缺乏基于常感的知识。通过历史案例,他说明政策失误源于短视。尽管户晨风学历不高,但在常感方面具有优势,反映出高智商人群常常缺乏常感。
机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。
Qwen与清华团队的研究表明,在大模型强化学习中,仅使用20%的高熵token即可显著提升训练效果,优于使用全部token。这一发现挑战了传统的二八法则,指出低熵token对推理贡献有限,可能限制模型的探索能力。聚焦关键token使模型在泛化能力上表现出色,训练过程中的熵模式演变也强调了高熵token的重要性。
软件开发的本质是解决问题。匈牙利数学家乔治·波利亚提出的思维方法对程序员有帮助,通过明确“未知”、“数据”和“条件”来有效调试和解决问题。他还强调实践和模仿,以提升问题解决能力。
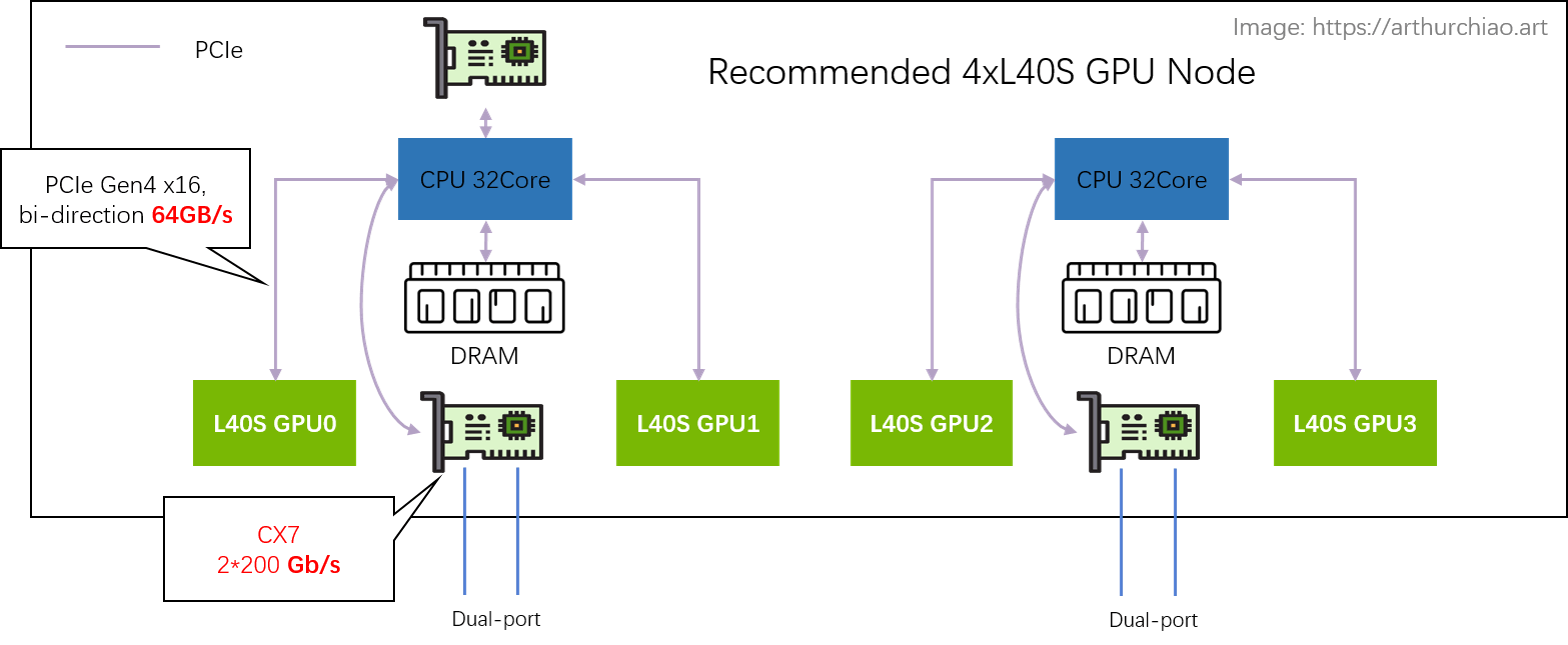
文章讨论了GPU、NPU和TPU等计算单元的特点及其在AI计算中的应用。GPU专注于并行计算,而NPU和TPU则是为特定算法定制的计算单元。文章还提到算力的限制因素,如GPU算力、显存大小和速率。NvLink和NvSwitch技术提升了GPU间的通信效率,解决了大规模计算的瓶颈。英伟达的GH200架构通过整合CPU和GPU,降低了系统间通信延迟,适用于超大规模模型的训练和推理。
JdocQA是一个日本语的VQA数据集,包含四个回答,旨在测试常识,帮助减少LLM的幻觉。研究涉及OCR-VQA等模型和数据集,并通过多种指标进行评估。
本研究旨在解决网络虚假信息日益严重的问题,通过提出一种新颖的虚假信息检测方法——潜在常识冲突检测(MD-PCC)。该方法利用常识冲突构建文章的常识表达,增强检测的有效性。实验证明,MD-PCC在多个数据集上的表现优于现有的虚假信息检测基线,展现出显著的检测能力提升。
本研究提出了WinoWhat,一个新的语料库,包含WinoGrande验证集的意译,并评估语言模型在五个常识知识类别上的表现。结果显示,所有模型在WinoWhat上的表现远低于预期,表明对WinoGrande的推理能力评估被高估。
本研究解决了物理人工智能系统在感知、理解和执行复杂物理行为中的不足。通过定义物理常识和具身推理的关键能力,提出了宇宙推理1模型,能够通过长链推理过程在自然语言中生成适当的决策。研究表明,物理人工智能的监督微调和强化学习显著提高了模型的表现,为物理人工智能的发展奠定了基础。
完成下面两步后,将自动完成登录并继续当前操作。