DigitalOcean推出批处理推理功能,可将大量AI请求作为异步任务提交,结果在24小时内返回。相比实时推理,使用OpenAI和Anthropic模型最高可节省50%费用,且采用独立速率限制,不影响生产流量。该功能适用于文档提取、工单分类、内容审核、商品文案生成和模型评估等无需即时响应的场景,不适合交互式功能。平台支持自动重试、错误文件和续跑任务,输入文件上限为200MB、5万条请求。
文章指出,RTX 4090 D解锁仅恢复FP16/BF16/TF32浮点Tensor吞吐,而低比特量化MoE推理主要使用INT8/INT32整数指令,整数吞吐未变。Strata专家内核采用纯整数mma指令,瓶颈在显存带宽、PCIe传输与CPU卸载,而非浮点算力。48GB 4090实测预填充为原版0.98–0.99倍,本地长窗口无明显收益。解锁真正受益于LoRA/SFT微调、扩散模型及BF16大批量稠密推理。
文章解释专家缓存不适用于稠密模型:MoE每Token仅激活约3B参数,可缓存热点专家;而Qwen3.8-27B每Token需计算全部27B权重,按Token搬运权重受PCIe带宽限制。作者在16GB显存上实现稠密推理引擎,通过显存预算规划、零拷贝放置、12种GGUF量化块原位GEMV、单流子层融合及分块注意力显著降低延迟,但整网端到端吞吐仍待实测。
文章以“小螃蟹选场地”为例说明AI推理:理解是弄清要求,推理是结合事实与条件判断结论;有资料还要会用,缺信息应列为待确认。文章介绍演绎、归纳、溯因三种推理方式,强调理由长不等于正确,需核对证据与约束;并区分机器学习中的inference与逻辑reasoning,提醒为结论保留核验路径。
文章比较自托管推理引擎与托管云推理平台:月调用量低于5亿token时托管总成本更低,超过10亿token后自托管单token成本优势明显,拐点约在5亿至10亿之间。自托管需承担GPU运维,vLLM最常用,TensorRT-LLM吞吐略高但更复杂;托管平台省运维但按量计费。两者可混用,稳态走自托管、突发溢出到托管。
DigitalOcean 无服务器推理正式推出提示缓存:缓存输入费用最高减免 90%,首字延迟降低 80%。新增缓存亲和路由,将重复请求导向已缓存提示的副本,命中率从约 35% 提升至 90% 以上。新增 prompt_cache_key 用于账户内流量隔离,支持 Responses API,上下文窗口提升至 256K 以上,并提供控制面板仪表盘查看命中率与节省费用。缓存自动生效,无需修改请求代码。
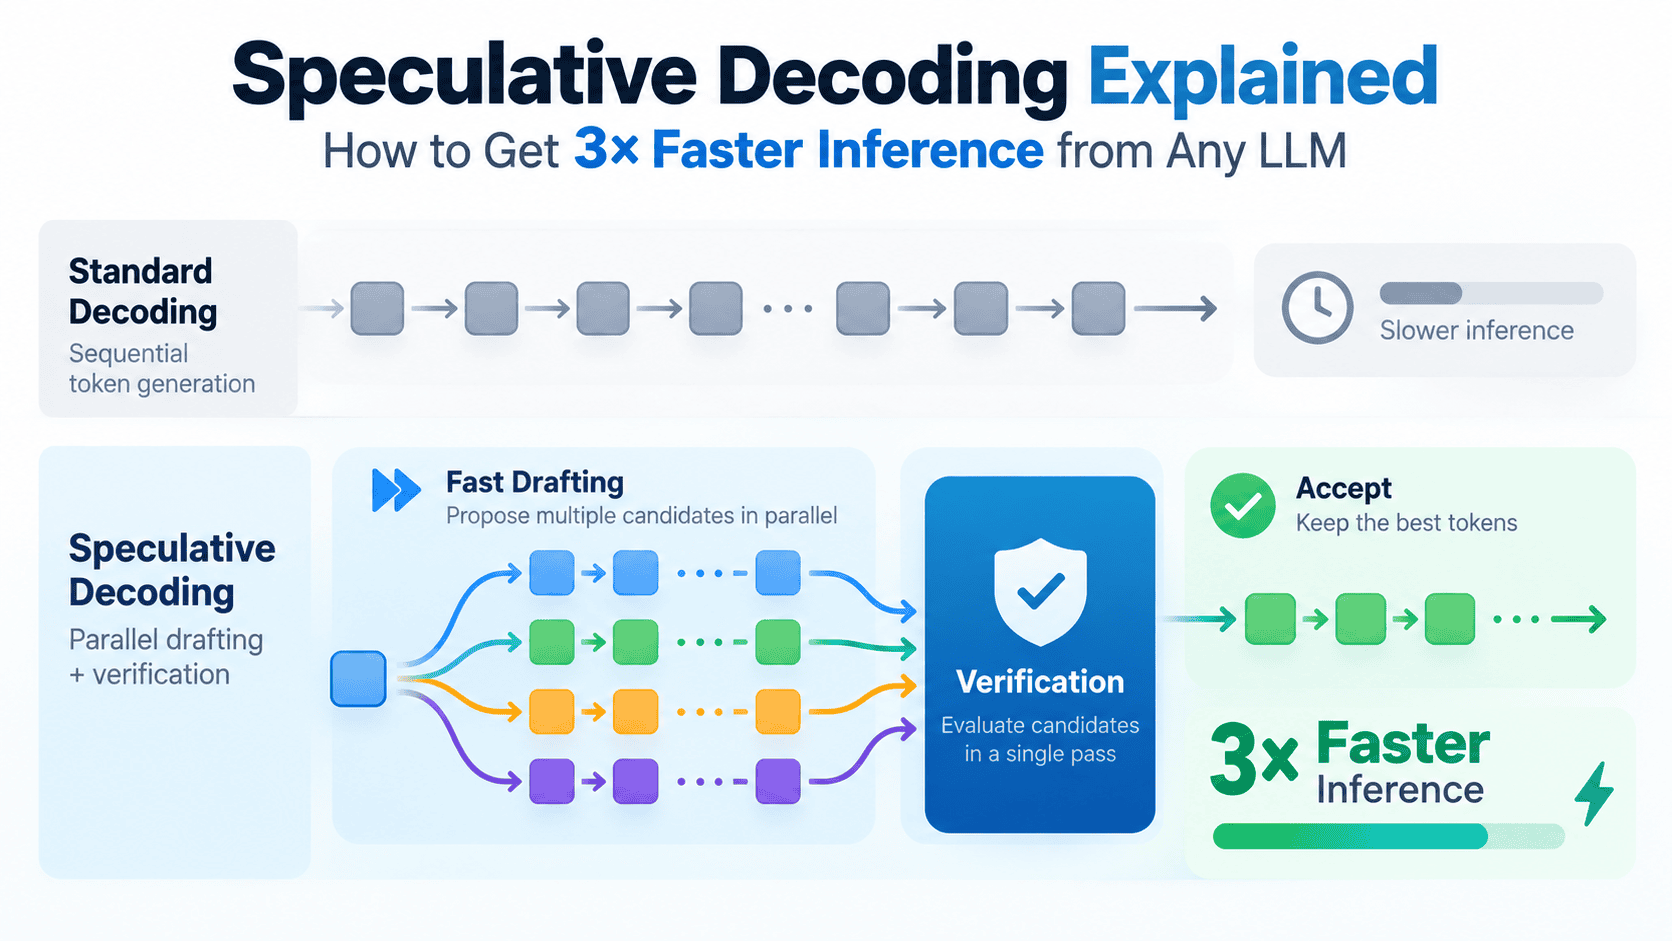
投机解码通过“草稿—验证”机制加速大模型推理:小模型快速生成候选token,大模型并行验证,保证输出分布与原模型一致。瓶颈在显存带宽而非算力,接受率约70%—80%时可达2—3倍加速。Medusa、Eagle、Prompt Lookup等变体无需独立草稿模型。该技术适合长输出、低并发场景,高批量服务可能降低吞吐。
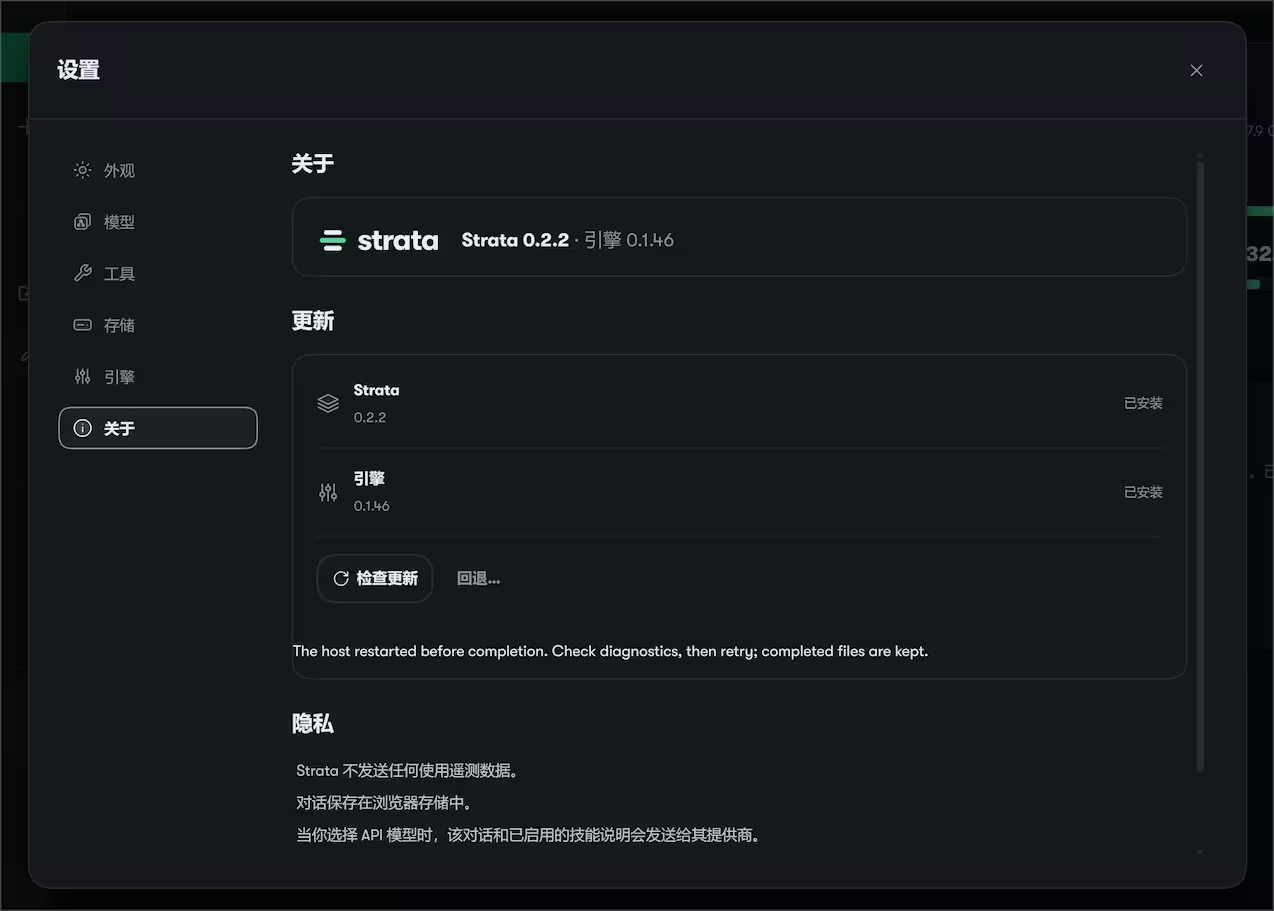
Strata 0.2.2 正式版发布,新增多显卡角色管理,用户可手动指定主卡、辅助卡或禁用,并按性能分配任务。Gyro 量化模型在部分 NVIDIA 显卡上推理提速最高约 30%,并扩展支持 Mac、Intel Arc 和 AMD RX 6000。此外,该版本统一桌面与命令行模型目录,支持损坏分块重下,修复重复自动调优,并允许关闭 API 密钥。
Elastic将Jina API和Elastic推理服务从NVIDIA L40迁移至RTX Pro 6000 Blackwell GPU,以加速智能体AI工作负载。实测显示:嵌入请求延迟最高降低约8倍,重排序提速4倍以上,OCR页面转换速度提升约3.7倍;混合负载下小请求延迟从708毫秒降至66毫秒。Jina小型模型在准确性和多语言、多模态覆盖上表现领先,迁移后客户无需改动即可受益。
DeepSeek开源推理框架改写AI盈利规则! DeepSeek开源DeepInfer推理框架,单集群日吞吐155万亿token,每卡每小时收入38美元,这组硬核数据直接打脸AI不赚钱论调,揭示开源模型正在重塑AI商业格局与盈利逻辑走向。 DeepSeek开源推理框架引发行业地震
公开基准仅反映模型最优表现,无法保证生产环境中的稳定准确。Nebius的Wang建议结合内部基准与真实工作流评估开源模型,并关注整个推理栈,包括缓存命中率、吞吐与并发、P95/P99延迟和首字延迟。模型并非越大越好,应平衡精度与规模,必要时拆分任务或微调小模型。
作者在移植60多个AI模型后总结:单流解码首选TensorFold,速度是vLLM的1.3至3倍,DeepInfer潜力相当;高并发场景选vLLM和SGlang,配合DFlash2后单流表现也优秀,两者差别不大,SGlang跟进新模型更快;Strata仅适合32GB小显存的消费级显卡,在128GB设备上解码速度不足vLLM一半,不建议使用。
DeepSeek以Apache 2.0协议开源生产环境推理框架DeepInfer,支持在自有基础设施上运行V4.1 Flash模型,包含优化计算内核、通信库、投机解码与异步调度等组件;同时开源deepseek-recipe库以帮助复现官方API行为。该框架支持英伟达SM100及华为昇腾950 NPU,但部分功能仅限英伟达,且尚缺KV缓存管理等完整生产组件。
DeepSeek正式开源大规模云服务推理框架DeepInfer,并同步开源生产级Token编解码组件Deepseek-recipe,与官方API逻辑对齐。基于DeepInfer,DeepSeek V4.1 Flash实现高吞吐、低延迟推理,单集群日吞吐达155万亿Tokens,每卡每小时收入38美元。该框架集成高性能算子,支持分布式推理、推测解码等,兼容英伟达与华为昇腾平台,未来新模型推理代码将持续更新。
是石科技发布TokenFleet分布式调度框架,聚焦请求路由、跨机房容量协同与混合负载治理。其中TokenPilot兼顾缓存复用与排队代价选择节点,FleetMind协同多机房可用容量,SLOMax按服务等级分池排队。框架以达标输出吞吐(Goodput)为优化目标,测算显示达标吞吐提高约29.4%,达标比例从约67%升至约86%。
Cloudflare优化其AI代码审查代理,将平均审查成本从2.43美元降至0.77美元(降68%),中位耗时从4分09秒缩短至1分32秒。约40%的节省来自代码优化,其余来自模型与推理强度调整。关键措施包括:各仓库共享缓存前缀、减少LLM调用、并行读取文件、跳过无新内容的复审。质量评估显示,高强度下代码质量审查仍能发现相当数量的真实问题,且误报和严重性虚高大幅减少。
商汤大装置CTO宣善明指出,Agentic时代Token需求将增长千倍,AI基础设施须从规模扩张转向效率优化。商汤通过PD分离与异构混合调度构建万卡级推理集群,以动态角色切换应对故障与闲置,特定配置下Token吞吐提升至5倍。未来将探索跨域PD分离与AF分离,并以Token工厂模式提升产能,日均服务量已达6万亿。
DeepSeek-V4.1-Flash-1017的编程分数涨了,竞赛推理却崩了! 这版模型官方晒出的基准测试表上,DeepSWE v1.1拿七十七分,把Claude Opus 5的七十四分压在身下。数字漂亮得像过年贴的福字,可一碰没见过的竞赛题,三档推理强度全挂,一次没对。 二零二六年十月十七日,DeepSee
文章讨论小参数语言模型在搜推场景的推理优化,核心是在延迟约束下追求有效吞吐,而非单纯追求吞吐数字。压测应将超时请求计为失败,明确端到端延迟预算并区分排队与计算耗时;合批需权衡等待成本,压测应贴近真实请求分布并关注尾部延迟。工程上应设置调用超时、及时停止过期任务、限制重试并演练降级,通过小流量对照验证质量与资源消耗。
Spotify将生成式AI用于播客推荐,采用基于语义ID的生成式检索与beam search生成候选。因vLLM的beam search效率有限,Spotify与NVIDIA合作改进TensorRT LLM,补齐多序列返回、评分API和软令牌注入等功能,并探索用用户嵌入投影实现个性化。优化后beam search成本降低最高54%,评分成本降低7%。
完成下面两步后,将自动完成登录并继续当前操作。