小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
基于选择的结构化推理:迈向高效的多模态搜索智能体

SSR框架将多模态智能体推理改为从预设候选语句中选择而非自由生成,无需辅助任务头,支持并行评分。在七个搜索基准上,2B和4B模型表现与同类领先智能体相当,每轮推理延迟降低超90%,单题总推理延迟降低28%至54%。

基于选择的结构化推理:迈向高效的多模态搜索智能体

Apple Machine Learning Research Apple Machine Learning Research · 2026-10-15T00:00:00Z
套利:通过优势感知投机实现高效推理

ARBITRAGE是一种新型步骤级投机生成框架,通过轻量级路由器动态选择草稿模型或目标模型生成的推理步骤,以近似最优效率-准确性权衡。相比传统令牌级和现有步骤级方法,它减少不必要的拒绝和重生成,在数学推理基准上推理延迟降低约2倍,同时保持匹配的准确性。

套利:通过优势感知投机实现高效推理

Apple Machine Learning Research Apple Machine Learning Research · 2026-08-07T00:00:00Z

本文探讨大语言模型推理延迟问题,涵盖预填充与解码两阶段及TTFT、TPOT指标。提出七种优化方法:模型量化、KV缓存、投机解码、连续批处理、剪枝蒸馏、优化推理引擎及提示压缩缓存。强调组合应用这些技术可显著降低延迟,但需权衡成本与复杂度,以提升生成式AI应用效率。

降低LLM工作流推理延迟的七种方法

KDnuggets KDnuggets · 2026-08-04T12:00:59Z
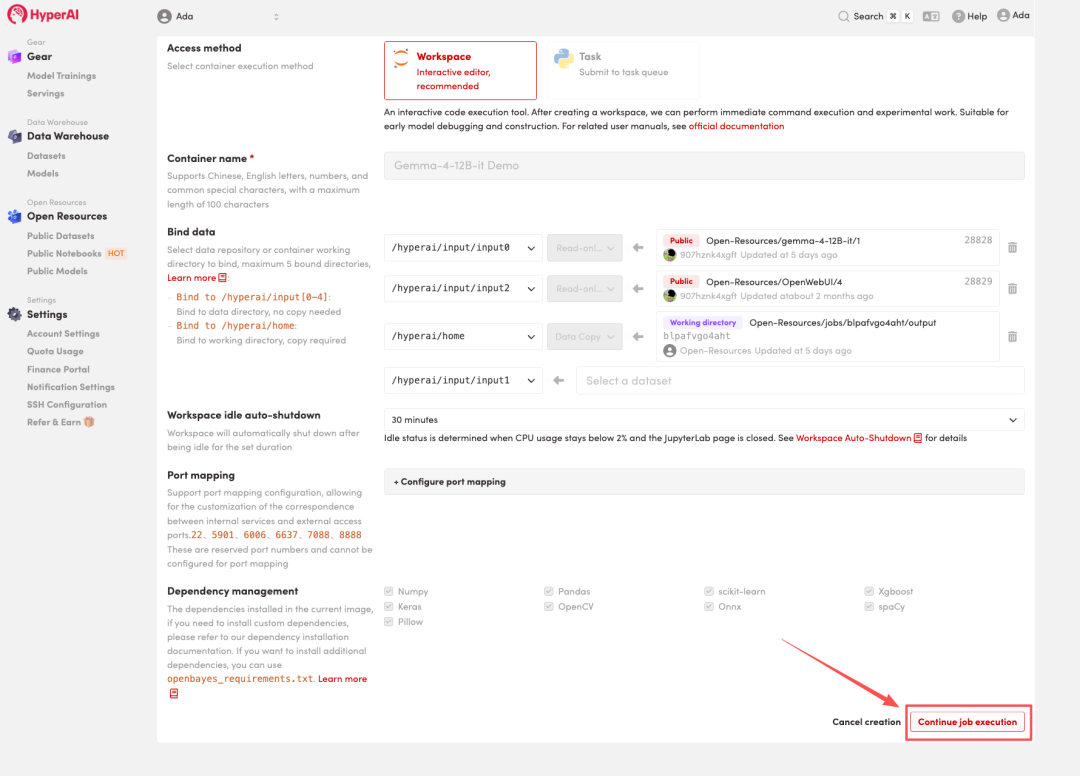
在线教程丨16GB笔记本跑出接近26B MoE性能,Gemma 4 12B基于创新架构统一处理文本/图像/声音三种模态

Google DeepMind 发布了新款多模态模型 Gemma 4 12B,参数为120亿,但在多项测试中表现接近260亿参数的模型。其无编码器架构显著降低了推理延迟和内存占用,支持音频输入,并可在普通笔记本上运行,降低了部署成本,为开发者提供了接近顶级性能的选择。

在线教程丨16GB笔记本跑出接近26B MoE性能,Gemma 4 12B基于创新架构统一处理文本/图像/声音三种模态

HyperAI超神经 HyperAI超神经 · 2026-06-10T03:09:51Z
用 Amazon SageMaker AI 与 Qualcomm AI Hub 打通从云端训练到端侧神经处理单元(NPU)的交付闭环

本文介绍了如何结合Amazon SageMaker AI与Qualcomm AI Hub,实现从云端训练到端侧NPU的端到端工作流。通过微调模型并在真实设备上进行编译与验证,整个过程可在约20分钟内完成,显著缩短了AI项目的上线时间。以手机人像分割为例,最终在Galaxy S24上实现了13.59毫秒的推理延迟,展示了该方案的高效性与实用性。

用 Amazon SageMaker AI 与 Qualcomm AI Hub 打通从云端训练到端侧神经处理单元(NPU)的交付闭环

亚马逊AWS官方博客 亚马逊AWS官方博客 · 2026-05-28T09:54:27Z
Tensor Fusion - 一种开源的GPU虚拟化和资源池解决方案,旨在提升集群利用率...

Tensor Fusion是一种针对GPU集群的虚拟化和资源池解决方案,旨在提升集群利用率和降低推理延迟。它支持动态GPU池、低延迟推理、自动扩展和调度,适合高推理密度和多租户环境,有效处理多模型和多租户工作负载。

Tensor Fusion - 一种开源的GPU虚拟化和资源池解决方案,旨在提升集群利用率...

云原生 云原生 · 2026-01-06T10:34:15Z
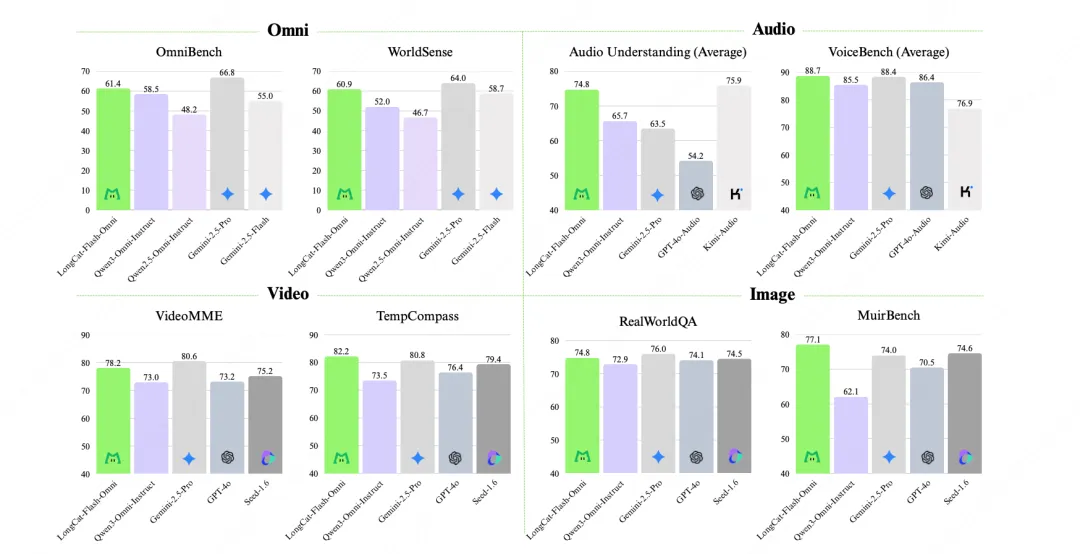
LongCat-Flash-Omni 正式发布并开源:开启全模态实时交互时代

美团推出了LongCat-Flash-Omni模型,参数达到5600亿,支持低延迟音视频交互,表现优异。该模型在多模态任务中实现了开源最先进水平,具备强大的文本、图像、音频和视频理解能力,有效解决了推理延迟问题。

LongCat-Flash-Omni 正式发布并开源:开启全模态实时交互时代

实时互动网 实时互动网 · 2025-11-03T02:17:46Z

本文介绍了physical intelligence公司推出的实时动作分块技术,旨在提升视觉-语言-动作模型(VLA)的实时控制能力。该技术通过异步机制和修复方法,解决了模型推理延迟和动作不连贯的问题,使机器人能够更精确地执行复杂任务。

实时动作分块RTC——为解决高延迟,让π0.5也可以点燃火柴、插入网线:执行当前动作分块时生成下一个分块,且已执行的冻结 未执行的则补全

结构之法 算法之道 结构之法 算法之道 · 2025-07-15T08:43:07Z
SPD:大语言模型高效张量并行的同步点丢弃技术

随着大语言模型的快速发展,分布式推理中的通信开销成为主要挑战。我们提出了一种新技术Sync-Point Drop(SPD),通过选择性减少注意力输出的同步,降低通信开销。SPD在保持模型准确性的同时,有效缓解了通信瓶颈,实现了约20%的推理延迟减少,准确率下降不足1%。

SPD:大语言模型高效张量并行的同步点丢弃技术

Apple Machine Learning Research Apple Machine Learning Research · 2025-05-22T00:00:00Z

本研究提出了一种新的语音推测解码(SSD)框架,旨在解决自回归语音合成模型的推理延迟问题。SSD通过轻量级草稿模型生成候选标记序列,推理速度提高了1.4倍,同时保持了高保真度和自然性。

Accelerating Autoregressive Speech Synthesis Inference Using Speech Speculative Decoding

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-21T00:00:00Z

华为提出OmniPlacement方法,通过优化混合专家模型中的专家分配,降低推理延迟约10%,提升吞吐量。该方法动态调整专家优先级、冗余部署和实时调度,解决专家负载不均的问题,确保高负载下系统稳定运行,并计划开源。

华为:让DeepSeek的“专家们”动起来,推理延迟降10%!

量子位 量子位 · 2025-05-20T05:36:27Z

该研究提出了FORTRESS框架,旨在解决大型视觉和语言模型在处理分布外故障时的推理延迟问题,实时生成安全后备策略,从而提高系统安全性和规划成功率。

Real-time Out-of-Distribution Fault Prevention through Multimodal Reasoning

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-15T00:00:00Z

本研究提出了一种资源感知的Transformer架构分区算法,旨在解决边缘环境中大型语言模型推理的内存过载和高延迟问题。该算法动态更新分区决策,优化注意力头的分配与迁移,实验结果表明推理延迟与最优解相差仅15%至20%,显著提升了推理速度和内存效率。

Large Language Model Partitioning for Low-Latency Inference at the Edge

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-05T00:00:00Z

本研究提出共享RAG-DCache,通过共享磁盘键值缓存管理,解决大型语言模型推理延迟问题。该方法在多实例环境下显著提高推理吞吐量,提升15~71%,延迟降低12~65%。

Shared Disk KV Cache Management for Efficient Multi-Instance Inference in RAG-Powered LLMs

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-16T00:00:00Z

本研究提出了一种高效的草拟模型,解决了大语言模型在投机解码中的记忆需求、短训练数据与长上下文推理的挑战,显著提升了长上下文任务的性能并减少了推理延迟。

LongSpec: Efficient Drafting and Verification for Long Context Speculative Decoding

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-24T00:00:00Z

本文讨论了基于Transformer的文本嵌入模型在参数增加时的推理延迟和内存使用问题。提出的Nomic Embed v2是首个通用的专家混合文本嵌入模型,性能优于同类模型,具有重要的应用潜力。

Training Sparse Mixture of Experts Text Embedding Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-11T00:00:00Z

本研究提出了一种改进的Chinchilla扩展法,通过优化模型参数、训练标记和结构,Morph-1B模型在保持准确性的同时,推理延迟效率提高了1.8倍。

Efficient Inference for Scalable Language Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-30T00:00:00Z

本研究探讨了大型语言模型在飞行轨迹预测中的应用,重构问题和构建数据集显著提高了预测准确性,但高推理延迟限制了实时应用。

用于单步和多步飞行轨迹预测的大型语言模型

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-29T00:00:00Z

本研究提出RE-POSE框架,旨在解决边缘设备实时物体检测中的计算资源限制和深度神经网络的高需求问题。通过强化学习驱动的动态聚类算法,优化了检测精度与延迟,并采用并行边缘卸载方案,显著提高了检测精度,减少了推理延迟,性能优于现有方法。

RE-POSE: Synergistic Reinforcement Learning-Driven Partitioning and Edge Offloading for Edge Object Detection

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-16T00:00:00Z

本研究提出了一种新方法,通过在边缘设备与中央服务器之间划分深度神经网络,解决资源受限设备中的语义分割推理延迟问题,实现数据本地处理,显著降低延迟。

使用分割学习最小化计算机视觉中的语义分割延迟

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-18T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码