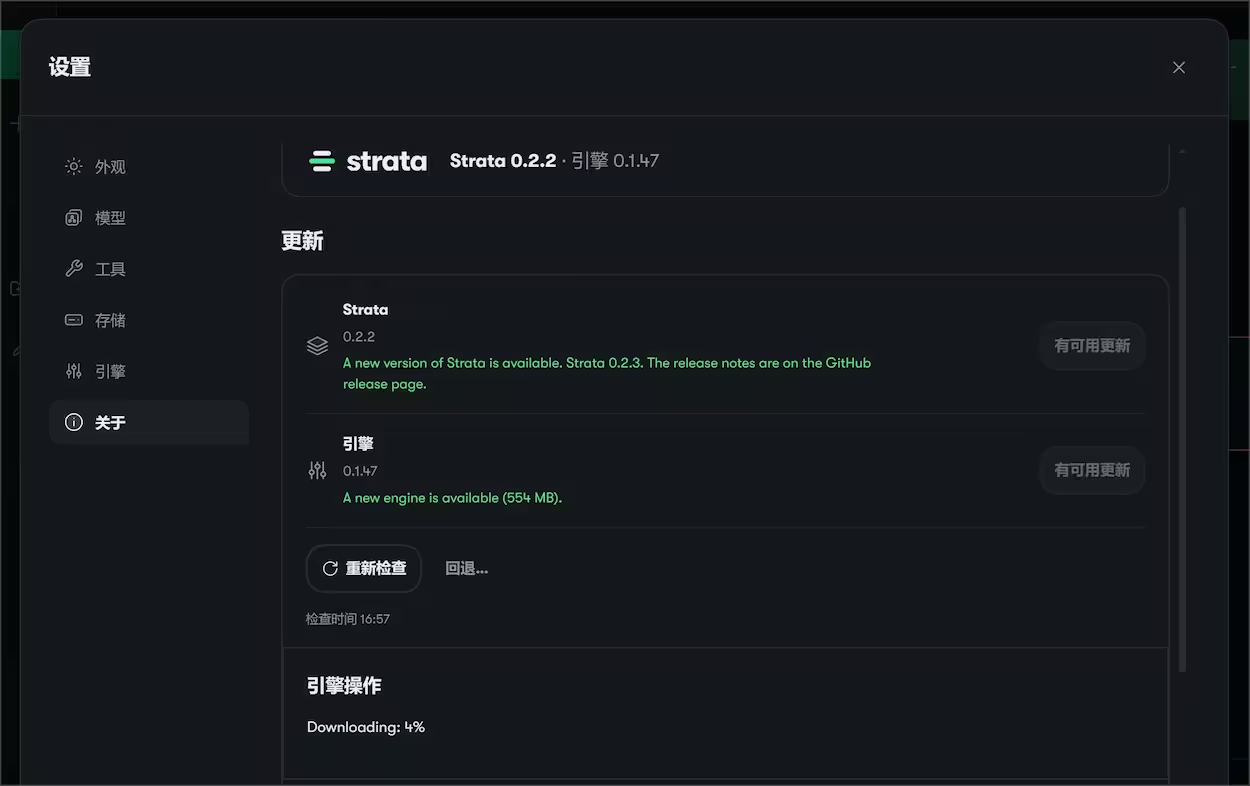
Strata 0.2.3 发布,引擎同步升级至 0.1.48,重点提升推理性能与 AI Agent 长对话体验。AMD Strix Halo 回答速度提升 6%~19%;RTX 5070 12GB 上 Gyro-S 生成速度从 31 提升至 45 tokens/s,约提升 45%。新增自动检查上下文、分段总结旧消息及“总结并继续”选项,并提供 /compact 命令压缩对话历史。另加入需手动开启的实验性 DFlash2 推测解码,正式提供 Intel Arc Linux SYCL 推理引擎,并修复 macOS 长提示词问题。
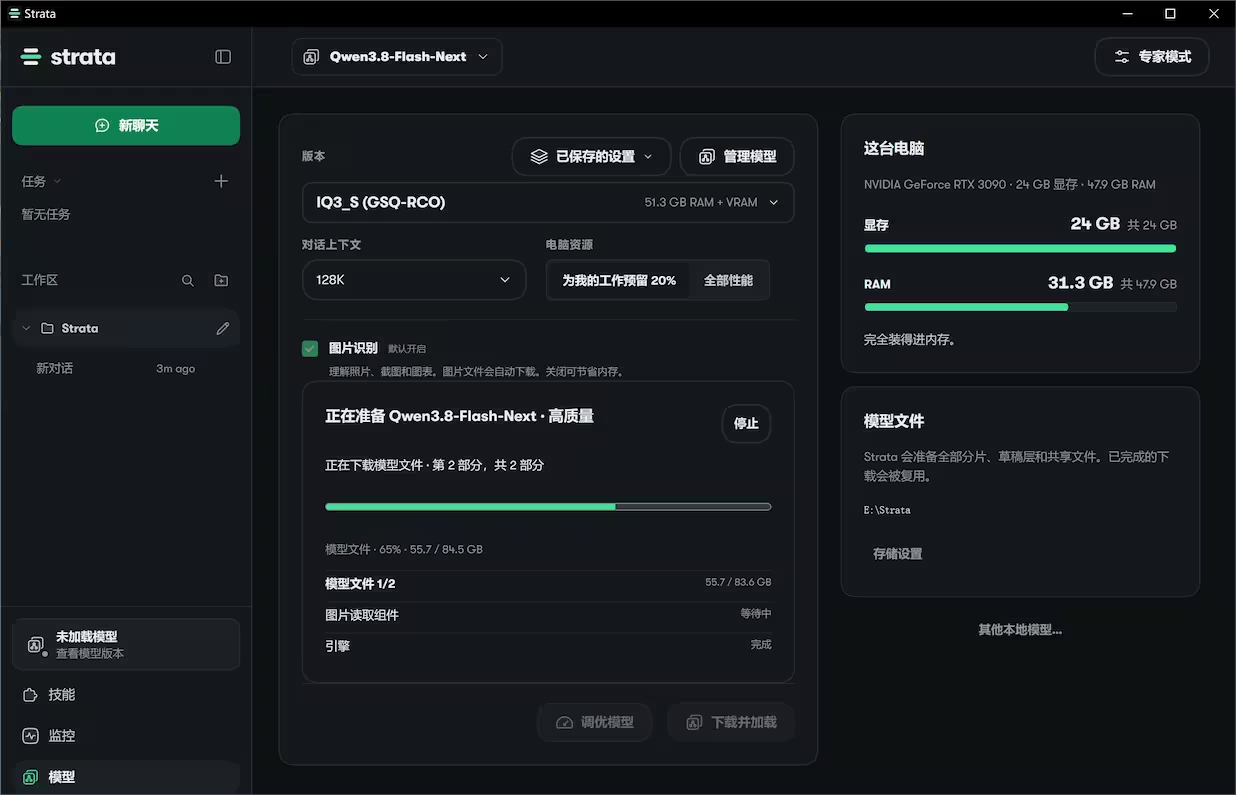
Strata 0.2.0 测试版发布,这款开源工具支持在普通电脑本地运行大模型。新版将硬件门槛降至内存加显存最低 27.6GB,新增独立图形界面和中文界面,支持 Windows、macOS、Linux,无需命令行部署。推理性能优化:RTX 30 系文本生成最高提升约 13%,AMD RX 9000 提示词处理接近翻倍,Intel Arc A750 提升约 42%。同配置下可选更高质量量化模型,并集成 AI 编程 Agent,优化模型下载。
用户测试了专为Qwen优化的推理框架Ninfer,并与优化后的vLLM对比。在Qwen 3.8 27B、开启CUDA Graph下,vLLM的Decode和Prefill性能全面超越Ninfer,解码最高63.34 TPS,Prefill最高3230 TPS,TTFT低至0.15秒。多数场景vLLM更快,250K Prefill和TTFT领先达54.5%。优化后单流解码提升8.6%~14.5%,并发吞吐提升约15.6%。
vLLM 是加速大语言模型推理的框架,实现KV缓存零浪费。文章提供Helm图表部署配置及EAGLE投机解码示例,通过离线推理脚本展示如何用vLLM加载模型、设置采样参数并计算平均接受token长度,以优化推理性能。
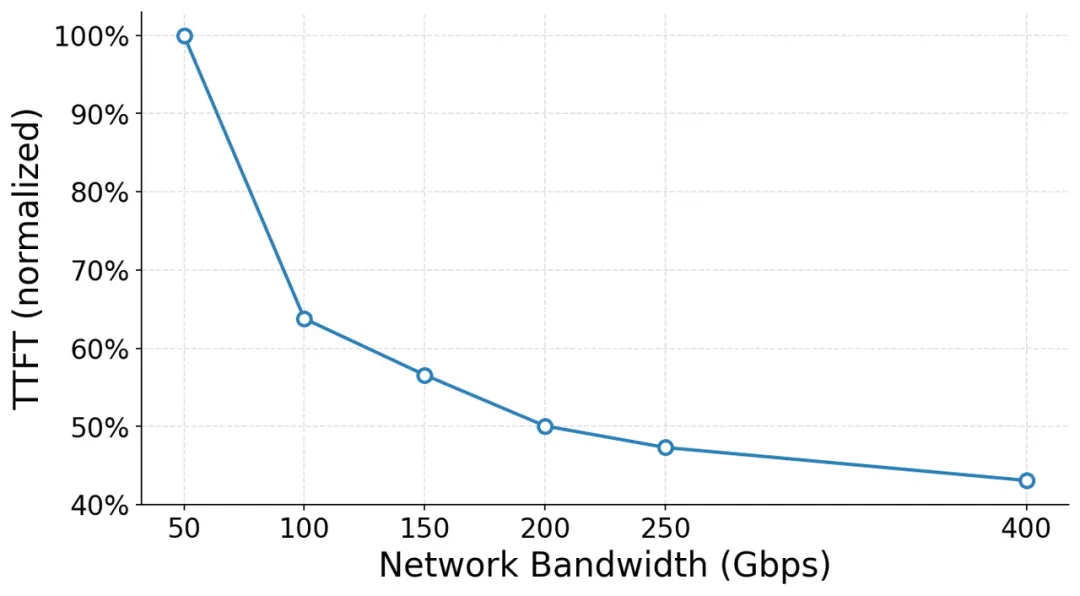
本文介绍如何测量Transformer模型推理性能,核心指标包括延迟、首令牌时间(TTFT)、每输出令牌时间(TPOT)、吞吐量、内存使用和每令牌成本。测量需区分预填充和解码阶段,使用墙钟计时或CUDA事件,并注意GPU同步和预热。并发请求测试可评估吞吐量,多GPU可复制或分区模型。最终需结合成本与质量评估系统效率。
阿里真武M890超节点成功适配Qwen3.8,上线阿里云百炼平台,成为国内首个运行超2万亿参数大模型的超节点。该超节点通过高速互联芯片实现64张GPU卡800GB/s连接,显存达9TB,支持大规模MoE模型,推理性能最高提升1.5倍,显著降低推理成本。
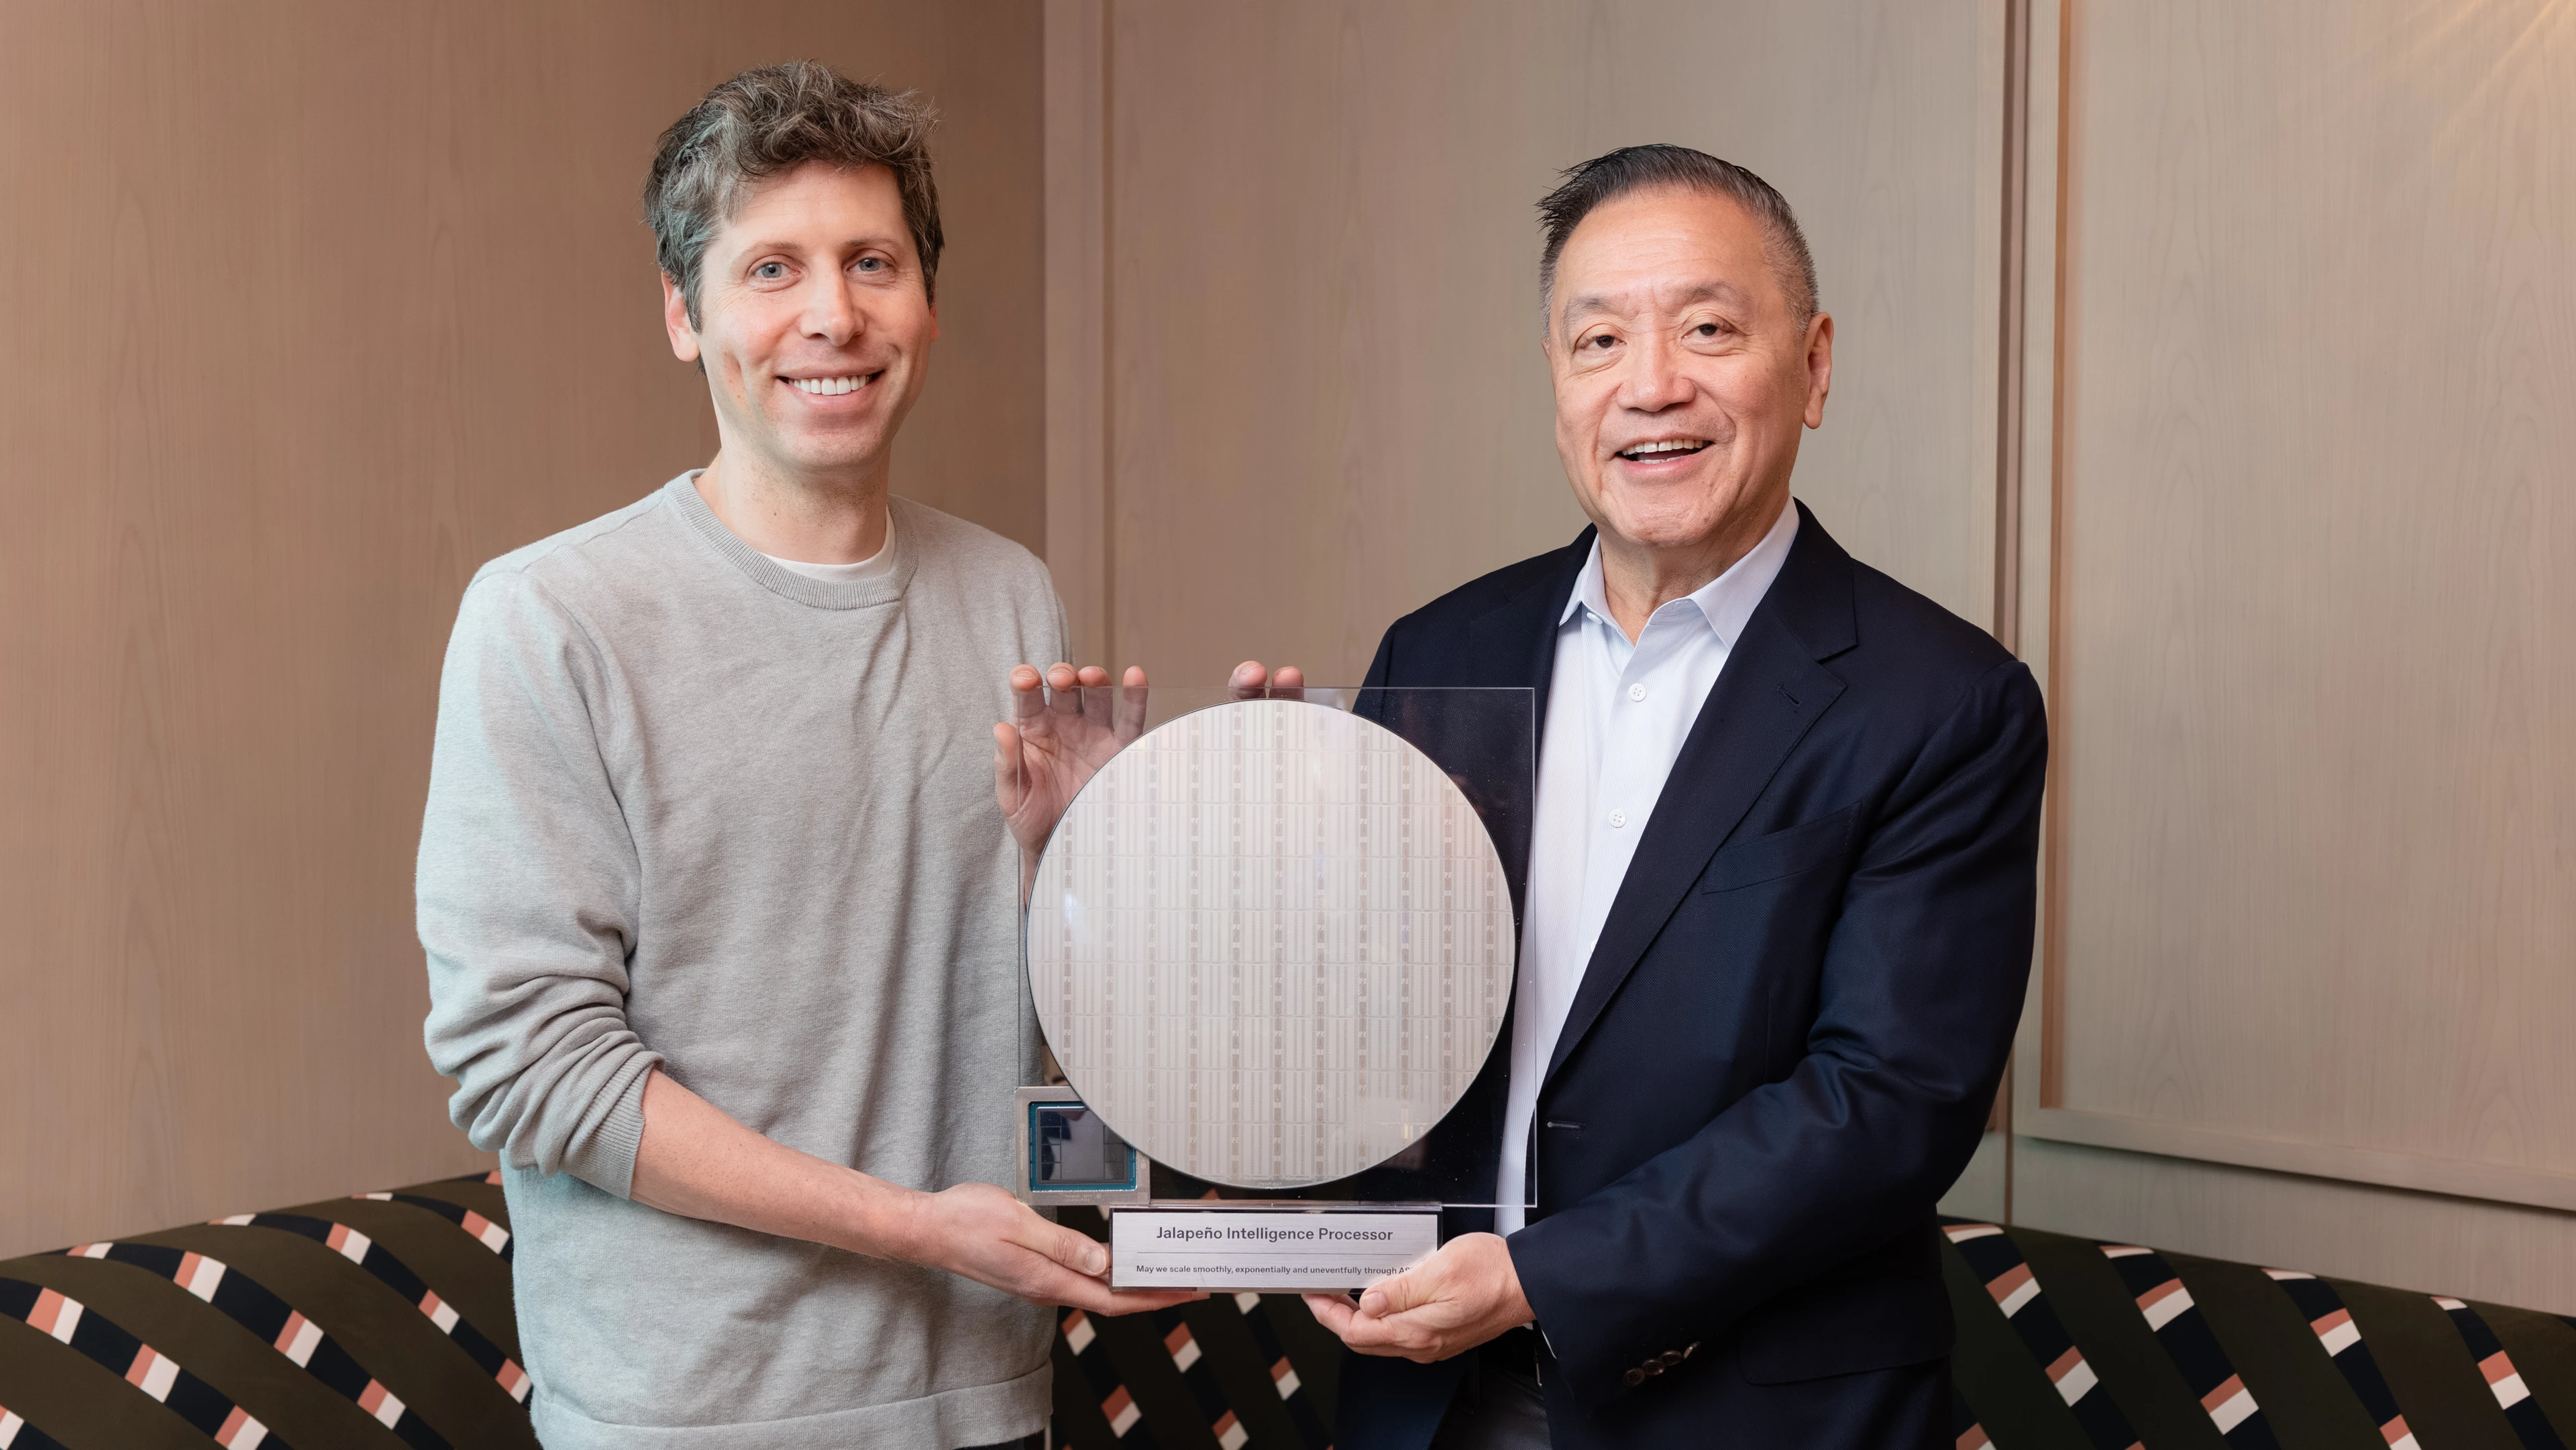
OpenAI与博通联合推出Jalapeño智能处理器,旨在提升大语言模型的推理性能。该处理器在九个月内完成设计与生产,优化了计算、内存和网络资源,预计将显著提高每瓦特性能,支持未来多代AI模型,推动AI更快、更可靠和更普及。
动态批处理通过实时组合多个推理请求,提高GPU利用率并减少延迟。语义缓存在请求到达推理队列前识别并重用相似查询的响应,从而降低成本和延迟。Redis为AI工作负载提供高效的实时数据平台,优化推理性能。
DigitalOcean致力于为下一代AI提供高性能基础设施,专注于在AMD GPU上托管大型语言模型(LLMs)。通过深度优化软件堆栈,显著提升了推理性能并降低了成本。研究表明,优化硬件与软件的互动可以提高效率,未来将发布针对不同前沿模型的技术优化分析。
ZCube架构通过扁平化网络设计解决了PD分离部署中的网络拥塞问题,相较于传统ROFT架构,在成本、吞吐量和延迟上均有显著提升,降低了结构性拥塞的发生概率,提升了推理性能和成本效率。
DigitalOcean推出DeepSeek V3.2、MiniMax-M2.5和Qwen 3.5 397B,优化了硬件和软件,提升了推理速度和效率,满足现代AI应用的低延迟需求。
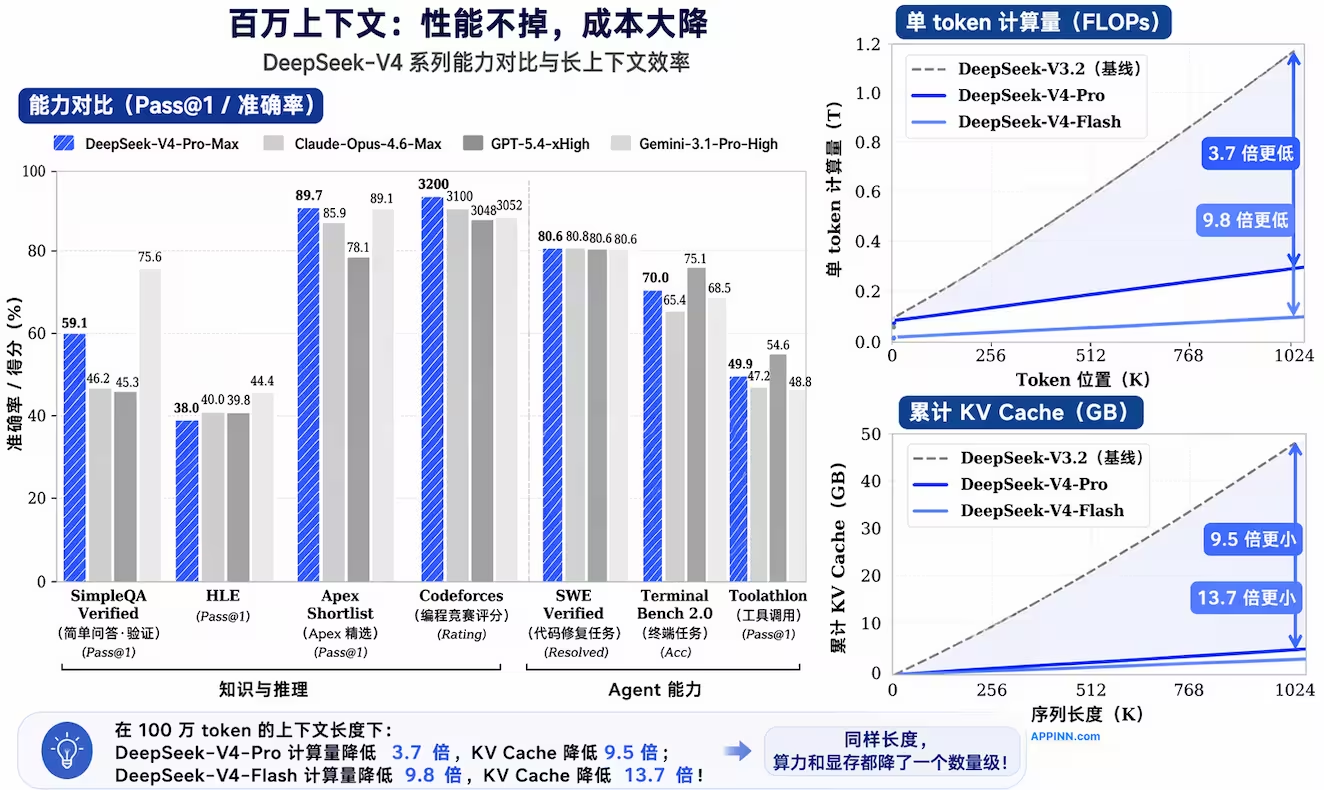
华为云于4月24日发布并开源DeepSeek-V4模型,该模型支持百万Token超长上下文,提升了推理性能和经济性。新模型已被金山办公、360等企业接入,支持高效API服务,优化了调度和计算效率。
DeepSeek V4 发布,具备 1M 上下文和显著提升的代码能力,推理性能接近顶尖模型。新注意力机制降低计算需求,支持更多请求。V4 Pro 价格上涨,但在知识和推理任务上表现优异。现已上线官网和 API,无法自行部署。
PyTorch 2引入torch.export功能,允许将模型导出为静态图以优化推理性能。自定义操作可通过无状态的torch.ops或有状态的torch.classes定义。导出时需避免数据依赖形状和控制流,以确保模型可静态表示。导出的模型可在Python中保存和加载,但在C++中需使用AOTInductor或Executorch进行优化和编译,确保模型无图断裂是推理的关键。
NVIDIA Dynamo 1.0在GTC发布,现已为DigitalOcean客户提供,推理性能提升7倍,成本降低。结合DigitalOcean的Agentic Inference Cloud,客户可高效部署,优化推理工作负载,支持GPU集群,提升吞吐量和降低延迟。
Workato的AI研究实验室与DigitalOcean合作,利用NVIDIA Dynamo和vLLM优化推理性能。通过引入KV感知路由,显著提高了GPU的吞吐量和响应速度,分别提升67%和降低79%的延迟,从而降低了推理成本和所需GPU数量。
由于内存供应紧张,英伟达将迷你 AI 工作站 DGX SPARK 的价格从 3,999 美元上涨至 4,699 美元,涨幅达18%。该工作站支持本地运行200B参数模型,推理性能达到1petaFLOP。
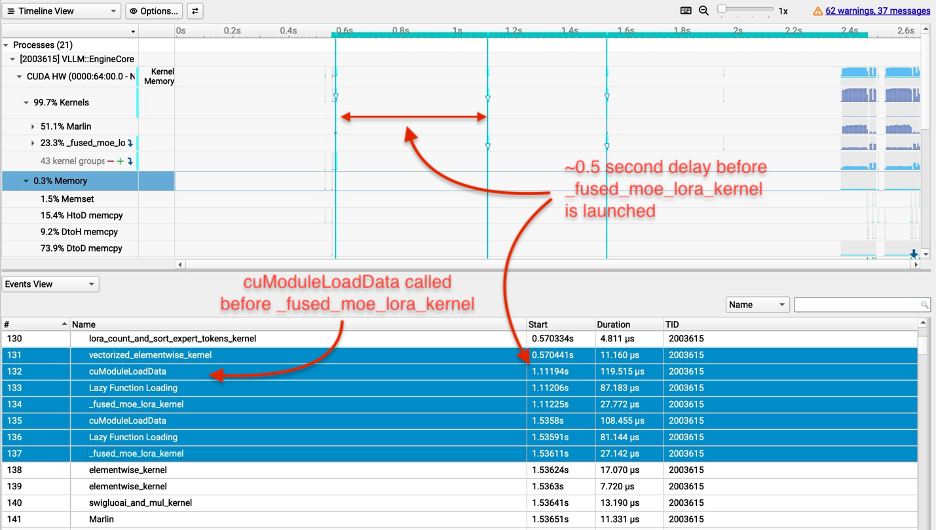
为解决多模型AI服务的闲置GPU成本问题,我们与vLLM社区合作开发了Multi-LoRA技术,允许多个模型共享同一GPU,优化MoE模型的推理性能。该技术通过保持原始权重不变,仅调整小型适配器,显著提升了输出速度并降低了延迟,适用于多个开源MoE模型,并已在Amazon SageMaker和Bedrock上实现。
文章讨论了AI基础设施的最新动态,重点在于硬件加速和智能体记忆层的进展。ntransformer和Taalas ASIC优化了推理性能,Aethene和zclaw则提出了智能体记忆和边缘部署的新思路。企业AI正向规模化发展,推理成本成为关键挑战。
谷歌发布Gemini 3.1 Pro,推理性能是3 Pro的两倍,支持复杂任务生成3D可视化内容。该模型在多模态理解和长上下文方面有显著提升,用户反馈良好,定价与前代相同,智能成本持续下降,推动大模型发展。
完成下面两步后,将自动完成登录并继续当前操作。