

本文探讨了Lucene中的查询执行过程,重点介绍了BooleanQuery与BooleanScorer的实现,以及通过两阶段迭代优化查询效率。采用galloping和impacts等技术,减少无效文档处理,提高搜索性能,并讨论了分布式查询中的优化策略和开放问题。
标准RAG教程介绍了如何将文档嵌入并存储在向量数据库中以进行检索。Qdrant技能帮助AI代理理解向量搜索的工程决策,解决内存和延迟问题。Cosmos平台通过多种功能组合实现高效搜索体验,并提供诊断决策树,提升搜索质量和性能。
Meilisearch对LMDB进行了补丁,支持未提交写入的嵌套读取事务,提升了向量存储速度和索引时间。通过优化数据结构和减少全扫描,处理速度提高至每秒20个嵌入,显著提升搜索性能。新特性无需API更改,自2025年12月起在生产中使用。
MongoDB Atlas Search和Atlas Vector Search现已支持视图功能,用户可以创建视图进行部分索引和文档转换,以提升搜索性能和降低成本。这一功能有助于在数据量增长时精细控制索引。
优化数据索引和布局可以显著降低检索时间,提高存储效率。Uber Eats通过地理分片和并行查询处理提升了搜索性能和用户体验。文章探讨了数据检索和排名技术,强调在快速变化环境中持续优化系统的重要性。
文章讨论了如何将Postgres迁移至OpenSearch以应对日益增长的搜索需求。尽管Postgres的全文搜索最初能满足需求,但随着文章数量的增加,性能下降,尤其在复杂查询和分页时。最终选择OpenSearch作为专用搜索引擎,同时保留Postgres作为数据源,以确保数据完整性。通过分离读写路径和优化资源配置,系统实现了快速灵活的搜索性能。
在开发物业管理系统时,发现MongoDB文本搜索对带连字符的搜索词处理不当,如查询“office unit -7”时未返回包含“7”的单位。MongoDB将连字符视为否定运算符,导致搜索结果不准确。可通过正则表达式精确匹配或用双引号转义特殊字符来解决此问题。选择合适的搜索方法和索引是提升搜索性能的关键。
MongoDB Atlas 现在支持通过视图转换文档和过滤集合以优化搜索性能。通过定义聚合管道,开发者可以简化索引管理并定制数据表示,从而提高搜索效率,构建精准的搜索功能。
文章探讨了数据摄取瓶颈、搜索性能优化和实时推荐的技术挑战与解决方案。通过分布式ETL管道、混合索引策略和机器学习服务架构,显著提升了查询性能和推荐效率,降低了延迟与成本。
本研究提出了一种新聚合技术,解决了高质量特征向量在全幻灯片图像中的分配问题,显著提升了多种组织样本的搜索性能,推动了数字病理学的发展。
VideoRAG是一种新型检索系统,结合视频理解与大型语言模型,能够高效检索相关视频内容,提高响应准确性和视频搜索性能。
Elastic 8.17发布了Elasticsearch logsdb索引模式、Elastic Rerank模型和ES|QL全文搜索功能,显著提升了存储效率和搜索性能。logsdb模式可减少65%的日志数据存储,Rerank模型增强了语义搜索,ES|QL支持更快速的日志查询。这些更新优化了用户体验,适用于电商等多种场景。
Elastic 8.17 版正式发布,提升存储效率和搜索性能。新功能包括 Elasticsearch logsdb 索引模式,减少日志数据存储占用高达 65%;Elastic Rerank 模型提供语义重排序;ES|QL 的全文本搜索功能显著提升查询速度。此外,推出 SAML 单点登录,简化企业访问管理。
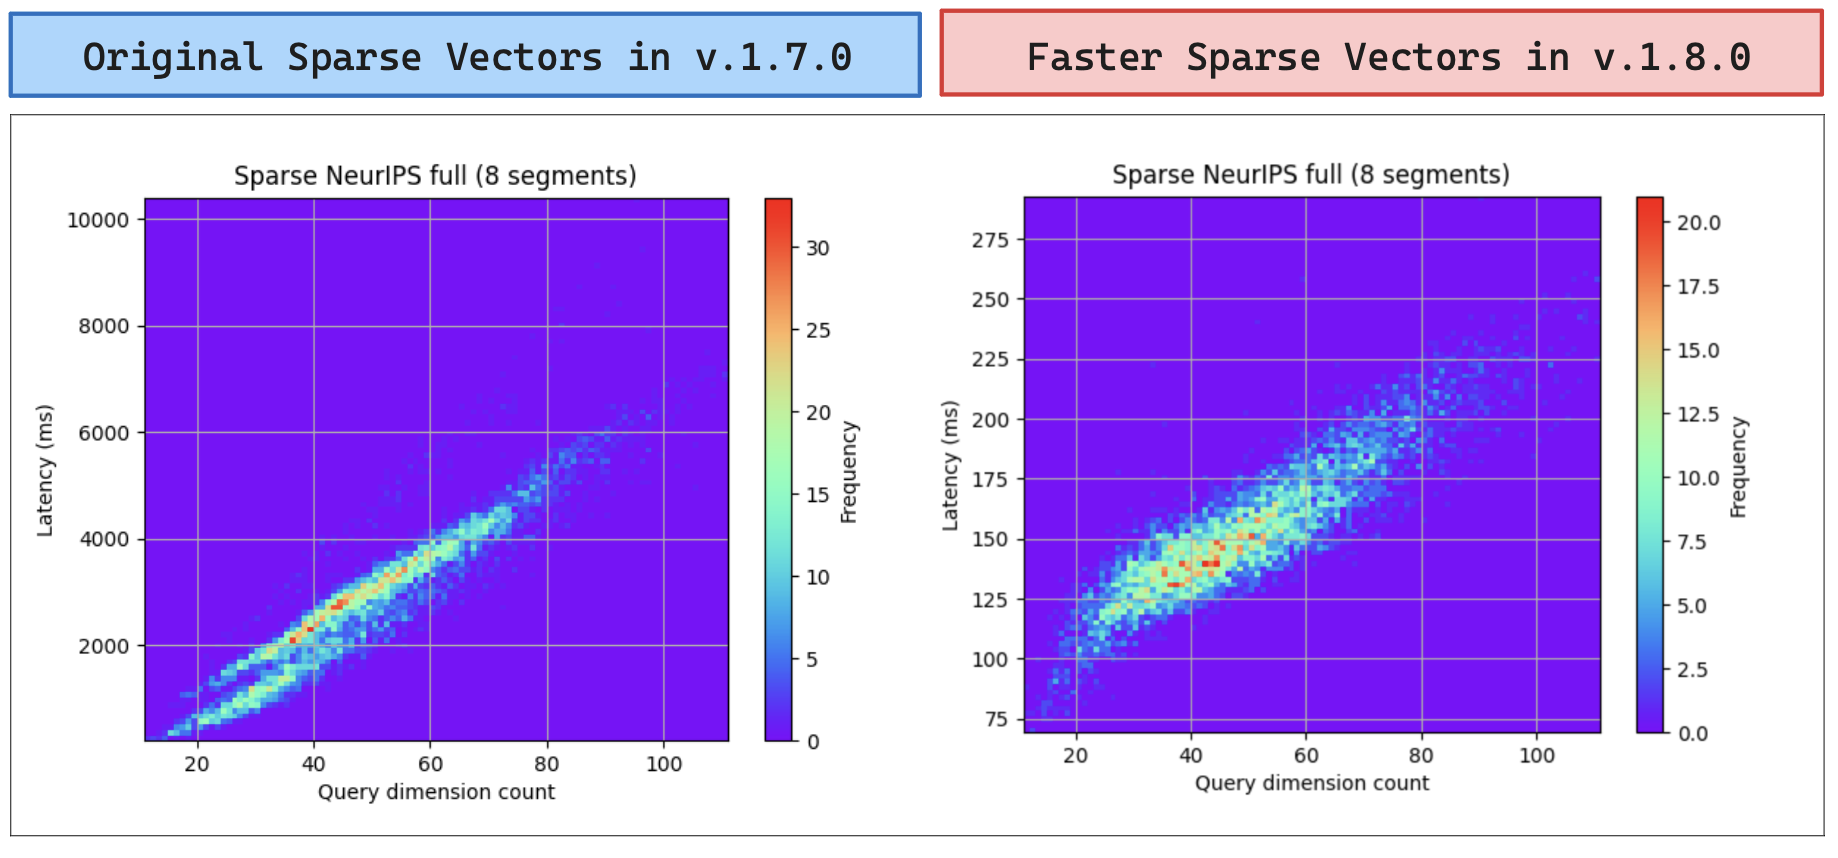
Qdrant 1.8.0版本发布,优化了搜索性能,稀疏向量搜索速度提升至16倍,支持CPU资源管理以加快索引速度。新版本改进了文本数据索引,减少内存使用,并新增按负载排序和日期时间支持等功能,提升用户体验以满足快速增长的查询需求。
本文介绍了Elasticsearch中的Mapping参数,包括分词器、normalizer、boost、coerce和copy_to等配置。通过示例说明如何设置字段类型、权重、数据清理和合并字段。还讨论了动态属性、日期检测、字段索引、聚合和排序等功能,强调合理配置Mapping对搜索性能的重要性。
微软发布了Windows 11 Canary 金丝雀测试版,版本为Build 25336,更新包括改进设置中的搜索性能、为多显卡用户提供设置主显卡功能、在设置的多任务处理中删除显示所有选项卡。金丝雀频道是预览平台更改的地方,这些更改在发布给客户之前需要更长的准备时间,可能包含重大问题,用户使用金丝雀版要有心理准备。
在大规模数据摄取中,处理数百万或数十亿条记录时,效率至关重要。Qdrant提供多种摄取方法:对于小于10万条数据,单线程批量更新效果良好;对于100万条以上,推荐使用upload_collection方法以优化内存和搜索性能。合理配置和流式上传可在64GB内存的机器上高效处理4亿条数据,保持低成本和快速搜索性能。
本文介绍了构建混合搜索引擎的项目,结合稠密和稀疏向量,通过互惠排名融合(RRF)实现更优搜索结果。项目包括设置混合集合、实现稠密和稀疏编码、执行混合搜索及比较不同搜索方法的性能。成功标准是能够有效执行混合搜索并展示其优于单一向量方法的案例。
本文介绍了一个文档搜索引擎的项目,旨在构建一个理解语义和关键词的高级搜索系统。该系统实现混合检索、多向量重排序和生产质量评估,以确保用户快速找到相关文档。项目内容包括文档解析、向量嵌入、搜索管道设计及结果格式化,目标是实现高效的搜索性能和用户友好的输出。
MUVERA是FastEmbed的后处理模块,旨在优化多向量嵌入以提升搜索性能。它将可变长度的向量序列转换为固定维度的单向量表示,结合快速检索与高精度重排序,适用于大规模文档集合。尽管需要更多存储,但显著提高了检索速度。MUVERA与Qdrant结合使用,支持高效的多阶段查询,适合生产系统。
完成下面两步后,将自动完成登录并继续当前操作。