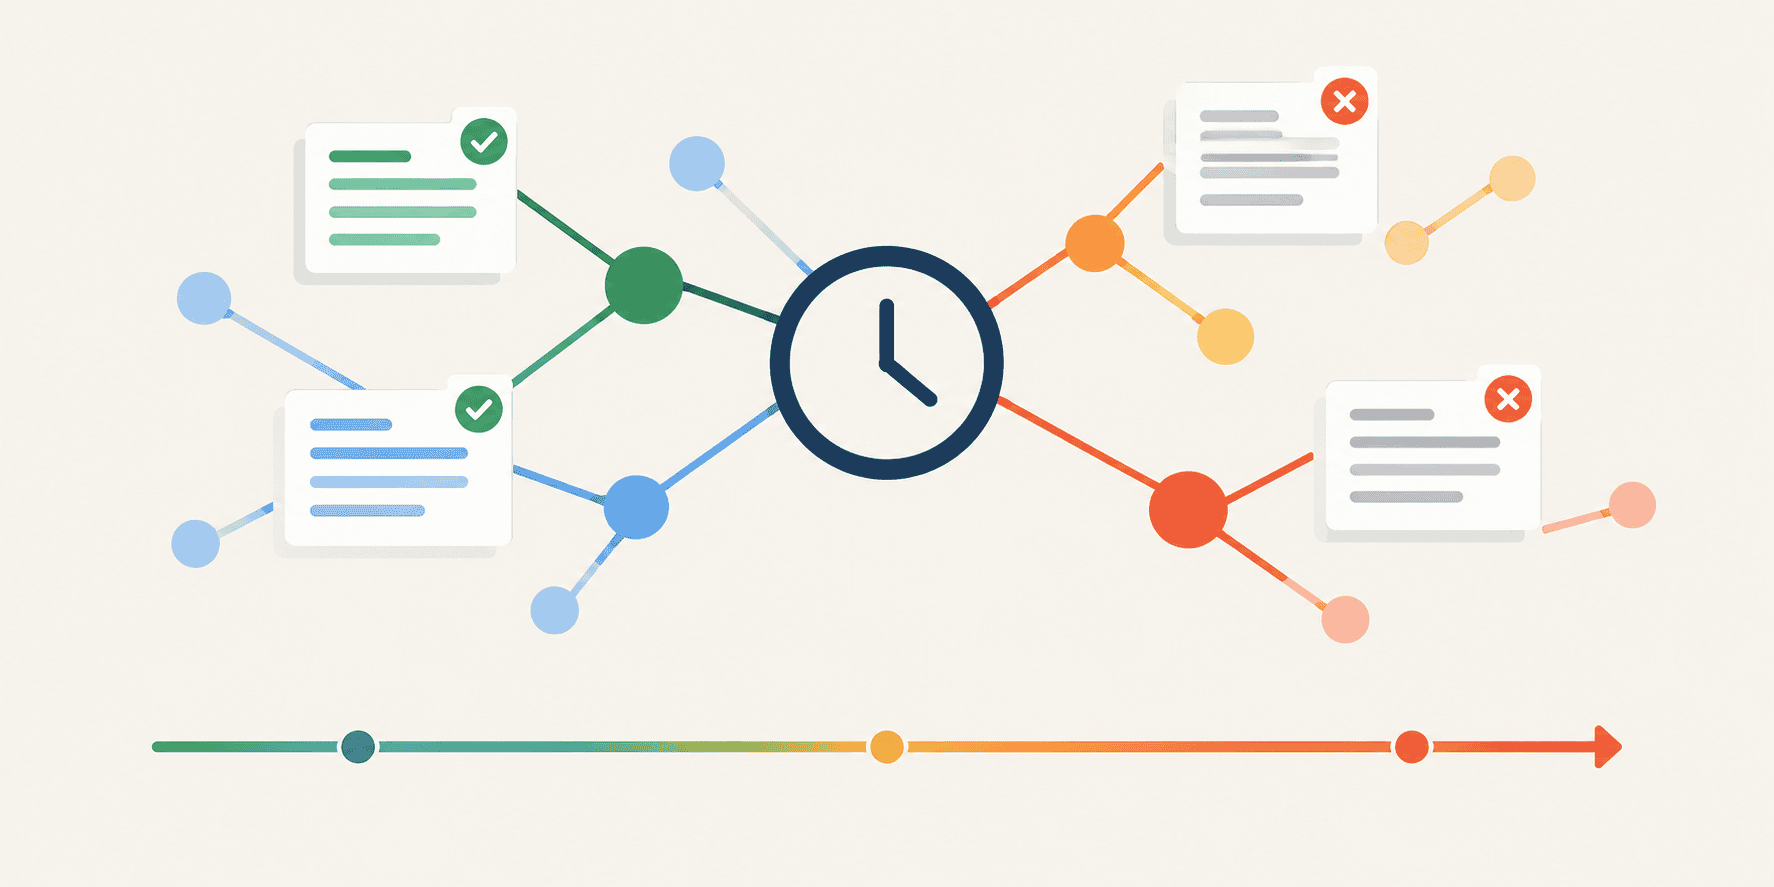
文章介绍为Graph-RAG加入轻量级时间推理层:将传统主谓宾三元组扩展为带时间戳的四元组并存入时间图,用指数衰减计算事实新鲜度权重,按查询日期对冲突事实排序。示例追踪公司CEO变动,展示不同查询日期下答案权重变化,并建议调整半衰期参数。最后提出将时间图接入三层Graph-RAG检索流程,只把最高权重事实传入提示,减少模型猜测。
本文介绍了NarrativeTrack,这是评估多模态大语言模型(MLLMs)叙事理解的首个基准。该基准通过细致的实体中心推理,分析视频中的动态叙事。研究发现,现有模型在视觉转变和时间动态中难以稳定追踪实体,揭示了感知基础与时间推理之间的权衡。NarrativeTrack为提升MLLMs的时间基础叙事理解提供了系统框架。
本文探讨了视频理解基准的局限性,指出现有评估方法未能有效区分模型的时间推理能力。提出了VBenchComp,一个自动化流程,将问题分类为可回答、语义和时间问题,以便更细致地评估视频大语言模型的能力。分析表明传统评分掩盖了模型的弱点,并为未来基准设计提供了建议。
本研究提出了TISER框架,旨在提升大型语言模型在时间推理任务中的表现。通过构建时间线和自我反思,显著改善了事件顺序、持续时间和时间关系的处理能力。实验结果表明,TISER在多个基准测试中表现优异,帮助较小的开源模型在复杂时间推理任务中超越大型模型。
该研究提出视频旋转位置编码(VRoPE),旨在克服视频大型语言模型中旋转位置编码(RoPE)在处理复杂时空结构方面的局限性。VRoPE在视频理解、时间推理和检索任务中优于现有RoPE变体,展现出较大潜力。
本研究提出了一项新评估任务和TReMu框架,旨在提升大型语言模型在多会话对话中的时间推理能力,显著改善其性能,填补研究空白。
本研究提出了一种新方法,结合大语言模型与视觉语言模型,解决视频异常检测中的可解释性和时间推理挑战,提升检测能力,推动少样本和零样本检测应用。
本文介绍了DateLogicQA基准,包含190个问题,涉及多种日期格式和时间推理类型。研究分析了大型语言模型在时间推理中的表现差距,并提出了语义完整性指标来评估分词质量,同时探讨了代表性偏差和逻辑偏差。
本研究探讨了资源丰富语言与低资源语言之间的标注资源差异,提出了mTEMPREASON数据集和跨语言时间敏感语义对齐(CLITSSA)方法,显著提升了低资源语言的时间推理能力。实验结果显示,CLiTSSA在罗马尼亚语、德语和法语的时间任务中优于现有基准。
本文介绍了多个新的视频理解基准,包括AGQA、MVBench、MMWorld和TemporalBench,旨在评估多模态语言模型(MLLMs)在视频分析中的表现。研究发现现有模型在时间推理和长视频理解方面存在显著不足,并提出了改进方法和新框架以提升模型性能。
本文介绍了大型语言模型(LLMs)的评估方法和基准测试,包括TemporalWiki基准、动态基准和用户需求导向的评估框架。研究探讨了LLMs在知识保持、时间推理和偏见方面的挑战,并提出了改进评估的建议,以提升其可靠性和实际应用效果。
该论文提出了一种新的视频-语言模型,旨在提升视频理解能力。通过去耦合的空间-时间编码器和新的预训练目标,该模型在视频问答任务中表现优越。研究引入了多个基准测试,如InfiniBench和E.T.基准,以评估长视频理解的挑战,并提出了TVBench以增强时间推理能力。实验结果表明,该模型在多项任务中显著优于现有方法。
本文介绍了一种名为TempoQR的时间问答方法,显著提升了复杂时间问题的回答能力。研究提出了多个框架和数据集,以增强大型语言模型在时间推理方面的性能,强调了时间信息在问答系统中的重要性。
本研究探讨了音频问题回答(AQA)任务中的时间推理能力,提出了多种模型以提升性能,包括MALiMo和INDENT。研究表明,利用多模态知识和新数据集可以显著改善音频场景理解和问题定位能力。此外,GAMA模型在音频理解任务中表现优异,解决了文本到音频检索中的时间顺序理解问题。
本文介绍了时间平衡逻辑(TEL)的研究进展,探讨了线性时态逻辑(LTL)在机器人本地化和时间推理中的应用。研究提出了多种算法和理论,旨在提升时间推理能力,并开发了Timo模型,在时间推理任务中表现优异,准确度超过同类模型。
本文探讨了大型语言模型(LLMs)在时间推理和表格推理任务中的表现,指出其在时间理解方面的局限性。研究提出了新模型TempGraph-LLM和TimeLlaMA,以提升推理能力,并通过实验验证了这些模型在处理复杂表格数据时的优势与不足。
本研究介绍了UnSeenTimeQA,一个新的时间敏感问答基准,旨在评估大型语言模型在真实时间推理中的能力。研究发现,现有模型在复杂时间推理场景中表现不佳,并提出了新的时间上下文感知问答框架TCQA,显著提升了模型性能。此外,研究探讨了如何构建时间敏感问答数据集,以增强长文档QA系统的时间推理能力。
本文研究了大型语言模型在时间推理任务中的性能,提出了STG-LLM方法以解决序列文本与空间-时间数据的不匹配问题,并创建了TimeBench基准来评估模型的时间推理能力。研究表明,当前模型在时间理解方面存在显著不足,尤其在处理复杂问题时表现不佳,强调了改进的必要性。
本文介绍了TimeBench,一个评估大型语言模型(LLMs)时间推理能力的基准。研究表明,当前LLMs在时间推理任务上仍显著落后于人类。通过系统研究和新型学习框架,提出了提升时间推理能力的方法,并开发了表现优异的Timo模型。希望这些研究能促进LLMs在时间推理方面的进步。
本文探讨了大型语言模型(LLMs)在时间推理能力方面的局限性,并提出了多个基准测试(如TimeBench和TRAM)来评估其性能。研究表明,当前模型在时间推理任务上仍显著落后于人类,强调了改进的必要性。通过新方法和数据集,研究旨在提升LLMs的时间理解和推理能力。
完成下面两步后,将自动完成登录并继续当前操作。