小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate

权重衰减和学习率在大语言模型预训练中至关重要。本文从滑动平均的角度探讨如何合理设置这两个参数,以增强模型的记忆能力,避免遗忘早期数据,同时防止欠拟合和权重爆炸。

滑动平均视角下的权重衰减和学习率

科学空间|Scientific Spaces 科学空间|Scientific Spaces · 2025-12-05T05:17:00Z

本文探讨了AdamW优化器中权重RMS的渐近估计,指出其与学习率和权重衰减相关。通过平均场近似,得出权重RMS可预估的结论,强调这一结果的反直觉性。

AdamW的Weight RMS的渐近估计(上)

科学空间|Scientific Spaces 科学空间|Scientific Spaces · 2025-10-01T04:51:00Z

本研究探讨了大型语言模型预训练中的超参数调优,重点分析了学习率和权重衰减的关系,并提出了一种预测最佳权重衰减的新方法,为超参数选择提供理论支持。

电力线:大型语言模型预训练中的权重衰减和批处理大小的缩放法则

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-19T00:00:00Z
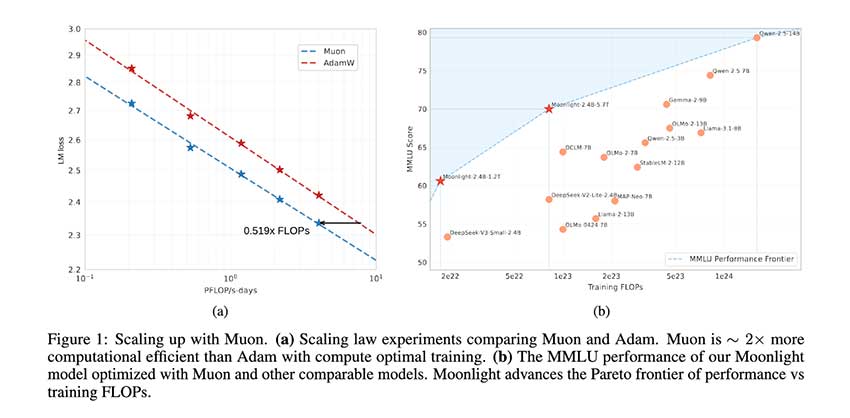
Moonshot AI 推出 Muon 和 Moonlight:利用高效训练技术优化大规模语言模型

Muon优化器通过权重衰减和一致的RMS更新,提高了大规模语言模型的稳定性和效率,降低了计算成本。Moonlight模型表现优异,超越同类,支持多语言处理,推动高效训练方法的探索。

Moonshot AI 推出 Muon 和 Moonlight:利用高效训练技术优化大规模语言模型

实时互动网 实时互动网 · 2025-02-26T02:48:03Z

月之暗面团队改进了OpenAI的Muon优化器,使算力需求降低48%。新版本适用于更大模型,并验证了在分布式训练中的可行性。改进包括引入权重衰减和调整参数更新尺度,提升了训练效率和性能。

月之暗面开源改进版Muon优化器,算力需求比AdamW锐减48%,DeepSeek也适用

量子位 量子位 · 2025-02-23T09:31:33Z
第27天:大型语言模型(LLMs)的正则化技术

随着大型语言模型(LLMs)复杂性的增加,正则化技术变得尤为重要。正则化可以防止过拟合,提高模型对新数据的泛化能力。常见的正则化方法包括:1. Dropout(随机丢弃神经元);2. 权重衰减(惩罚大权重);3. 提前停止(监控验证性能);4. 层归一化(稳定训练);5. 数据增强(丰富训练数据)。选择合适的正则化策略需考虑模型规模和数据集特点。

第27天:大型语言模型(LLMs)的正则化技术

DEV Community DEV Community · 2024-11-06T12:56:12Z

本研究探讨了权重衰减和L2正则化对深度神经网络训练的影响,尤其是在注意力层中。结果显示,权重衰减显著降低参数矩阵的秩,可能导致语言模型性能下降。

权重衰减诱导低秩注意力层

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-10-31T00:00:00Z

本文探讨了神经网络中的损失可塑性问题及神经坍塌现象。研究表明,层归一化和权重衰减技术能够有效维持网络的可塑性,提升学习算法的稳健性。同时,神经坍塌现象会影响模型的泛化能力和优化能力,提出的正则化方法可以缓解可塑性丧失。

我们是否可以通过神经崩溃来理解可塑性?

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-04-03T00:00:00Z

本文讨论了权重衰减算法Weight Decay的缺点,并介绍了一种名为Scheduled Weight Decay的算法来解决这些问题。Scheduled Weight Decay通过调整权重衰减的强度来抑制梯度范数,改善模型的泛化能力。文章认为Weight Decay的缺点是被忽视的,而Scheduled Weight Decay是一种解决方案,但并非终极答案。

NeurIPS 2023 | 深入探讨 Weight Decay 的前世今生和隐藏缺陷

六虎 六虎 · 2024-04-02T06:52:37Z

该文综述多项研究,探讨神经网络的隐性偏差。批归一化和权重衰减可能促成神经崩溃;深度网络倾向低秩解以提升泛化;稳定秩初始化可加速收敛;图神经网络存在超平滑与秩崩溃,Kronecker积之和可缓解;权重衰减实为改变训练动态。

神经排序崩溃:权重衰减和小的内类变异性带来低秩偏差

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-02-06T00:00:00Z

本研究提出了一种受限参数正则化(CPR)方法,通过对单个参数组的统计度量施加上限,避免了显式的标量系数。CPR能够根据不同参数组实现不同的正则化强度,且在运行时没有明显的开销。实验证明CPR在抑制grokking效果方面表现突出,并且始终与或超过传统权重衰减的性能表现一致。

参数正则化中的新视角:约束方法

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2023-11-15T00:00:00Z

本文研究了使用SGD训练任意宽度的两层神经网络,证明了第一层权重将收敛于真实模型的k维主子空间,使用SGD训练的ReLU NNs可以通过恢复主方向来学习单指标目标,其样本复杂度与d成线性关系。

SGD 在两层神经网络中寻找并调整特征,具有近乎最优的样本复杂度:以 XOR 问题为案例研究

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2023-09-26T00:00:00Z

本文介绍了PyTorch中的一些函数,包括计算模型参数数量和设置权重衰减的函数。同时定义了FocalLoss类,用于实现softmax和sigmoid的焦点损失,适用于多分类任务。

pytorch有用的脚本片段和函数的积累

李文举 李文举 · 2022-05-10T01:20:08Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码