小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
评估整个推理栈——而不仅仅是开源模型基准

公开基准仅反映模型最优表现,无法保证生产环境中的稳定准确。Nebius的Wang建议结合内部基准与真实工作流评估开源模型,并关注整个推理栈,包括缓存命中率、吞吐与并发、P95/P99延迟和首字延迟。模型并非越大越好,应平衡精度与规模,必要时拆分任务或微调小模型。

评估整个推理栈——而不仅仅是开源模型基准

The New Stack The New Stack · 2026-10-20T20:44:17Z
混合,而非调优:在数据受限场景下,双语预训练优于超参数搜索

在数据受限的语言预训练中,比较了超参数调优与双语数据混合两种策略。以阿拉伯语为目标语言、英语为辅助语言,进行了约千次实验,模型规模从150M到1.43B。结果表明,数据混合优于超参数调优,其效果相当于2–3倍的目标语言数据,在下游任务上提升2–13倍,且优势随模型规模增大而增强。建议优先混合高资源语言并调整混合比例。

混合,而非调优:在数据受限场景下,双语预训练优于超参数搜索

Apple Machine Learning Research Apple Machine Learning Research · 2026-10-13T00:00:00Z
谨慎对待缩放法则

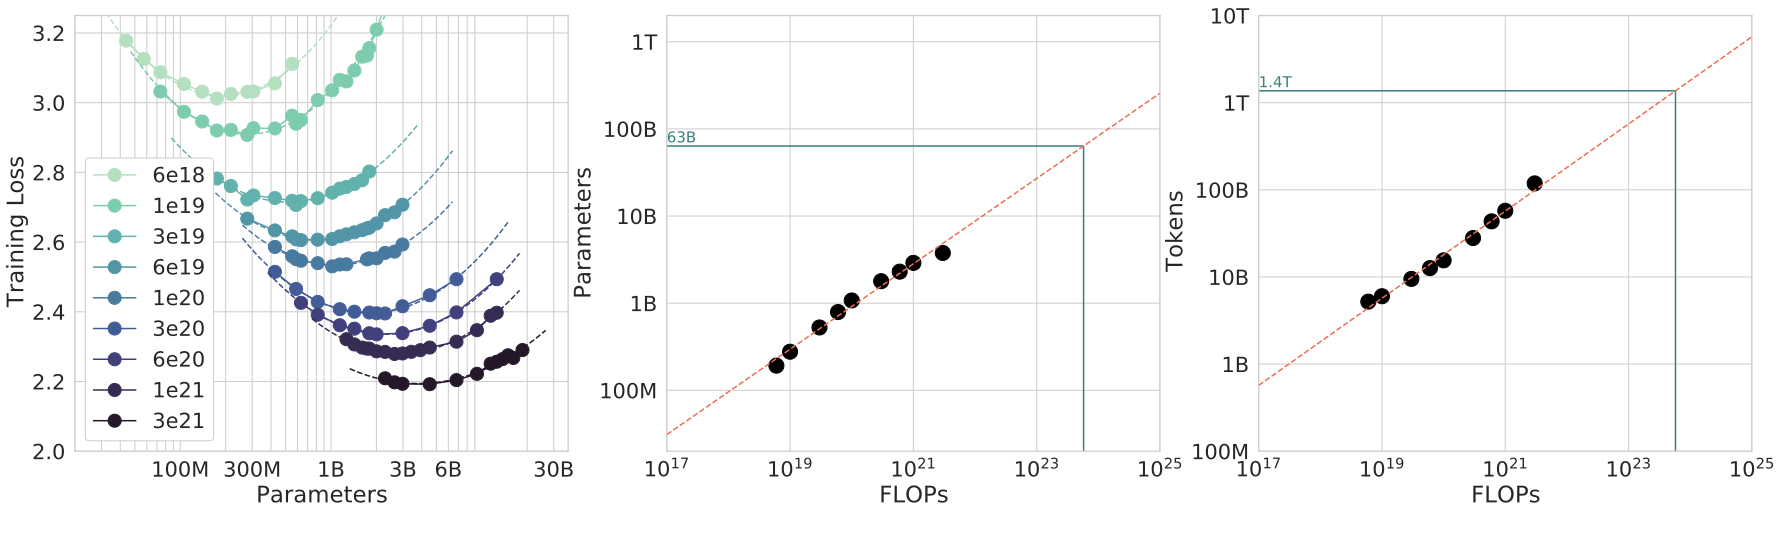
深度学习中的缩放法则表明,训练损失随着模型规模、数据集规模和计算量的增加而降低,遵循幂律关系。这一规律有助于优化计算资源在模型和数据之间的分配。研究显示,模型大小与数据量的最佳比例对性能提升至关重要。Kaplan和Chinchilla的研究结果存在分歧,前者建议模型增长速度应快于数据,后者则认为两者应同步增长。

谨慎对待缩放法则

Lil'Log Lil'Log · 2026-06-24T00:00:00Z
人工智能论文评审:语言模型是无监督的多任务学习者(GPT-2)

GPT-2模型通过在大量文本上训练,仅预测下一个单词,展现出多任务能力,无需特定任务训练。这一方法标志着从监督学习向零-shot学习的转变,使模型能够在不同任务中进行泛化。研究表明,模型规模和数据量的增加有助于提升性能,推动了现代语言模型的发展。

人工智能论文评审:语言模型是无监督的多任务学习者(GPT-2)

freeCodeCamp.org freeCodeCamp.org · 2026-05-11T15:55:27Z
掌握600B+前沿:优化推理云上的大模型部署

随着模型规模的扩大,存储架构优化变得至关重要。超过700GB的模型权重对数据传输速度提出了挑战,导致延迟和成本增加。高性能的NFS和对象存储可以显著提高模型加载速度,减少冷启动时间,提升GPU利用率。通过优化存储和网络,确保GPU高效计算,避免资源浪费。

掌握600B+前沿:优化推理云上的大模型部署

The DigitalOcean Blog The DigitalOcean Blog · 2026-04-21T20:10:14Z

本次作业通过基准测试和性能分析不同规模的模型,研究规模对性能的影响,并建议使用代码自动生成表格以简化报告格式化。

【Triton 教程】triton_language.div_rn

HyperAI超神经 HyperAI超神经 · 2026-03-18T08:58:29Z
Oxygen 9N-LLM生成式推荐训练框架

生成式推荐作为新兴推荐系统,提升了推荐多样性和复杂语义处理能力。京东九数算法团队开发的9N-LLM统一训练引擎,支持多框架和硬件,解决了训练效率和模型规模问题,推动生成式推荐的实际应用。该引擎通过优化样本处理、稀疏参数计算和强化学习流程,提高了训练效率和效果。

Oxygen 9N-LLM生成式推荐训练框架

京东科技开发者 京东科技开发者 · 2026-01-30T10:52:59Z
不同显寸对应的可运行的模型大小 - 蝈蝈俊

在有限显存下,运行大型语言模型需平衡模型规模、量化精度和上下文长度。显存需求受模型参数、上下文缓存和系统开销影响,增加上下文长度会迅速消耗显存。选择合适的量化格式可提升性能。

不同显寸对应的可运行的模型大小 - 蝈蝈俊

蝈蝈俊 蝈蝈俊 · 2025-12-12T08:39:00Z
当预训练数据与目标任务匹配时,语言模型性能提升

本文提出了一种基准目标排名方法(BETR),通过比较预训练文档与基准训练示例的相似性来优化数据选择。BETR在共享空间中嵌入基准示例和预训练文档,利用相似性评分训练轻量级分类器。研究表明,BETR在多个任务上显著提升性能,且更大的模型需要更少的过滤,强调数据选择策略需适应模型规模。

当预训练数据与目标任务匹配时,语言模型性能提升

Apple Machine Learning Research Apple Machine Learning Research · 2025-07-18T00:00:00Z

尺度定律是OpenAI于2020年提出的原则,揭示了模型规模、数据量与计算资源之间的关系,对AI研发和产业应用产生影响。报告分析了其对大模型发展的影响、涌现能力及局限性,强调数据质量和训练方法的重要性,指出尽管尺度定律是实现通用人工智能的关键,但仍需探索更广泛的解决方案。

Scaling Laws尺度定律科普报告|量子位智库

量子位 量子位 · 2025-06-17T09:07:07Z

尺度定律是OpenAI于2020年提出的原则,揭示了模型规模、数据量与计算资源的关系,影响AI研发与产业发展。量子位智库的报告分析了尺度定律的影响、涌现能力及局限性,指出大模型竞争加剧,企业需平衡模型规模与效率,推动AI硬件与云计算需求增长。

Scaling Laws尺度定律科普报告|量子位智库

量子位 量子位 · 2025-06-17T08:05:55Z

本研究探讨大型语言模型(LLM)在计算最优状态下的泛化能力,提出新的不等式,发现模型规模越大,泛化间隙越小,为理解其泛化能力提供新见解。

计算最优的语言模型在规模上具有更好的可泛化性

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-21T00:00:00Z

本研究提出LLaVA-MORE,探讨多模态大型语言模型(MLLMs)在模型规模、架构与性能之间的权衡。通过统一训练协议,公平比较不同视觉骨干和语言模型,评估多模态推理、生成与指令遵循的关系,为设计更有效的MLLMs提供见解,并建立可重复的评估框架。

LLaVA-MORE: A Comparative Study of LLMs and Visual Backbones for Enhanced Visual Instruction Tuning

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-19T00:00:00Z
百万美金炼出「调参秘籍」!阶跃星辰开源LLM最优超参工具

阶跃星辰研究团队训练了3700个大语言模型,发现超参数优化的新规律(Step Law),并开源相关工具和数据。研究表明,最优学习率和批量大小与模型和数据规模呈幂律关系,适用性广泛。

百万美金炼出「调参秘籍」!阶跃星辰开源LLM最优超参工具

机器之心 机器之心 · 2025-03-13T02:23:32Z
大模型是否有自知之明?新研究发现LLM可以知晓自己的知识范围

研究发现,大型语言模型(LLM)具备知识意识,能够评估自身对某一主题的掌握程度。模型规模越大,性能越好,但数据集过大可能导致性能下降。不同架构的模型表现差异明显,Flan-T5在简化设置下表现优异,但在标准设置中效果不佳。总体而言,LLM在足够规模下展现出知识意识。

大模型是否有自知之明?新研究发现LLM可以知晓自己的知识范围

机器之心 机器之心 · 2025-03-01T13:04:50Z
揭示:语言人工智能技能如何真正增长 - 新研究组任务以预测改进

本研究总结探讨了大型语言模型(LLM)随着规模增长而提升性能的情况。通过聚类分析模型行为,研究关注模型大小与下游能力的关系,旨在预测实际性能和扩展模式。

揭示:语言人工智能技能如何真正增长 - 新研究组任务以预测改进

DEV Community DEV Community · 2025-02-27T09:51:22Z

本研究探讨了在下一个标记预测预训练的LLM中,多标记预测(MTP)的能力。结果表明,MTP性能受数据依赖影响,并随着模型规模增大而改善。尽管MTP头与主干联合训练能提升性能,但仍存在隐藏层专门化问题,需进一步研究。

关于高效LLM推理的多标记预测

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-13T00:00:00Z

本文探讨了图神经网络(GNNs)在降低能耗、缩减模型规模和保持准确性方面的应用。提出的四元数信息传递神经网络(QMPNN)框架通过四元数空间计算节点表示,显著减少可训练参数数量,提高模型训练效率。

Quaternion Graph Neural Network

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-10T00:00:00Z
研究表明,扩大词汇量使人工智能语言模型更智能、更快速

研究表明,扩大词汇量能提升语言模型性能。采用“过度分词”策略优于传统方法,且随着模型规模增大,词汇扩展的好处也随之增加。该方法提高了20%的训练速度,且质量保持不变,适用于多种语言和任务。

研究表明,扩大词汇量使人工智能语言模型更智能、更快速

DEV Community DEV Community · 2025-02-03T09:03:33Z

本研究提出了一种新机制,将线性自注意力与GLU前馈层结合,使变换器在多项式核回归任务中有效进行梯度下降,强调模型规模对二次上下文学习的重要性。

Context Learning for Polynomial Kernel Regression in Transformers with GLU Layers

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-30T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码