纯文本连续批处理引擎难以支撑多模态负载:VLM的ViT编码脉冲会阻塞Decode,视频DiT需平方级双向注意力且末端3D VAE解码易OOM,全双工语音受80ms帧节拍与插话回滚约束。文章提出VLM走EPD分离加视觉嵌入缓存,视频DiT用CFG×USP/PipeFusion并行、TeaCache与步数蒸馏加速、BF16分块解码,语音用Moshi或Thinker-Talker原生流式,并强调小图直通、头数整除、缓存与蒸馏互斥等落地边界。
破晓智能发布全身全模态数据采集系统SeePhys Hub,由四目头环、腕部手环、腰腿追踪器和触觉手套组成,在轻量Ego数据基础上补回全身运动与触觉信息,同步精度达0.5毫秒。团队计划2027年推出全模态世界模型,优先落地工业、餐饮零售场景,暂不造机器人本体。
研究团队首次从头预训练三模态掩码扩散模型,统一处理文本、图文和音频文本数据,系统分析多模态缩放规律、模态混合比例、噪声调度和批大小影响,提出基于随机微分方程的重参数化方法解耦物理与逻辑批大小,在30亿参数、6.4万亿token规模上于文本生成、文生图和文生语音任务中表现优异。
亿邦动力将于2026年11月20日在北京举办第八届产业互联网年会暨首届产业智能体大会,主题为“AI与出海带来的模态进化”。会议聚焦产业智能体落地、AI供应链重构、数据要素与Token经济、产业出海新生态等议题,并将发布年度发展报告、千峰奖案例集及标杆企业视频集。
阿里云栖大会发布全模态模型矩阵,涵盖千问基座、图像、视频、语音、音乐及世界模型。导演陆川借助AI仅用5天复原明代爆炸场景,准确率超95%。阿里判断三年内将出现原生全模态统一生成模型,AI正从单项生成走向理解完整叙事、协同完成复杂任务。
2026云栖大会上,阿里公布大模型进展:Qwen3.8-Max在编程与办公领域表现强劲,Qwen4已投入训练,未来参数将扩至5至10万亿。多模态方面,Qwen-Image-3.1、Qwen-Audio-3.1、Wan3.0等均居全球前列。阿里还公布RSI自我进化技术,模型可零人工干预自主迭代。Qwen系列全面开源,下载量超30亿次,成为全球AI开源社区基座模型。
智象未来发布具身世界模型HiDream-O1-Embodied,强化机器人物理感知与动态预判,在RoboColiseum扰动适应榜单登顶。模型通过全模态底座、多视角融合及非理想条件训练提升鲁棒性,并采用“真实基座+生成增强”数据策略,与交互式世界模型互补,构建统一世界模型基座。
智象未来CEO梅涛在世界机器人大会论坛上演讲,提出高IQ不等于全能,强调世界模型对具身智能的重要性。公司发布原生全模态交互式世界模型HiDream-O1-World,支持多模态输入和长时程时空一致性,应用于AI影游、仿真和3D生成,并构建“数据—认知—行动—反馈”闭环飞轮,推动Physical AI商业化。
MiniCPM推出具身智能模型系列,包括15亿参数的机器人操作模型和0.9B参数的目标跟踪模型,实现端到端映射与实时跟踪。HyperAI官网更新了9个数据集、8个教程等资源,涵盖数学推理、视觉推理等领域,并精选社区文章和百科词条。
本文介绍如何使用HTML的<dialog>标签和popover属性创建无障碍弹窗和模态框,无需复杂框架。通过command和commandfor属性或JavaScript的showModal()方法实现模态框,show()方法用于非模态对话框。文章还涵盖定位技巧、::backdrop样式定制,并提醒避免直接使用Flex/Grid布局,以及处理背景滚动问题。
Meta AI提出Omni-Decision系统,通过显式证据状态管理(含确认证据、冲突、依赖关系、开放需求)提升多模态问答的可观测性。在OmniGAIA和WorldSense基准上分别达45.6%和58.3%准确率,显著优于基线。该方法无需训练,可即插即用,增强Agent可解释性与调试能力。
该研究聚焦于文本到声音视频生成(T2SV),旨在从文本生成同步音频的视频。为解决文本条件瓶颈和跨模态特征交互机制不明确的问题,提出了交叉参考重写器(CRR)框架,通过提取语义锚点和生成解耦的字幕对,消除模态干扰,缩小训练与推理之间的差距。
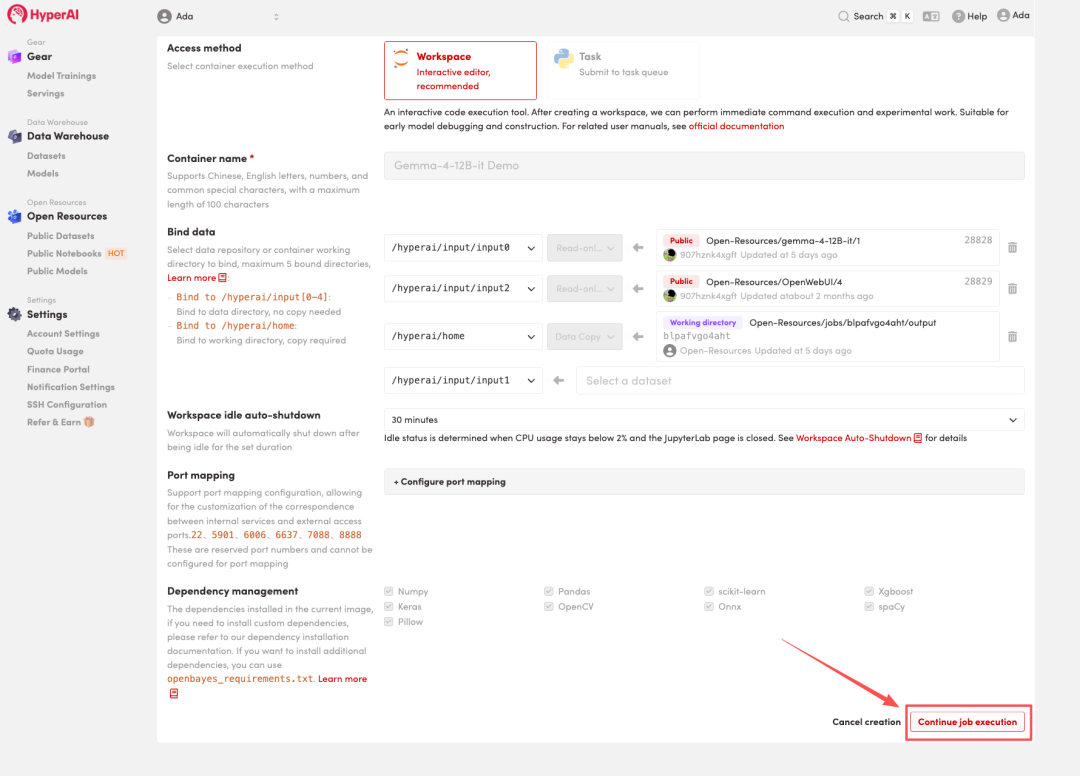
Google DeepMind 发布了新款多模态模型 Gemma 4 12B,参数为120亿,但在多项测试中表现接近260亿参数的模型。其无编码器架构显著降低了推理延迟和内存占用,支持音频输入,并可在普通笔记本上运行,降低了部署成本,为开发者提供了接近顶级性能的选择。
斑马智能在高通峰会上推出全模态端侧大模型AutoOmni,具备低延迟、高精准和保隐私特性,响应时间小于500毫秒。该模型提升了自然交互度和服务链接成功率。斑马智能与高通合作,已与69家车企合作,落地超1000万辆智能汽车。
Agnes AI宣布无限期免费开放全模态API,涵盖文本、图像和视频,简化开发者工作流程。这一举措在AI行业引发关注,尤其在Token成本高企的背景下,减轻了开发者的经济压力。Agnes AI的模型在国际榜单上表现优异,免费政策可能促使其他实验室调整定价策略,推动AI能力基础设施化发展。
Agnes AI正式向全球开发者免费开放文本、图片和视频API,旨在降低使用门槛,促进创作与开发。其模型能够生成高质量的交互稿、图像和视频,支持多种应用场景,简化操作以推动AI技术的实际应用。
文章介绍了如何在Chat SDK中暂停和恢复工作流运行。通过创建工作流Webhook并将其URL传递给按钮的callbackUrl属性,可以实现状态报告请求的审批卡功能。用户可以通过按钮批准、发送或取消请求,相关数据会发送到指定的端点。
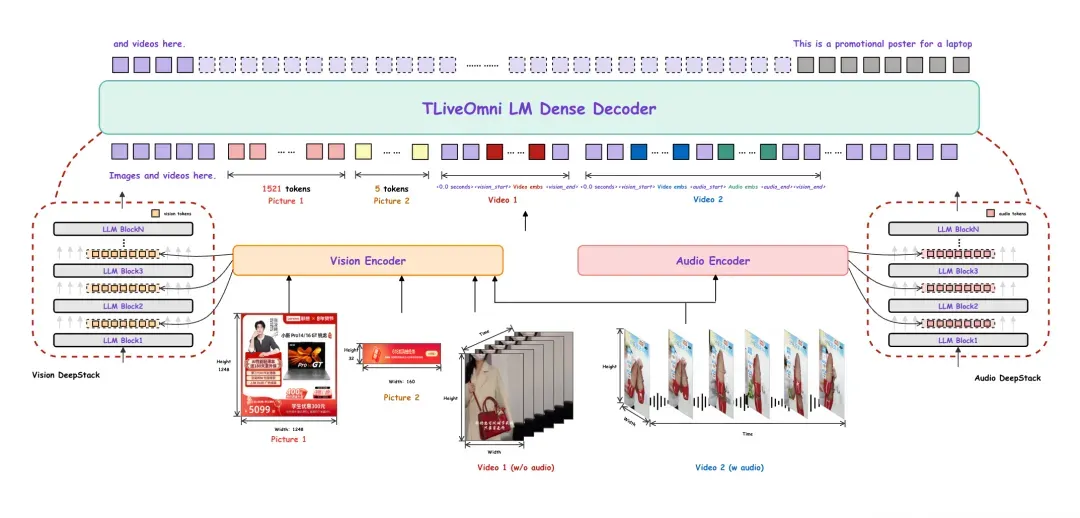
本文介绍了电商直播场景下的全模态理解大模型TLiveOmni在vLLM框架下的推理部署与量化优化。通过自定义插件和修复多模态Token排布,解决了vLLM对Omni模型支持不足的问题。采用SmoothQuant与GPTQ的复合量化方案,构建了5000条高质量数据的校准集,确保模型效果。最终在H20与RTX 4090上测试,推理加速达2.5至3.5倍,精度损失控制在1.5%以内。
戴盟机器人发布了全球最大规模的全模态物理世界数据集Daimon-Infinity,涵盖触觉、视觉等多维信息,计划形成数百万小时的数据。该数据集将用于真实场景的物理交互,推动具身智能的发展,并已开源10000小时高质量数据,构建了外发式数据采集网络,形成完整的数据处理闭环。
智象未来(HiDream.ai)近日完成超5亿元融资,资金将用于研发下一代全模态世界模型及市场拓展。公司在多模态生成式AI领域表现突出,已覆盖3000万用户和4万企业客户,推出多款创新产品,推动AI技术商业化。
完成下面两步后,将自动完成登录并继续当前操作。